Habr AI explica por que os LLMs não calculam, não aprendem na conversa e dependem de ferramentas
O Habr AI desmonta os dois principais mitos sobre os LLMs: eles não aprendem diretamente no chat e não conseguem fazer tudo sozinhos. O modelo de linguagem é forte em texto, mas, para cálculos precisos, dados atualizados, memória e ações, precisa de RAG, function calling e um orquestrador. É dessa combinação que surgem os agentes de IA, os copilots e os gêmeos digitais.
Processado por IA de Habr AI; editado por Hamidun News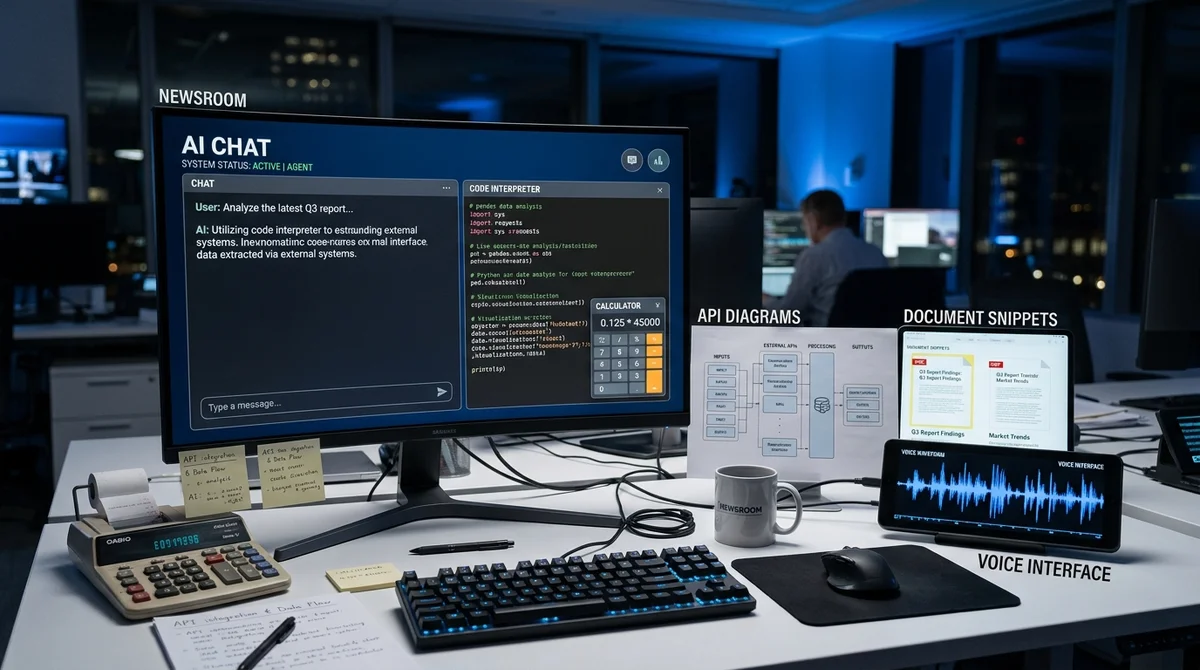
Um artigo do Habr AI examina o mito popular de que o chatbot moderno já é, por si só, uma inteligência universal. A tese central do autor é simples: um LLM básico, por natureza, só sabe trabalhar com texto: recebe uma solicitação em texto e gera uma resposta em texto. Todo o resto, o que o usuário percebe como "habilidades mágicas" do modelo, costuma vir de ferramentas externas, integrações e orquestração. Por isso, as mesmas interfaces podem desenhar imagens, buscar na internet e calcular números, embora o modelo de linguagem não se torne, com isso, artista, buscador nem calculadora.
O primeiro equívoco é a sensação de que o LLM "faz tudo". Se você pede que ele crie uma imagem, ele monta uma solicitação para um modelo de geração separado. Se você fala com ele por voz, reconhecimento de fala e síntese de voz entram na cadeia.
Se é preciso um cálculo exato, o resultado confiável quase sempre só aparece depois de chamar um interpretador de código ou outra ferramenta de cálculo. Sem esses complementos, o LLM se apoia na reprodução probabilística de padrões do treinamento: pode resolver corretamente um exemplo simples, mas erra com facilidade em números longos, fórmulas e tarefas de alta precisão. Daí vem um limite prático importante: o ponto forte do modelo não é a matemática em si, mas a descrição textual da tarefa e a escolha da ferramenta adequada.
O segundo mito é que o modelo aprende durante a conversa. O autor lembra que inferência e treinamento são dois processos diferentes. Quando o usuário escreve uma solicitação, o modelo gera tokens em sequência com base em pesos já fixados, e esses pesos não mudam naquele momento.
Portanto, um LLM específico, em uma sessão específica, não "memoriza a lição" nem fica mais inteligente com a correção do usuário. É verdade que os provedores podem usar depois conversas anonimizadas para treinar versões futuras, mas isso é um ciclo de ajuste fino à parte, não uma autoatualização mágica no chat. Daí decorre outra conclusão: a memória sobre o usuário entre conversas normalmente não é treinamento do modelo, e sim contexto salvo que volta a ser inserido na solicitação.
Em seguida, o artigo explica brevemente do que é feito um LLM público. Na base está o transformer, que enxerga todo o contexto disponível de uma vez e constrói a resposta como uma sequência de tokens prováveis, mantendo a coerência geral do texto graças a modelos aprendidos. Por cima atua o RLHF, um ajuste para o formato de assistente, a cortesia, o seguimento de instruções e as restrições de segurança.
Mas o RLHF não transforma o modelo em uma máquina lógica nem corrige as fraquezas fundamentais. Por isso, os modelos de linguagem vão bem em análise de texto, resumo, mudança de estilo, instruções passo a passo, trabalho com formatos como JSON e escolha de ferramentas. São fracos em cálculos exatos, no processamento de tabelas grandes, em manter enormes volumes de dados no contexto e em conhecer o estado atual do mundo depois da data de treinamento.
Somam-se a isso a natureza probabilística da resposta, a sensibilidade à formulação do prompt e o risco de alucinações.
Para tornar o LLM útil em produção, constrói-se uma camada adicional ao redor dele. Para conhecimento estático, usa-se RAG: os documentos são divididos em trechos, a consulta busca os pedaços semanticamente próximos e o modelo recebe apenas o contexto relevante. Para dados dinâmicos e ações, aplica-se function calling: o LLM decide quando recorrer a uma API, um banco de dados, uma calculadora ou uma simulação, enquanto o orquestrador valida as chamadas, adiciona as respostas das ferramentas ao histórico e gerencia todo o ciclo. O mesmo orquestrador cuida da memória do diálogo, dos prompts de sistema, da verificação do formato de saída e do acionamento de subagentes.
Sobre essa base surgem conceitos mais badalados: agentes de IA, funcionários digitais, copilots e gêmeos digitais. Na essência, não é uma mágica à parte, mas combinações de LLM, bases de conhecimento, APIs, automação e motores de cálculo clássicos. Isso significa que discutir "inteligência artificial" sem separar as tecnologias já não basta. Se a empresa precisa de cálculo exato, automação rigorosa ou previsão sobre dados estruturados, só o LLM não é suficiente. Se precisa trabalhar com e-mails, documentos, instruções, busca de conhecimento e uma interface de conversa para um sistema complexo, o LLM de fato dá um grande impulso.
O olhar sóbrio do artigo é útil justamente porque elimina expectativas excessivas: não se deve atribuir superpoderes ao modelo de linguagem, mas também não vale subestimá-lo como interface e coordenador de outras ferramentas.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.