OpenAI, Anthropic e Gemini: como o cache de inferência reduz o custo e a latência dos LLMs
O cache de inferência está se tornando uma otimização básica para serviços baseados em LLM. Ele reduz a latência, elimina cálculos repetidos e corta de forma perceptível os gastos com tokens. A principal regra prática do novo guia é usar primeiro o prefix caching para prompts de sistema longos e estáveis. O semantic caching só deve entrar onde muitos usuários fazem perguntas parecidas com palavras diferentes.
Processado por IA de Machine Learning Mastery; editado por Hamidun News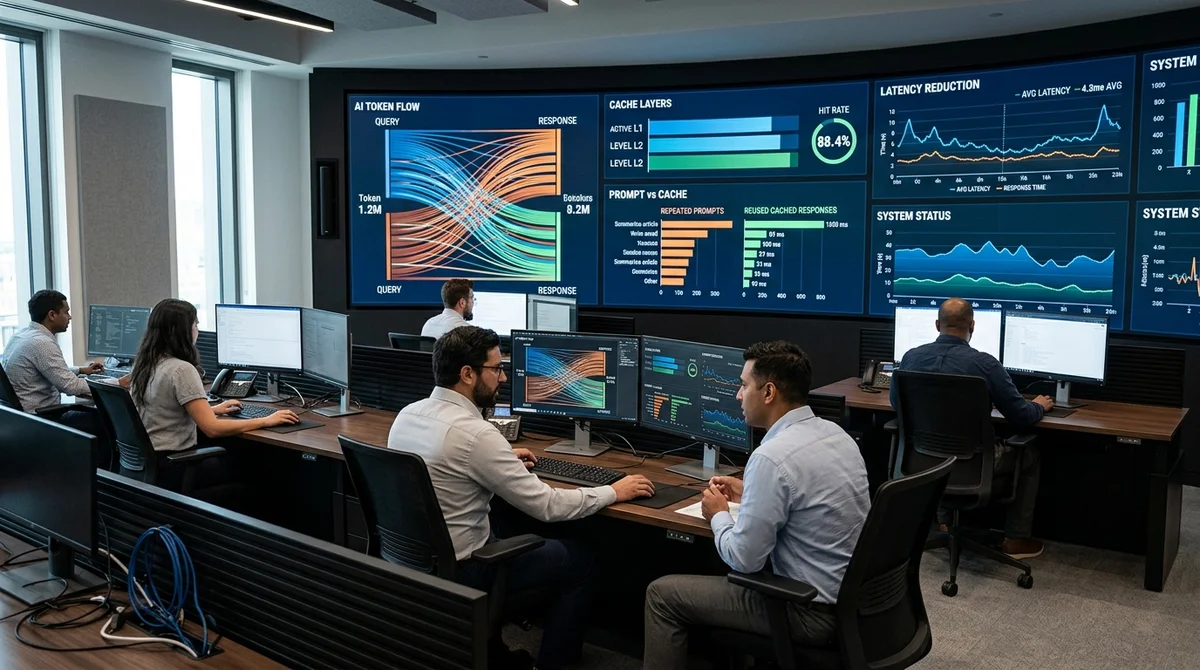
O cache de inferência vem se firmando rapidamente como uma das técnicas mais práticas no trabalho com grandes modelos de linguagem. Ele reduz o custo das requisições, diminui a latência e evita que as mesmas partes do prompt sejam recalculadas a cada chamada. Para serviços em produção com instruções de sistema longas e requisições repetitivas, a técnica deixou de ser um ajuste fino e virou ferramenta básica de economia.
A lógica é a seguinte: o LLM gasta uma parte considerável dos recursos não com a "resposta inteligente", e sim com o reprocessamento de um contexto que já conhece. Se a aplicação usa sempre o mesmo system prompt, documentos compartilhados, exemplos few-shot ou perguntas típicas, o modelo sem cache refaz todo esse caminho a cada vez. O inference caching armazena os resultados desses cálculos e os reaproveita quando a próxima requisição é idêntica ou, ao menos, suficientemente próxima em significado.
Com isso, o sistema consome menos tokens, responde mais rápido ao usuário e escala com mais facilidade sob carga alta. No nível mais básico está o KV cache. Durante a geração, o modelo armazena, token a token, os estados internos de attention — os pares key e value — para não precisar recalculá-los a cada novo passo de decodificação.
Isso acontece automaticamente em praticamente todos os motores de inferência modernos e acelera uma requisição específica. Em geral, o usuário não precisa ativar nada manualmente, mas vale entender que é sobre esse mecanismo que se apoiam as otimizações de nível superior, de efeito mais visível. Em outras palavras, o KV cache é a fundação que elimina trabalho desnecessário dentro de uma única chamada ao modelo.
A camada seguinte é o prefix caching, que os provedores também chamam de prompt caching ou context caching. A ideia é simples: se várias requisições começam da mesma forma — com uma instrução de sistema longa, um bloco de regras, um documento de referência ou um conjunto de exemplos —, esse trecho pode ser processado uma única vez e reaproveitado nas chamadas seguintes. Há, porém, uma condição rígida: o prefixo precisa ser idêntico byte a byte.
Um espaço a mais, uma pontuação alterada, uma data nova no início do prompt ou uma ordem instável de chaves no JSON bastam para derrubar o cache hit. Por isso, o conteúdo estático deve ficar no início, e tudo o que é variável — a mensagem do usuário, o session ID e a data atual — deve ir para o final. É justamente por isso que a técnica já faz parte das APIs dos grandes players: a Anthropic dá aos desenvolvedores controle explícito sobre os blocos armazenados em cache, a OpenAI aplica prefix caching automaticamente em prompts longos e o Google Gemini oferece um mecanismo próprio de armazenamento de contexto.
Em ambientes self-hosted, o vLLM e o SGLang suportam uma lógica semelhante. A terceira camada é o semantic caching. Nesse caso, o sistema não guarda estados intermediários do modelo, e sim pares "pergunta-resposta", e busca correspondências por significado usando embeddings e um banco vetorial.
Se o usuário pergunta praticamente a mesma coisa que já foi perguntada antes, a aplicação pode devolver a resposta pronta sem sequer chamar o LLM. A abordagem é especialmente útil para FAQs, bots de suporte e serviços de grande escala, em que as pessoas formulam as mesmas perguntas com palavras diferentes. Só que a economia tem um preço em infraestrutura adicional: são necessários embeddings, busca vetorial, TTL e um ajuste cuidadoso do limiar de similaridade; caso contrário, cresce o risco de respostas desatualizadas ou irrelevantes.
Por isso, o semantic caching não se justifica em qualquer cenário, e sim principalmente onde há um grande fluxo de requisições semelhantes e alta chance de reaproveitar uma resposta já gerada. O que isso significa na prática? O KV cache já funciona por conta própria, o prefix caching costuma trazer o ganho mais rápido e seguro em produção, e o semantic caching só vale ser adicionado onde a repetição de perguntas de fato compensa o custo da infraestrutura extra.
Para a maioria das equipes, o caminho ideal é este: primeiro estabilizar a estrutura dos prompts, levar todo o contexto compartilhado para o início e alcançar uma alta taxa de cache hit no prefixo; só depois decidir se o cache semântico é necessário. Para aplicações com LLM, este é um caso raro em que uma única disciplina de arquitetura corta custos, acelera o produto e quase não altera a experiência do usuário ao mesmo tempo.
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
- 1 de nov. de 2026Google admite que o AI Mode reduz a receita da Busca; ações caem 15%
- 31 de out. de 2026Autor levou seu roteiro a um júri de IA: o veredito custou 850 mil tokens
- 31 de out. de 2026Anthropic: unir subagentes em um só ciclo fez as tarefas de um cliente rodarem duas vezes mais rápido
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.