Engenheiro da Eltex explica como rodar aprendizado federado em dispositivos edge com 256 MB de memória
O engenheiro da Eltex Alexander Loshkarev publicou um material sobre aprendizado federado em dispositivos edge com menos de 256 MB de memória RAM. O foco não é a teoria de FL, mas o lado prático: como encaixar o modelo, o treinamento local e a troca de atualizações em um perfil de recursos muito restrito. A primeira parte define com clareza o enquadramento do problema para times de embarcados e de ML.
Processado por IA de Habr AI; editado por Hamidun News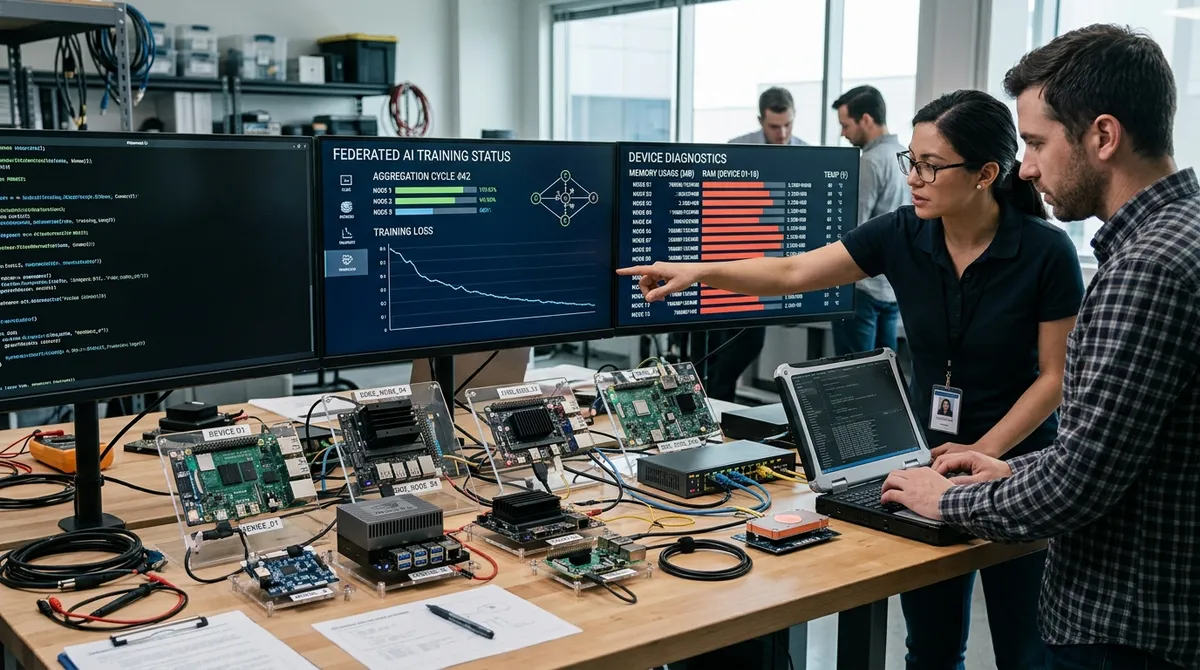
O aprendizado federado costuma ser discutido no contexto de smartphones, carros e grandes redes de IoT, mas na prática a principal barreira muitas vezes é bem mais prosaica: o dispositivo simplesmente não tem memória suficiente. É nisso que se concentra o material do engenheiro da Eltex Alexander Loshkarev, preparado a partir de sua palestra para a AiConf.
O tema parece restrito, mas na verdade toca quase qualquer projeto que precise levar ML da nuvem para a borda da rede e fazê-lo funcionar em hardware com recursos bastante modestos. Trata-se de cenários em que o dispositivo edge tem menos de 256 MB de memória RAM. Para times de servidores, isso parece um limite quase extremo, mas para eletrônica industrial, gateways, equipamentos de telecomunicações, sistemas embarcados e controladores especializados, essa configuração é perfeitamente real.
Nessas condições, a tarefa deixa de ser simplesmente pegar um modelo pronto e carregá-lo na memória. É preciso acomodar ao mesmo tempo o próprio modelo, os dados, os buffers, os processos do sistema e a lógica de troca de atualizações, sem comprometer a estabilidade do dispositivo.
O aprendizado federado é interessante nesse contexto porque permite treinar ou ajustar modelos sem transferir dados brutos de forma centralizada. Os cálculos são feitos localmente, e apenas os parâmetros ou suas alterações são enviados para fora. Essa abordagem ajuda a controlar melhor a privacidade, reduz a dependência de um canal de comunicação constante e torna os cenários edge mais viáveis. Mas há um lado negativo: o próprio cliente local de FL exige memória, processamento e uma organização cuidadosa do pipeline. Quanto mais fraco o dispositivo, mais rigorosa é a economia de cada megabyte.
Pela descrição da primeira parte, o material trata justamente do lado de engenharia desse problema, e não de teoria abstrata. Para os times que levam ML para a periferia, esse é o ponto mais doloroso: o modelo pode ser preciso no laboratório e inútil em produção se não couber na memória ou degradar os demais serviços. Nesses dispositivos, importa não só o tamanho dos pesos, mas também os picos temporários de consumo de memória durante a inferência, a preparação de batches, a serialização das atualizações e a troca pela rede. Mesmo que o modelo pareça compacto de forma estática, o comportamento em tempo de execução pode inviabilizar a implantação.
Nesse sentido, a formulação sobre um dispositivo para o qual 1 GB soa como luxo descreve com bastante precisão a distância entre a stack típica de ML e o mundo embarcado real. Muitas ferramentas e práticas comuns no desenvolvimento para servidores deixam de funcionar aqui sem adaptação. Não dá para aumentar indefinidamente o batch size, manter cópias desnecessárias de tensores nem contar com uma ampla folga de memória do sistema. Qualquer erro na estimativa do perfil de recursos rapidamente vira reinicializações, travamentos ou o abandono da função para a qual o modelo foi implantado.
Também é importante que não se trata apenas de rodar inferência em um dispositivo pequeno, mas especificamente de aprendizado federado. É um modo mais complexo: o sistema precisa receber periodicamente o modelo global, executar passos de treinamento localmente, armazenar estados intermediários e enviar o resultado de volta. Se há pouca memória, é preciso rever literalmente tudo: o tamanho do modelo, o formato de representação dos dados, a frequência de sincronização, a duração das sessões locais e, às vezes, a própria arquitetura do cliente.
Pelo anúncio, o autor coloca a pergunta certa: antes de discutir a qualidade do modelo, é preciso entender se é possível mantê-lo em hardware edge real sem falhas e sem concessões constantes de confiabilidade.
Para o mercado, é um sinal importante. O interesse por IA na borda da rede cresce, mas a implantação real esbarra não em demos bonitas, e sim em limites de memória, energia e estabilidade. Por isso, esse tipo de material é útil não só para engenheiros de ML, mas também para times de backend, embarcados e produto: ele leva a conversa do nível das promessas para o da engenharia de sistemas.
Se a primeira parte define o enquadramento do problema, a principal conclusão já está clara: em ML na borda, vence não o modelo mais badalado, mas aquele que o dispositivo realmente consegue suportar.
Ship AI Faster with Founders, Engineers & Weekly Architecture Reviews
Inside Vibe Club (hamidun.com/club) — weekly live masterminds with Zhemal Khamidun, Tech Radar, full LMS access, and 370+ production Claude Code skills.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.