Meta apresenta Sapiens2, modelo único de visão computacional para pose, segmentação e 3D
A Meta lançou o Sapiens2, nova família de modelos de visão de alta resolução para tarefas ligadas a pessoas. Uma única arquitetura cobre estimativa de pose, segmentação de partes do corpo, surface normals, pointmap e albedo. A linha escala de 0,4 a 5 bilhões de parâmetros, foi treinada com 1 bilhão de imagens de pessoas e, segundo a empresa, supera de forma notável a primeira geração do Sapiens em precisão. *A Meta foi classificada como organização extremista e é proibida na Rússia.
Processado por IA de MarkTechPost; editado por Hamidun News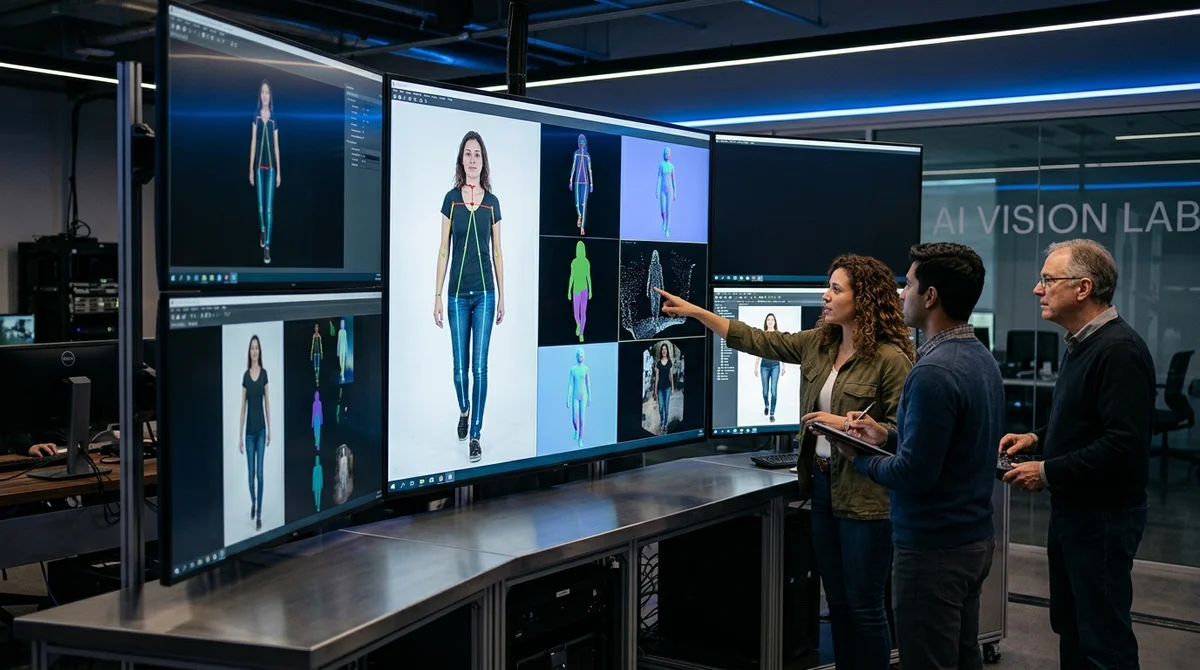
A Meta Reality Labs lançou o Sapiens2, nova geração de modelos de visão centrados em pessoas que tenta substituir um conjunto disperso de redes especializadas por uma única base comum. Em uma só linha, a empresa reuniu tarefas que normalmente ficam separadas: estimativa de pose humana, segmentação de partes do corpo, recuperação de normais de superfície, pointmap para geometria 3D e estimativa de albedo. Para o mercado, é um sinal importante: a Meta continua apostando não só em IA generativa, mas também em visão computacional aplicada, necessária para dispositivos de RA, avatares digitais, provador virtual, motion capture e análise de vídeo.
A ideia central do Sapiens2 é que uma arquitetura base pode atuar ao mesmo tempo em vários níveis de compreensão de uma pessoa no quadro. O sistema não precisa mais de uma rede para o esqueleto, outra para a marcação do corpo e uma terceira para a geometria da superfície. A Meta afirma que um único backbone cobre todos esses cenários após o ajuste fino.
Na prática, isso simplifica o pipeline de produção: menos componentes, menos dessincronização entre modelos e menor custo de manutenção. Entre os checkpoints publicados, há, em particular, um modelo de estimativa de pose top-down com 308 pontos-chave, incluindo pontos detalhados de rosto, mãos e pés, além de segmentação em 29 classes de partes do corpo. A atualização principal não está só no conjunto de tarefas, mas também em como o modelo foi treinado.
O Sapiens2 foi pré-treinado em um dataset curado de 1 bilhão de imagens de pessoas de alta qualidade. No pré-treinamento, a Meta combinou reconstrução de imagem mascarada com um objetivo contrastivo autodestilado, para que o modelo mantenha ao mesmo tempo detalhes de baixo nível para predição densa e semântica de alto nível para cenários zero-shot e com poucos rótulos. A arquitetura também incorpora técnicas de modelos frontier mais recentes para sustentar ciclos de treinamento mais longos sem perder estabilidade.
A linha escala de 0,4 a 5 bilhões de parâmetros, opera em resolução nativa de 1K, e as variantes hierárquicas suportam 4K e usam windowed attention para um contexto espacial mais longo. Em relação à primeira geração do Sapiens, a Meta declara ganho notável em quase todas as métricas principais. Em estimativa de pose, a nova versão soma 4 pontos de mAP; em segmentação de partes do corpo, 24,3 pontos de mIoU; e em surface normals reduz o erro angular em 45,6%.
Também vale destacar que o Sapiens2 vai além das tarefas habituais do primeiro lançamento. Agora a família consegue construir pointmap, ou seja, prever para cada pixel as coordenadas 3D no sistema da câmera, e trabalhar com albedo, a cor base da superfície sem influência da iluminação. Para avatares, RA e provador digital, isso é especialmente útil: essas representações ajudam a reconstruir com mais precisão a forma da pessoa, transferir iluminação e montar cenas 3D mais convincentes a partir de uma foto comum.
O valor prático do lançamento é que a Meta não se limitou a um artigo de pesquisa. A empresa já publicou a família Sapiens2 no Hugging Face e o código no GitHub, e a coleção traz variantes separadas para pose, segmentação, normals e pointmap. Isso reduz a barreira de entrada para equipes que criam produtos de visão computacional para pessoas, de apps de fitness e sistemas de videoanálise a interfaces XR e personagens virtuais.
É importante lembrar, porém, que o Sapiens2 não é um modelo universal para qualquer visão computacional, mas uma pilha forte especificamente para imagens centradas em pessoas. Ou seja, seu ponto forte são cenas em que a pessoa continua sendo o objeto central, com sua pose, superfície, roupas e geometria corporal. O que isso significa na prática: a Meta dá mais um passo rumo a um backbone visual unificado para tudo que envolve uma pessoa no quadro.
Se os resultados declarados se confirmarem em cenários reais de produção, a empresa ganhará uma base sólida para seus próprios produtos XR e definirá um novo patamar para a pesquisa aberta em visão centrada em pessoas. Para o mercado, é um bom exemplo de como os foundation models começam a gerar retorno não só em texto e geração, mas também em tarefas precisas e de engenharia de visão computacional.
*A Meta foi classificada como organização extremista e é proibida na Rússia.
- 2 de nov. de 2026Assistente Muse, da Meta, mantém dossiê sobre pessoas próximas e recebe root no Ubuntu por padrão
- 2 de nov. de 2026Jornalista da The Verge monta um rival do Meta Muse Charm por $50 com ajuda do Claude Code
- 1 de nov. de 2026Camada de proteção MoneyGate barrou os 42 pedidos fraudulentos feitos a IAs locais
- 31 de out. de 2026Gateway de LLM open source KTMS 1.0 conecta GPUs próprias à nuvem e sobrevive a falhas
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.