Databricks e Infosys: por que os dados travam a adoção da inteligência artificial
A principal barreira para a IA corporativa é mais sem graça que os próprios modelos: os dados. As empresas querem passar de chatbots para a automação de processos e agentes de IA, mas para isso precisam de repositórios unificados, permissões de acesso claras, controle da origem dos dados e uma ligação entre sistemas analíticos e transacionais. Sem essa base, os pilotos impressionam, mas a escala logo esbarra em caos e riscos.
Processado por IA de MIT Technology Review; editado por Hamidun News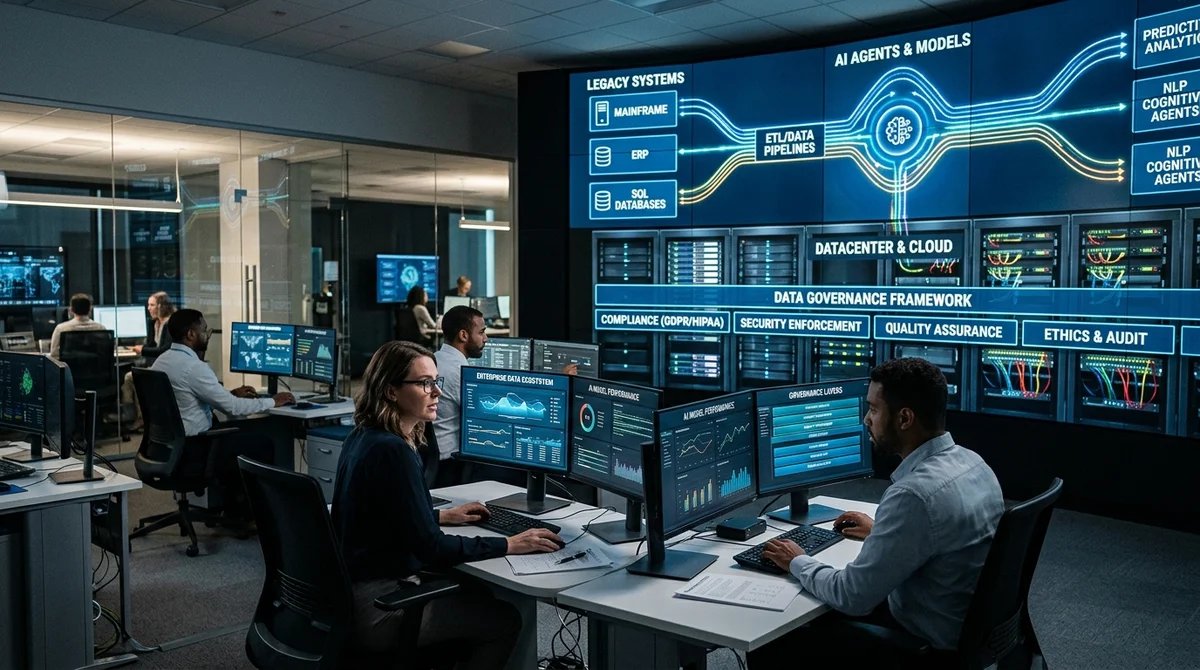
As empresas discutem inteligência artificial no nível do conselho de administração cada vez mais, mas o lançamento real de IA nos negócios costuma ser travado não pelos modelos nem pelo poder de computação, e sim pelo estado dos dados corporativos. Os serviços de consumo acostumaram o mercado a efeitos instantâneos, mas dentro das grandes organizações logo se descobre algo mais prosaico: sem uma infraestrutura de dados unificada, governada e pronta para uso em produção, a IA continua sendo uma demonstração bonita, e não uma ferramenta de trabalho.
O principal problema é que os dados nas empresas costumam viver em camadas diferentes demais. Uma parte está em data marts analíticos e data lakes, outra em sistemas transacionais como CRM, ERP e aplicativos internos, e outra ainda está espalhada entre arquivos, e-mails, bases de conhecimento, tickets e serviços em nuvem. Para relatórios comuns, esse cenário ainda é tolerável.
Mas quando a empresa quer dar ao modelo acesso a dados em tempo real, embutir a IA nos processos ou lançar agentes que não apenas respondem a perguntas, mas também executam ações, a fragmentação vira uma restrição direta. O modelo pode ser forte, mas se ele não enxerga o contexto atual, não entende a origem dos dados e não opera dentro de permissões de acesso claras, o resultado é instável e arriscado.
É por isso que a conversa sobre IA corporativa se desloca cada vez mais dos modelos para a arquitetura. Uma das teses centrais é que as empresas precisam não de um conjunto de ferramentas de IA desconexas, mas de um novo data stack, em que os dados sejam armazenados em formatos abertos, descritos por metadados, acessíveis por políticas unificadas e utilizáveis ao mesmo tempo para análise e para cenários operacionais. Daí o interesse por arquiteturas que unem os mundos OLAP e OLTP: de um lado, as empresas precisam de profundidade analítica, histórico e escala; de outro, baixa latência, transacionalidade e capacidade de agir rápido.
Nessa abordagem, a Databricks promove o Lakebase como uma camada de Postgres serverless para cargas operacionais de IA, e o Unity Catalog como uma camada única de controle de acesso, linhagem de dados e governança para dados e ativos de IA. O ponto não está nos produtos específicos, mas na tendência: o negócio precisa de uma base sobre a qual a IA possa rodar em produção, e não apenas em um piloto.
Outra questão é como medir o efeito. Numa fase inicial, as empresas costumam se contentar com métricas vistosas, como o número de consultas ao chatbot ou o percentual de funcionários que abriram copilotos. Mas, à medida que a adoção amadurece, isso já não basta.
Se a IA deve automatizar processos, encurtar o ciclo de uma operação, aumentar a conversão ou criar novas fontes de receita, ela precisa ser avaliada como um sistema de negócio completo. Por isso, na discussão sobre o novo data stack surge também o tema da medição de valor: o efeito da IA deve ser ligado não ao efeito uau, mas a resultados concretos para o negócio. Isso é especialmente importante na transição para a IA agêntica, em que o modelo ganha mais autonomia e, portanto, os requisitos de observabilidade, registro de logs, qualidade dos dados e política de acesso ficam muito mais rígidos.
A evolução da IA corporativa parece bastante clara. Primeiro, as empresas adotam ferramentas individuais de produtividade: assistentes para busca, resumo, escrita de código ou preparação de documentos. Depois passam à automação de processos: tratamento de solicitações, roteamento de tarefas, suporte interno e cenários financeiros e operacionais. E só então se abre o terceiro estágio: o lançamento de novos produtos e linhas de negócio construídos desde o início em torno da IA. A cada estágio, as exigências sobre os dados crescem. O que ainda funcionava para um copiloto pessoal deixa de funcionar para um processo que exige precisão, um registro completo das ações e a possibilidade de executar operações com segurança em nome da empresa.
Daí a principal conclusão: a próxima batalha pela IA corporativa não é pela melhor interface para um modelo, mas pela reestruturação dos dados para uso por máquinas. Vencerão não as empresas que conectaram o chatbot da vez mais rápido, mas as que conseguirem tornar seus dados unificados, governados e compatíveis com cenários agênticos. Para o negócio, isso significa uma verdade desagradável, porém útil: o caminho para a IA em grande escala começa não pela escolha de um modelo, mas pela reconstrução do data stack.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.