AWS mostra como sincronizar automaticamente bases de conhecimento do Amazon Bedrock via S3
A AWS descreveu uma solução serverless que sincroniza automaticamente documentos do S3 com as Amazon Bedrock Knowledge Bases. O fluxo captura eventos no armazenamento, enfileira as tarefas no SQS e dispara ingestion jobs apenas dentro das cotas do serviço. Com isso, a base de conhecimento é atualizada quase em tempo real, sem controle manual e sem sobrecarregar a API.
Processado por IA de AWS Machine Learning Blog; editado por Hamidun News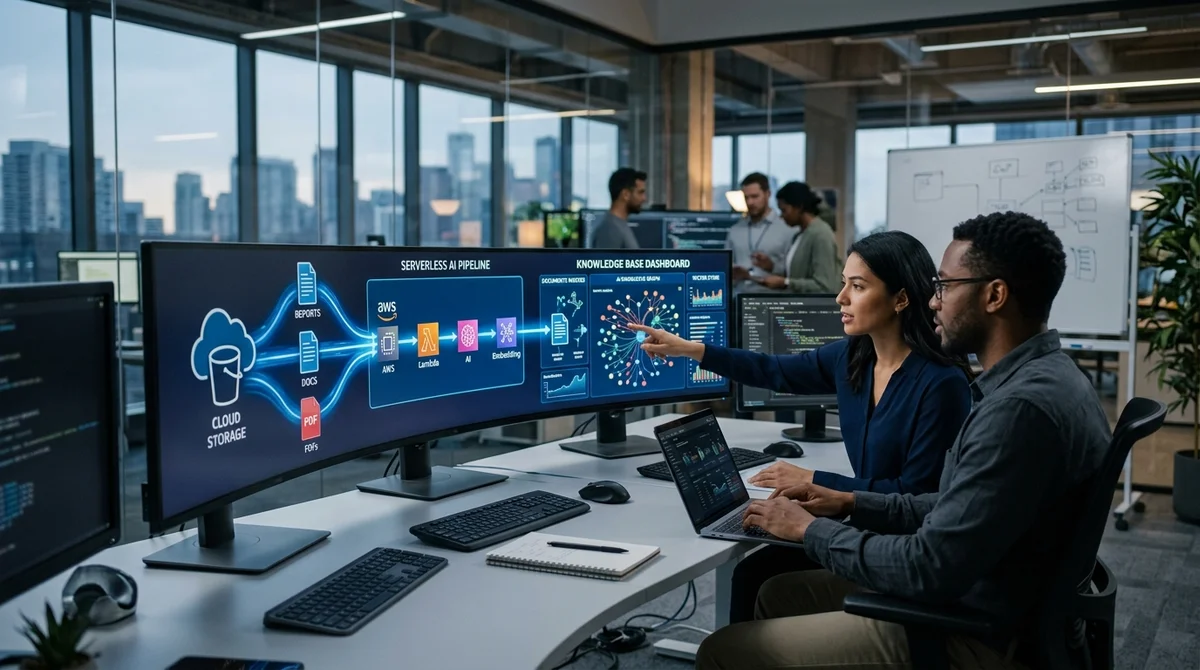
A AWS apresentou uma forma prática de atualizar automaticamente as bases de conhecimento do Amazon Bedrock, sem precisar disparar ingestion jobs manualmente a cada mudança no armazenamento. A ideia é conectar os eventos do Amazon S3 a um pipeline serverless que identifica arquivos novos ou alterados, inicia a sincronização e, ao mesmo tempo, não ultrapassa os limites do Bedrock. Para equipes que criam serviços de RAG sobre documentos corporativos, isso elimina um dos problemas operacionais mais comuns: a base de conhecimento deixa de ficar defasada em relação aos dados de origem e passa a ser atualizada de forma previsível, e não por agendamento ou comando manual.
As Knowledge Bases do Amazon Bedrock servem para conectar modelos generativos aos dados internos da empresa, como manuais, artigos, PDFs, planilhas e outras documentações. Só que o modelo não fica sabendo de novos arquivos sozinho: depois que os dados chegam ao S3, ainda é preciso reindexá-los por meio de um ingestion job. Feito à mão, esse processo desanda rapidamente em escala: documentos entram em momentos diferentes, as atualizações chegam de forma irregular e a equipe passa a se dividir entre o console da AWS, scripts e filas de sincronização.
A solução descrita pela AWS se baseia em uma arquitetura orientada a eventos. Quando um novo arquivo aparece no S3, um objeto existente é modificado ou ocorre outro evento relevante, o sistema registra a mudança e dispara um ingestion job para a base de conhecimento correspondente. A abordagem serverless é importante aqui por dois motivos.
Primeiro, não é preciso manter um serviço rodando o tempo todo só para checar alterações. Segundo, a lógica escala com facilidade diante de um fluxo imprevisível de atualizações: quando há poucos eventos, a infraestrutura quase não consome recursos; quando eles aumentam, o pipeline continua funcionando de forma automática. O foco principal não está só no disparo automático, mas no respeito às cotas de serviço do Amazon Bedrock.
É um detalhe importante, porque um esquema ingênuo, em que cada evento inicia imediatamente uma tarefa separada, pode esbarrar rapidamente nos limites da API, sobretudo quando centenas de arquivos são enviados ao bucket ao mesmo tempo ou quando um acervo de documentos é atualizado em massa. Por isso, a sincronização precisa saber dosar a carga, não criar ingestion jobs desnecessários e não transformar uma automação útil em fonte de erros e chamadas repetidas. Outro ponto positivo é o monitoramento completo: fica mais fácil para a equipe ver quais jobs foram iniciados, onde houve atrasos e se alguma mudança nos dados está passando despercebida.
Para equipes de produto e engenharia, isso está longe de ser um detalhe menor de infraestrutura. Em sistemas baseados em RAG, a qualidade da resposta depende diretamente de quão atualizado é o contexto que o modelo recebe. Se a base de conhecimento é atualizada com atraso, o usuário pode ver preços desatualizados, normas antigas, descrições de processos obsoletas ou documentos ausentes.
A sincronização automática reduz essa distância entre a fonte de dados e a resposta do modelo. Além disso, ela simplifica a operação: em vez de disparar atualizações manualmente após cada carga de dados, a equipe ganha um processo reproduzível, com lógica clara, controle de carga e observabilidade. Também chama atenção o fato de a AWS apostar justamente em um esquema serverless e event-driven, e não em uma integração pesada com processamento contínuo em segundo plano.
Para muitas empresas, esse é o caminho mais prático para implantar busca generativa sobre armazenamentos que já existem no S3: os dados continuam no ambiente de sempre, e a atualização do índice vira uma reação a eventos. A abordagem é especialmente útil onde os documentos mudam com frequência — suporte, base de conhecimento interna, análise de dados, compliance e documentação de produto. A conclusão é simples: à medida que o Bedrock é cada vez mais usado como base para assistentes corporativos e busca em documentos, a sincronização manual de dados se torna o elo fraco.
Na prática, a AWS oferece um modelo para automatizar esse processo sem perder o controle sobre as cotas e o estado do pipeline. Para as empresas, isso significa respostas mais atualizadas dos modelos, menos trabalho manual repetitivo e um funcionamento mais previsível da base de conhecimento em produção.
- 2 de nov. de 2026Steering vectors no ajuste fino de LLMs melhoraram SFT e destilação em três seeds
- 2 de nov. de 2026Anthropic precisa crescer a receita 32% ao ano para cobrir contratos de US$ 850 bilhões
- 2 de nov. de 2026Jornalista da The Verge monta um rival do Meta Muse Charm por $50 com ajuda do Claude Code
- 31 de out. de 2026Worldwide Express entrega contas contestadas a agentes de IA e reduz dívida em 75%
Ship AI Faster with Founders, Engineers & Weekly Architecture Reviews
Inside Vibe Club (hamidun.com/club) — weekly live masterminds with Zhemal Khamidun, Tech Radar, full LMS access, and 370+ production Claude Code skills.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.