llm-checker: utilitário mostra quais LLMs o seu hardware aguenta
Surgiu o llm-checker, uma ferramenta CLI de código aberto que analisa a configuração de hardware do computador e define quais modelos de linguagem podem ser executados localmente via Ollama. Ela examina GPU, memória RAM e processador e, depois, avalia compatibilidade, velocidade e qualidade de cada um dos mais de 35 modelos, dos compactos de 1 bilhão de parâmetros aos parrudos de 32 bilhões. A lista de modelos é curada manualmente, o que mantém as recomendações atualizadas. A ferramenta ataca uma das maiores dores dos entusiastas de IA local: parar de chutar e saber com precisão o que o hardware que já possuem aguenta.
Processado por IA de Habr AI; editado por Hamidun News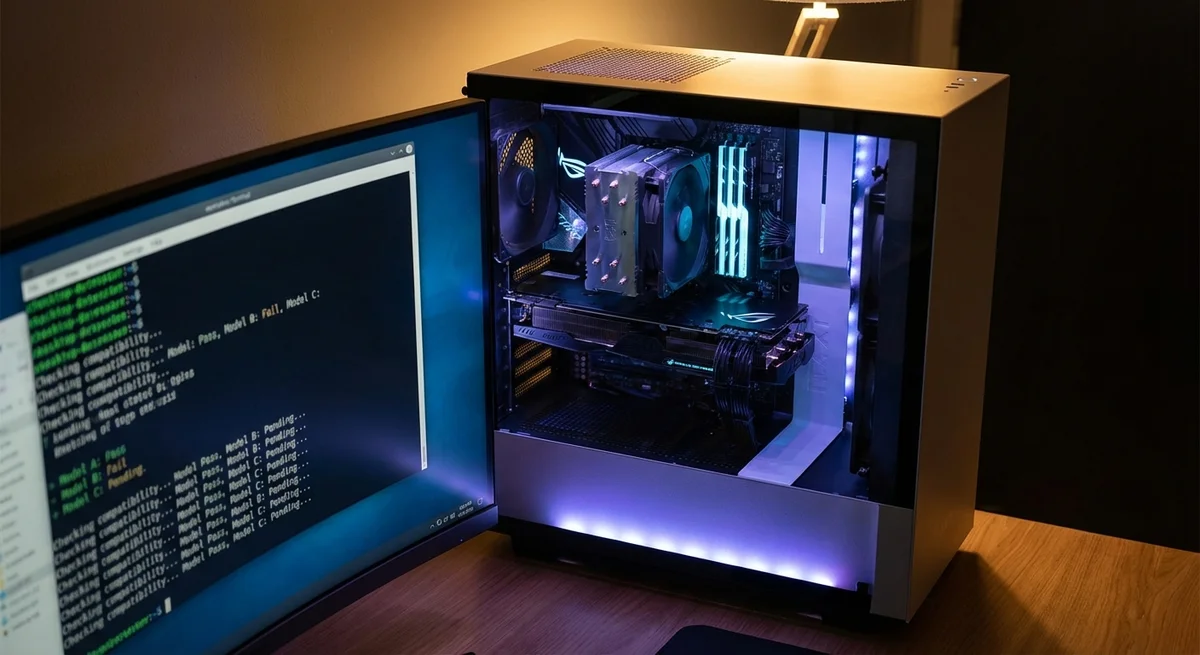
Uma das perguntas mais comuns entre quem roda modelos de linguagem localmente parece enganosamente simples: meu hardware aguenta? Até agora, a resposta precisava ser montada aos pedaços, com benchmarks dispersos, discussões no Reddit e tentativa e erro. Uma nova ferramenta de código aberto, o llm-checker, tenta resolver a dúvida com um único comando no terminal.
O llm-checker é um utilitário CLI que examina a configuração de hardware do computador e entrega um veredito concreto: quais modelos de linguagem do ecossistema Ollama você pode rodar, com que velocidade e com que qualidade. A ferramenta analisa três componentes-chave, a placa de vídeo, a memória RAM e o processador, e com esses dados gera um relatório personalizado para mais de 35 modelos, dos compactos de 1 bilhão de parâmetros aos imponentes de 32 bilhões.
Para entender por que isso importa, vale lembrar o contexto. Nos últimos dois anos, o movimento de rodar grandes modelos de linguagem localmente deixou de ser um hobby marginal e virou uma frente de peso. O Ollama se tornou o padrão de fato para quem quer rodar um LLM no próprio computador, sem assinaturas de nuvem e sem enviar dados para servidores de terceiros.
Llama, Mistral, Gemma, Phi, DeepSeek, Qwen: o número de modelos disponíveis cresce a cada mês, e cada um tem seus próprios requisitos de hardware. O problema é que ninguém sistematizou esses requisitos por configuração específica. Quem tem uma RTX 3060 com 12 GB de VRAM e 32 GB de RAM precisa descobrir sozinho se aguenta o Llama 3.
1 de 8 bilhões de parâmetros em quantização Q4 ou se é melhor nem tentar.
É exatamente essa lacuna entre a abundância de modelos e a opacidade dos requisitos de hardware que o llm-checker preenche. O utilitário é bem direto: você executa o comando, ele consulta o sistema, compara as características com uma base de conhecimento interna de modelos e devolve o resultado. Cada modelo é avaliado em três eixos: compatibilidade (se vai rodar, afinal), velocidade (se a geração de tokens será confortável) e qualidade (se será preciso sacrificar precisão por desempenho). Não são notas abstratas, mas informação prática que poupa horas de experimentos.
A abordagem de curadoria da lista de modelos merece atenção à parte. Os autores decidiram conscientemente não varrer automaticamente todo o catálogo do Ollama e moderam a lista manualmente. É uma decisão de princípio: o catálogo do Ollama tem centenas de modelos de qualidade variada, incluindo desatualizados, experimentais e francamente inúteis. A curadoria manual significa que o usuário recebe recomendações apenas sobre modelos testados e atuais, que realmente valem a pena rodar. Num mundo em que o número de LLMs abertos dobra a cada poucos meses, esse filtro é uma vantagem, não uma limitação.
Tecnicamente, a ferramenta resolve um problema nada trivial. O desempenho de um LLM local depende de vários fatores: a quantidade de VRAM determina se o modelo cabe inteiro na GPU; a velocidade da RAM afeta o offloading das camadas que não couberam na VRAM; a arquitetura do processador importa para modelos que rodam em modo CPU. A quantização adiciona mais uma dimensão: o mesmo modelo em Q8 pode não caber na memória, enquanto em Q4 funciona, mas com perda perceptível de qualidade. O llm-checker assume todos esses cálculos e os transforma em recomendações claras.
Num contexto mais amplo, o surgimento de ferramentas assim sinaliza o amadurecimento do ecossistema de IA local. Quando uma tecnologia sai do círculo de desenvolvedores e entusiastas, ela precisa de pontes entre a complexidade e a simplicidade. O llm-checker é uma dessas pontes. Ele não faz nada revolucionário do ponto de vista tecnológico, mas resolve um problema real dos usuários que até agora vinha sendo ignorado.
Claro, a ferramenta tem limitações óbvias. A dependência do Ollama deixa de fora quem usa llama.cpp, vLLM ou outros backends. A moderação manual da lista de modelos é ao mesmo tempo força e fraqueza, porque a atualização depende da atividade dos mantenedores. O desempenho real sempre vai diferir das previsões, porque dezenas de variáveis o influenciam e não dá para levá-las em conta remotamente, da temperatura da GPU sob carga aos processos em segundo plano no sistema.
Ainda assim, o llm-checker aponta na direção certa. À medida que rodar LLMs localmente se populariza, e todas as tendências indicam isso, a demanda por ferramentas simples de diagnóstico e recomendação só vai crescer. Hoje é um utilitário CLI para usuários avançados. Amanhã, uma funcionalidade parecida pode muito bem virar parte nativa do próprio Ollama ou de alternativas. Porque a melhor maneira de atrair usuários para a IA local é eliminar a barreira da incerteza e dar uma resposta honesta a uma pergunta simples: o que exatamente eu consigo rodar agora.
- 2 de nov. de 2026Assistente Muse, da Meta, mantém dossiê sobre pessoas próximas e recebe root no Ubuntu por padrão
- 2 de nov. de 2026Jornalista da The Verge monta um rival do Meta Muse Charm por $50 com ajuda do Claude Code
- 1 de nov. de 2026Camada de proteção MoneyGate barrou os 42 pedidos fraudulentos feitos a IAs locais
- 31 de out. de 2026Gateway de LLM open source KTMS 1.0 conecta GPUs próprias à nuvem e sobrevive a falhas
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.