Como o produto escalar de um livro de álgebra virou a base do ChatGPT, do Claude e do Gemini
Em 2017, o Google publicou "Attention is All You Need", e as redes neurais nunca mais foram as mesmas. Hoje, ChatGPT, Claude, Gemini e Midjourney rodam em transformers. Mas qual é a base deles? Não uma arquitetura de memória complexa nem um modelo biologicamente fiel do cérebro, e sim o produto escalar de dois vetores, direto do livro de álgebra. A operação é tão simples que aparece nas primeiras aulas.
Processado por IA de Habr AI; editado por Hamidun News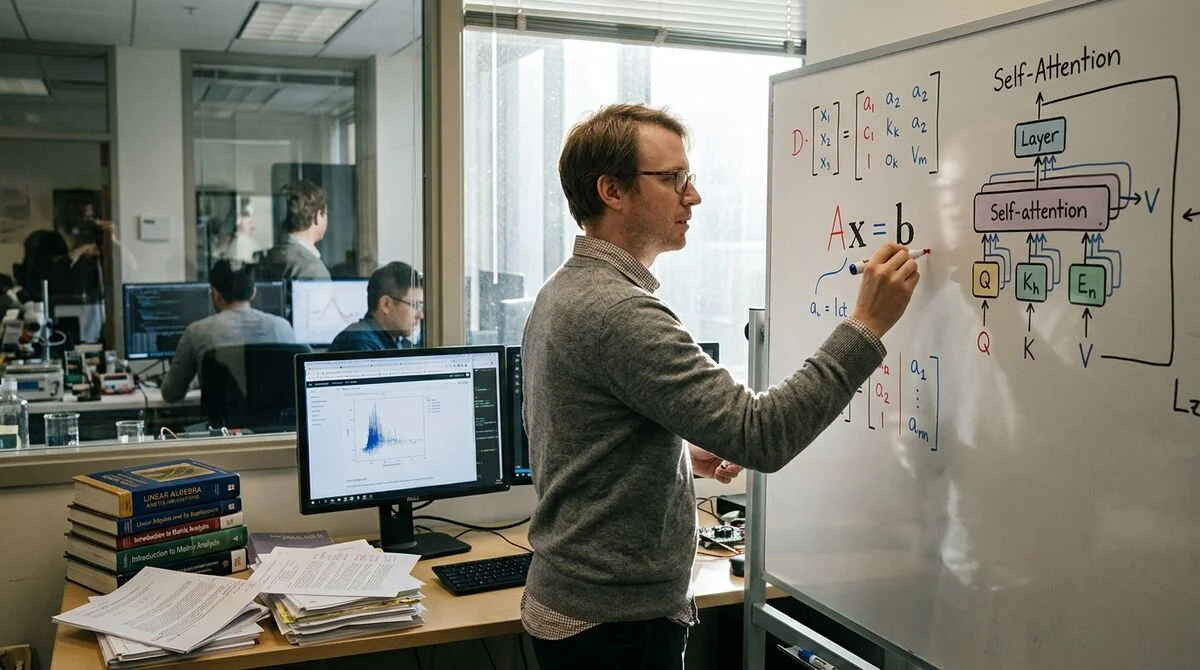
Em 2017, um grupo de engenheiros do Google publicou o artigo "Attention is All You Need", que dividiu, sem alarde, a história da inteligência artificial em "antes" e "depois". Sem apresentações pomposas nem robôs humanoides, oito pesquisadores descreveram uma arquitetura que hoje sustenta o ChatGPT, o Claude, o Gemini, o Midjourney e praticamente toda a IA generativa moderna. O mais surpreendente é que a base dessa revolução acabou sendo uma das operações mais simples da álgebra linear: o produto escalar de dois vetores.
A parede que as redes neurais encontraram
Antes dos transformers, o processamento de texto era dominado por redes recorrentes: RNN e LSTM. Elas liam as frases em sequência, palavra por palavra, passo a passo. O problema é que, no fim de um texto longo, o modelo "esquecia" o começo: o sinal se enfraquecia ao passar por centenas de etapas intermediárias. Isso ficou conhecido como problema do desvanecimento do gradiente.
Imagine um modelo que lê um romance e, no quinto capítulo, já não lembra o nome do protagonista. Foi nessa parede que as redes neurais bateram em meados da década de 2010. A arquitetura escalava mal, e a computação paralela era praticamente inviável, pois cada passo dependia do anterior. Era preciso algo fundamentalmente diferente.
Por que o produto escalar é genialmente simples
O produto escalar é uma operação de qualquer curso padrão de álgebra vetorial. Pegam-se dois vetores, multiplicam-se suas coordenadas par a par e somam-se todos os resultados. A saída é um único número: quanto maior, mais "parecidos" ou "próximos" os vetores são entre si.
No mecanismo de self-attention do transformer, a operação é aplicada assim:
- Cada palavra é transformada em três vetores: Query (consulta), Key (chave) e Value (valor)
- O produto escalar do Query de uma palavra pelo Key de cada uma das outras mostra a "força da ligação" entre o par de palavras
- Os resultados são escalados e normalizados por softmax, gerando pesos de atenção de 0 a 1
- O vetor final da palavra é a soma ponderada de todos os Value, de acordo com esses pesos
Na prática, cada token pergunta a todos os outros ao mesmo tempo: "Quão importante você é para a minha compreensão agora?", e recebe uma resposta numérica precisa. Isso acontece em paralelo para a frase inteira, e não palavra por palavra.
Três propriedades que mudaram a indústria
O produto escalar se mostrou uma operação ideal para a linguagem por vários motivos ao mesmo tempo.
Paralelismo. Todos os cálculos de atenção podem ser executados simultaneamente, ao contrário das RNN, em que cada passo depende do anterior. Isso liberou as GPUs e TPUs e permitiu escalar os modelos para centenas de bilhões de parâmetros. Foi assim que, em poucos anos, surgiram o BERT, o GPT-3 e, depois, o GPT-4 e o Claude.
Contexto global sem desvanecimento. Cada palavra "enxerga" imediatamente todas as outras, independentemente da distância no texto. O pronome "ele", no fim de um parágrafo longo, se liga corretamente ao nome do personagem do início. Sem perda de sinal por camadas intermediárias.
Interpretabilidade. As matrizes de atenção podem ser visualizadas: dá para ver literalmente a qual palavra cada uma presta atenção ao processar uma frase. Isso é raro no mundo das redes neurais, onde a maioria das decisões continua sendo uma caixa-preta.
"Não precisamos de recorrência nem de convoluções", escreveram os autores em 2017.
Para a comunidade da época, aquilo soava como heresia. Três anos depois, virou axioma.
O que isso significa
O transformer provou que uma revolução na IA pode vir não da neurobiologia nem da filosofia da consciência, mas de um livro de álgebra linear do segundo ano. ChatGPT, Claude, Gemini e Midjourney, na essência, multiplicam matrizes de produtos escalares bilhões de vezes por segundo. A simplicidade da operação foi sua maior força: não foi mais complexidade, mas a escolha certa de uma ferramenta elementar que mudou tudo.
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
- 1 de nov. de 2026Google admite que o AI Mode reduz a receita da Busca; ações caem 15%
- 31 de out. de 2026Autor levou seu roteiro a um júri de IA: o veredito custou 850 mil tokens
- 31 de out. de 2026Anthropic: unir subagentes em um só ciclo fez as tarefas de um cliente rodarem duas vezes mais rápido
Perguntas frequentes sobre a notícia
O que se sabe sobre A parede que as redes neurais encontraram?
Antes dos transformers, o processamento de texto era dominado por redes recorrentes: RNN e LSTM. Elas liam as frases em sequência, palavra por palavra, passo a passo. O problema é que, no fim de um texto longo, o modelo "esquecia" o começo: o sinal se enfraquecia ao passar por centenas de etapas intermediárias. Isso ficou conhecido como problema do desvanecimento do gradiente. Imagine um modelo que lê um romance e, no quinto capítulo, já não lembra o nome do protagonista. Foi nessa parede que as redes neurais bateram em meados da década de 2010. A arquitetura escalava mal,
Por que o produto escalar é genialmente simples?
O produto escalar é uma operação de qualquer curso padrão de álgebra vetorial. Pegam-se dois vetores, multiplicam-se suas coordenadas par a par e somam-se todos os resultados. A saída é um único número: quanto maior, mais "parecidos" ou "próximos" os vetores são entre si. No mecanismo de self-attention do transformer, a operação é aplicada assim: Cada palavra é transformada em três vetores: Query (consulta), Key (chave) e Value (valor) O produto escalar do Query de uma palavra pelo Key de cada uma das outras mostra a "força da ligação" entre o par de palavras Os resultados
O que se sabe sobre Três propriedades que mudaram a indústria?
O produto escalar se mostrou uma operação ideal para a linguagem por vários motivos ao mesmo tempo. Paralelismo. Todos os cálculos de atenção podem ser executados simultaneamente, ao contrário das RNN, em que cada passo depende do anterior. Isso liberou as GPUs e TPUs e permitiu escalar os modelos para centenas de bilhões de parâmetros. Foi assim que, em poucos anos, surgiram o BERT, o GPT-3 e, depois, o GPT-4 e o Claude. Contexto global sem desvanecimento. Cada palavra "enxerga" imediatamente todas as outras, independentemente da distância no texto. O pronome "ele", no fim
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.