Janela de contexto não é memória: o que desenvolvedores de agentes de IA precisam entender
Desenvolvedores de agentes de IA costumam tomar uma janela de contexto grande por memória de longo prazo, e isso é um erro fundamental de arquitetura. O contexto some ao fim de cada sessão, enquanto a memória de verdade exige um sistema separado: RAG, compressão ou armazenamento episódico. Um agente com janela de 2 milhões de tokens ainda esquecerá o usuário no dia seguinte.
Processado por IA de Machine Learning Mastery; editado por Hamidun News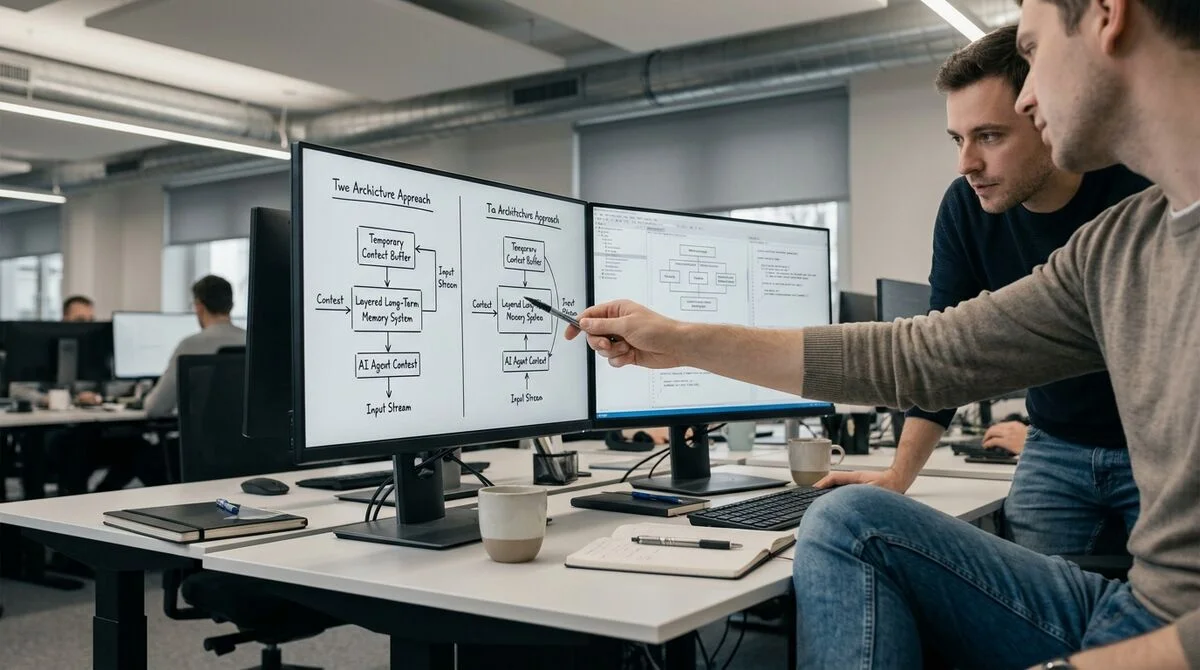
Uma janela de contexto grande é um argumento popular na hora de escolher o modelo de um agente de IA. Mas ela resolve um problema diferente do da memória de longo prazo. Desenvolvedores que confundem os dois constroem agentes com uma falha fundamental de arquitetura.
Contexto é uma mesa de trabalho, não um arquivo
A janela de contexto funciona como a memória RAM de um computador: tudo o que está nela é o que o agente "enxerga" agora e pode usar na resposta. Quando a sessão termina, o conteúdo desaparece sem deixar rastro.
A memória de longo prazo é algo fundamentalmente diferente: o conhecimento persiste entre sessões, é indexado e recuperado quando necessário. É um sistema separado, com arquitetura própria, projetado independentemente da escolha do modelo.
Um agente com janela de 2 milhões de tokens continua esquecendo o usuário no dia seguinte. Aumentar o contexto apenas adia o confronto com o problema, mas não o elimina.
Cinco técnicas para uma memória de verdade
Desenvolvedores de agentes de IA usam várias abordagens para gerenciar conhecimento entre sessões:
- RAG (Retrieval-Augmented Generation): o agente consulta uma base de conhecimento externa só quando precisa, em vez de guardar tudo na janela. Serve para grandes corpora de documentos.
- Compression: um histórico longo de conversa é condensado em um resumo curto, que ocupa de 10 a 20 vezes menos tokens.
- Episodic memory: fatos-chave sobre o usuário ou a tarefa são salvos em um armazenamento estruturado e carregados no início da próxima sessão.
- Summarization chains: documentos grandes são convertidos em resumos antes de chegar ao contexto do agente.
- Selective storage: um orquestrador decide o que vale salvar, o que comprimir e o que descartar de vez.
Cada ferramenta resolve uma tarefa específica. Um chatbot de suporte precisa de memória episódica; um agente analista sobre um corpus de documentos precisa de RAG.
O problema do contexto cheio
Há outra razão para não depender só de uma janela grande: o fenômeno "lost in the middle". Pesquisas mostram que os modelos processam pior a informação que fica no meio de um contexto longo: a qualidade da resposta cai mesmo quando há espaço tecnicamente disponível.
A conclusão prática: mesmo que o contexto comporte tecnicamente 500 páginas de texto, não vale a pena jogar tudo lá dentro. Seletividade e compressão rendem respostas melhores que o preenchimento por força bruta.
"A janela de contexto é uma mesa de trabalho.
Você não empilha nela tudo o que tem: tira só o que precisa agora."
Arquitetura de memória para produção
Equipes que constroem agentes para usuários reais devem projetar o sistema de memória separadamente da escolha do modelo. As perguntas-chave na fase de projeto: o que precisa ser lembrado entre sessões, qual é o TTL de cada tipo de informação, como o agente decide o que salvar e onde armazenar: em um banco vetorial, um relacional ou um grafo de conhecimento.
Sem respostas a essas perguntas, o agente continua sendo uma ferramenta descartável: o usuário precisa explicar o contexto de novo a cada execução. Isso é especialmente crítico em suporte, educação e medicina, em qualquer área em que o conhecimento sobre o usuário se acumula ao longo de semanas.
O que isso significa
Escolher um modelo com contexto grande é tática. O sistema de memória é arquitetura. Desenvolvedores que confundem as duas coisas vão descobrir o problema não no protótipo, mas no produto, quando os usuários já estiverem insatisfeitos. Projete a memória desde o primeiro dia.
- 17 de mai. de 2026Agentes de IA na programação: quais arquiteturas de código funcionam melhor
- 28 de abr. de 2026Machine Learning Mastery lança guia de context engineering para agentes de IA confiáveis
- 8 de abr. de 2026Confissão de um agente de IA: como os limites de memória quebram o trabalho das redes neurais
- 16 de jun. de 2026Por que a IA esquece a conversa: a janela de contexto dos LLMs
Perguntas frequentes sobre a notícia
O que se sabe sobre Contexto é uma mesa de trabalho, não um arquivo?
A janela de contexto funciona como a memória RAM de um computador: tudo o que está nela é o que o agente "enxerga" agora e pode usar na resposta. Quando a sessão termina, o conteúdo desaparece sem deixar rastro. A memória de longo prazo é algo fundamentalmente diferente: o conhecimento persiste entre sessões, é indexado e recuperado quando necessário. É um sistema separado, com arquitetura própria, projetado independentemente da escolha do modelo.
O que se sabe sobre Cinco técnicas para uma memória de verdade?
Desenvolvedores de agentes de IA usam várias abordagens para gerenciar conhecimento entre sessões: RAG (Retrieval-Augmented Generation): o agente consulta uma base de conhecimento externa só quando precisa, em vez de guardar tudo na janela. Serve para grandes corpora de documentos. Compression: um histórico longo de conversa é condensado em um resumo curto, que ocupa de 10 a 20 vezes menos tokens.
O que se sabe sobre O problema do contexto cheio?
Há outra razão para não depender só de uma janela grande: o fenômeno "lost in the middle". Pesquisas mostram que os modelos processam pior a informação que fica no meio de um contexto longo: a qualidade da resposta cai mesmo quando há espaço tecnicamente disponível. A conclusão prática: mesmo que o contexto comporte tecnicamente 500 páginas de texto, não vale a pena jogar tudo lá dentro. Seletividade e compressão rendem respostas melhores que o preenchimento por força bruta.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.