AllenAI lança olmo-eval para avaliar modelos durante o treinamento
A AllenAI abriu o olmo-eval, uma bancada de avaliação para modelos de linguagem integrada diretamente ao processo de treinamento. Em vez de testar só no fim, ele avalia a cada checkpoint, e dá para ver em tempo real como uma mudança no dataset ou nos hiperparâmetros afeta os benchmarks. A ferramenta está publicada no Hugging Face e foi pensada para pesquisadores que querem que a avaliação faça parte do desenvolvimento, e não seja um complemento final.
Processado por IA de Hugging Face Blog; editado por Hamidun News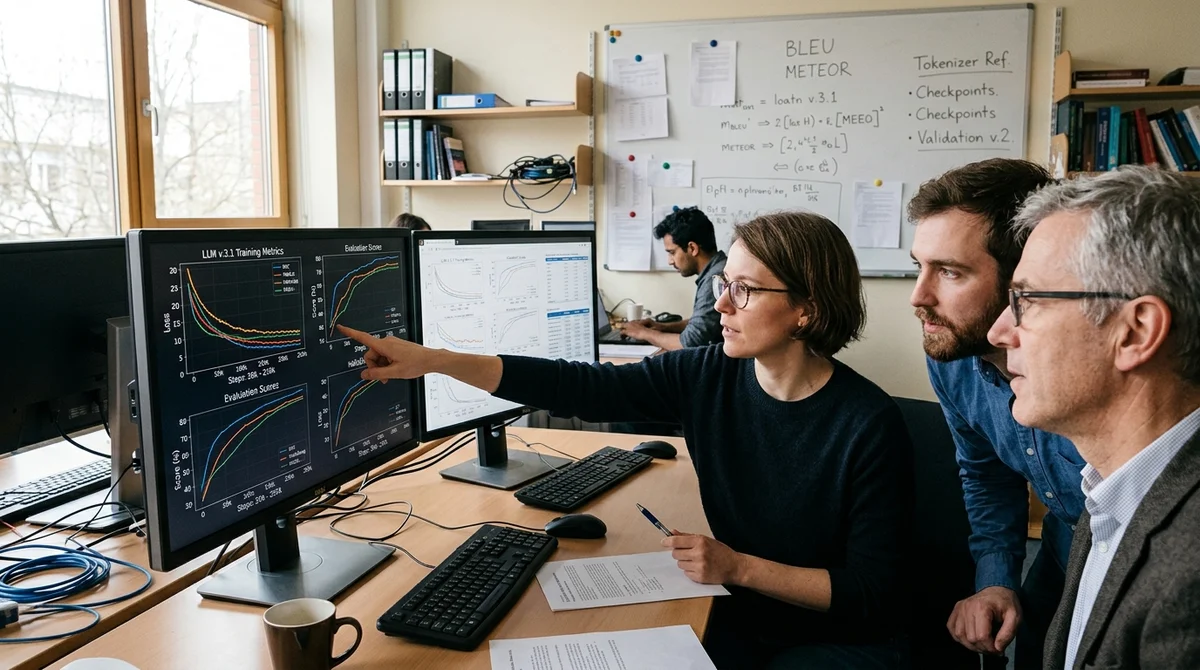
A AllenAI lançou o olmo-eval, uma ferramenta de IA para avaliar modelos de linguagem durante o próprio treinamento.
O que é o olmo-eval e onde encontrá-lo?
O olmo-eval é um kit aberto da AllenAI para avaliar modelos de linguagem, integrado ao ciclo de treinamento. O projeto está disponível no Hugging Face e é voltado a pesquisadores.
Por que avaliar modelos durante o treinamento?
O processo padrão: o modelo é treinado por vários dias ou semanas e depois avaliado em benchmarks (ARC, HellaSwag, MMLU). O olmo-eval permite que os pesquisadores vejam como a qualidade do modelo muda ao longo do treinamento, e não apenas obtenham o resultado final.
- 1 de nov. de 2026Modelos locais perdem para Opus e Codex: 0,21 ponto no MacBook contra 1,00 do Codex
- 1 de nov. de 2026Pika Labs lança o H3 Flex, modelo de vídeo aberto: 6 passos em vez de 50
- 1 de nov. de 2026Tokenizador do BERT na Hugging Face fica 50 vezes mais rápido ao eliminar trabalho desnecessário com ASCII
- 1 de nov. de 2026Universidade de Illinois reúne 12 151 problemas abertos e testa se a IA consegue resolvê-los
Perguntas frequentes sobre a notícia
O que é o olmo-eval e onde encontrá-lo?
O olmo-eval é um kit aberto da AllenAI para avaliar modelos de linguagem, integrado ao ciclo de treinamento. O projeto está disponível no Hugging Face e é voltado a pesquisadores.
Por que avaliar modelos durante o treinamento?
O processo padrão: o modelo é treinado por vários dias ou semanas e depois avaliado em benchmarks (ARC, HellaSwag, MMLU). O olmo-eval permite que os pesquisadores vejam como a qualidade do modelo muda ao longo do treinamento, e não apenas obtenham o resultado final.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.