Como as redes neurais escolhem tokens: logits, temperatura e top-p
Uma rede neural escolhe a próxima palavra por meio de logits e softmax. A temperatura controla a aleatoriedade: uma baixa gera respostas precisas e uma alta, respostas criativas. O top-p filtra as opções pouco prováveis. A configuração desses parâmetros determina a qualidade do texto gerado.
Processado por IA de Machine Learning Mastery; editado por Hamidun News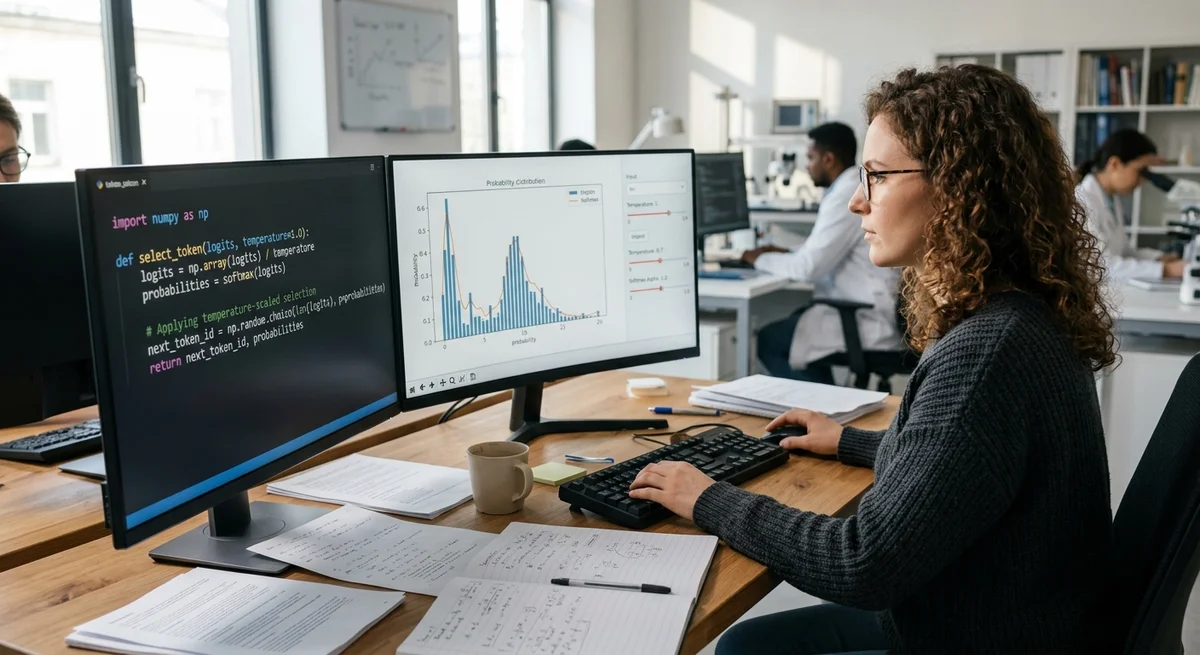
Quando um modelo de linguagem gera texto, ele enfrenta uma tarefa fundamental: escolher a próxima palavra entre milhares de candidatas. Essa escolha não é aleatória, mas regida por mecanismos probabilísticos. Entender logits, temperatura e top-p é a chave para controlar o comportamento de um LLM.
O que são logits e softmax
Para cada token possível, a rede calcula uma pontuação numérica chamada logit. É o sinal bruto da última camada da rede. A palavra "criatividade" pode receber um logit de 5.2, e "telefone", de 2.1. A função softmax transforma esses números em probabilidades (de 0 a 1) que somam 1.
Imagine que o modelo processa "aprendizado de máquina é". Ele calcula os logits de todas as palavras do vocabulário. Após o softmax, a distribuição fica assim: "ciência" = 35%, "arte" = 8%, "pinguim" = 0.001%. O modelo sorteia a partir dessa distribuição: escolhe com mais frequência as opções prováveis e raramente as improváveis.
Temperatura: o regulador de comportamento
A temperatura é um multiplicador aplicado aos logits antes do softmax. A matemática é simples, mas o efeito é forte:
- T < 1 (por exemplo, 0.3) leva o modelo ao lado "gelado". A distribuição fica mais pontiaguda e as opções improváveis recebem probabilidades desprezíveis. O modelo escolhe de forma quase determinística, e as respostas são previsíveis e precisas. Ideal para código, fatos e instruções.
- T = 1 é o comportamento padrão: os logits são usados como estão.
- T > 1 (por exemplo, 1.5–2.0) leva o modelo ao lado "flamejante". A distribuição fica mais uniforme e as opções improváveis ganham uma chance. O modelo escolhe de forma mais aleatória. Ideal para escrita criativa, mas corre o risco de gerar erros ou alucinações.
Temperatura alta deixa o modelo aventureiro; baixa, conservador.
Top-p: amostragem inteligente
O top-p (nucleus sampling) resolve um problema: como evitar que o modelo diga bobagens completas sem tirar sua liberdade. O algoritmo ordena os tokens por probabilidade e pega os primeiros até que a probabilidade acumulada atinja p (geralmente 0.9).
Exemplo: se top-p = 0.9 e a distribuição é esta:
- "ciência" = 40%
- "caminho" = 30%
- "conhecimento" = 15%
- "liberdade" = 10%
- "ping uim" = 5%
O modelo pegará as quatro primeiras opções (40+30+15+10=95%) e descartará "pinguim". O top-p é dinâmico: em um contexto pode selecionar 5 opções, em outro, 200.
O que isso significa
Esses três parâmetros não são mágica, e sim ferramentas de controle. O desenvolvedor escolhe temperatura e top-p conforme a tarefa: gerar código exige temperatura baixa (confiabilidade vale mais que criatividade), enquanto escrever um conto exige temperatura alta (variedade). Entender esses mecanismos transforma o trabalho com LLMs de uma caixa-preta em um problema de engenharia.
Perguntas frequentes sobre a notícia
O que são logits e softmax?
Para cada token possível, a rede calcula uma pontuação numérica chamada logit. É o sinal bruto da última camada da rede. A palavra "criatividade" pode receber um logit de 5.2, e "telefone", de 2.1. A função softmax transforma esses números em probabilidades (de 0 a 1) que somam 1. Imagine que o modelo processa "aprendizado de máquina é". Ele calcula os logits de todas as palavras do vocabulário. Após o softmax, a distribuição fica assim: "ciência" = 35%, "arte" = 8%, "pinguim" = 0.001%. O modelo sorteia a partir dessa distribuição: escolhe com mais frequência as opções prov
O que se sabe sobre Temperatura: o regulador de comportamento?
A temperatura é um multiplicador aplicado aos logits antes do softmax. A matemática é simples, mas o efeito é forte: T < 1 (por exemplo, 0.3) leva o modelo ao lado "gelado". A distribuição fica mais pontiaguda e as opções improváveis recebem probabilidades desprezíveis. O modelo escolhe de forma quase determinística, e as respostas são previsíveis e precisas. Ideal para código, fatos e instruções. T = 1 é o comportamento padrão: os logits são usados como estão. T > 1 (por exemplo, 1.5–2.0) leva o modelo ao lado "flamejante". A distribuição fica mais uniforme e as opções imp
O que se sabe sobre Top-p: amostragem inteligente?
O top-p (nucleus sampling) resolve um problema: como evitar que o modelo diga bobagens completas sem tirar sua liberdade. O algoritmo ordena os tokens por probabilidade e pega os primeiros até que a probabilidade acumulada atinja p (geralmente 0.9). Exemplo: se top-p = 0.9 e a distribuição é esta: "ciência" = 40% "caminho" = 30% "conhecimento" = 15% "liberdade" = 10% "ping uim" = 5% O modelo pegará as quatro primeiras opções (40+30+15+10=95%) e descartará "pinguim". O top-p é dinâmico: em um contexto pode selecionar 5 opções, em outro, 200.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.