Modelos locais na placa de vídeo: Qwen e Gemma testados na Tesla V100
A Tesla V100, lançada em 2017, dá conta de LLMs atuais como Qwen35B e GPT-OSS-20B. A velocidade de geração varia de 38 a 109 tokens por segundo, dependendo do modelo. Os testes incluíram criação de sites e jogos e processamento de documentos. O mínimo é 16 GB de memória, mas 24 GB são preferíveis para uso geral.
Processado por IA de Habr AI; editado por Hamidun News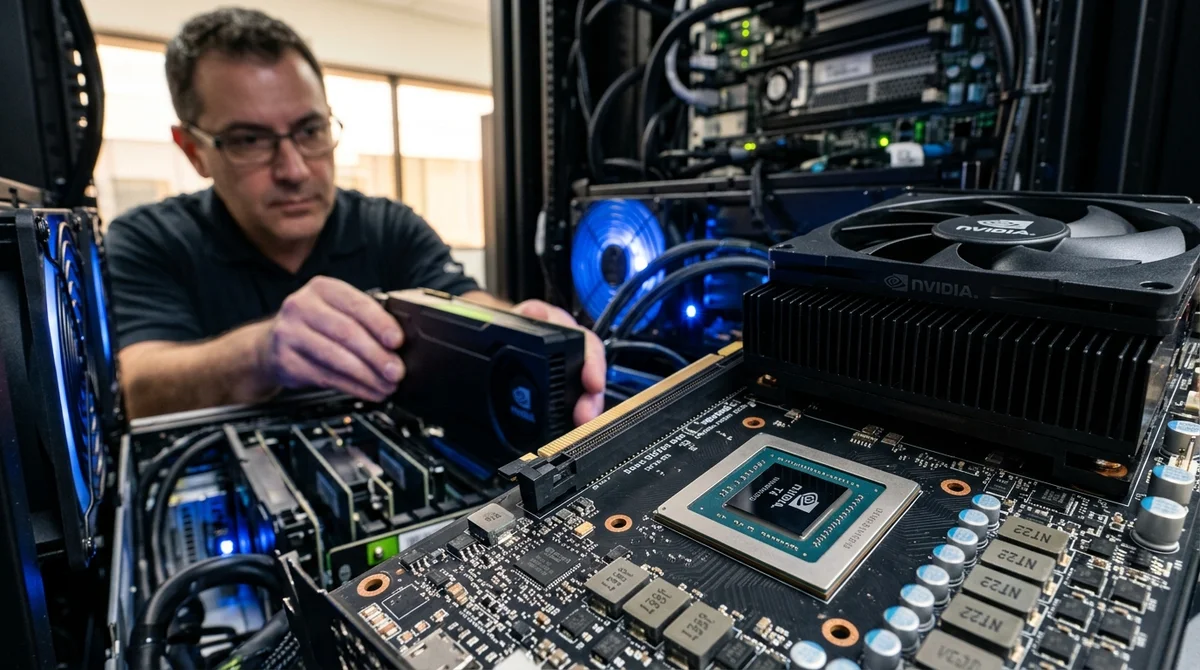
É possível rodar modelos de IA locais em placas de vídeo lançadas ainda em 2017. Testamos cinco modelos abertos populares (do Qwen ao Gemma) na Tesla V100 em cinco cenários reais, da geração de texto à criação de código e jogos.
Quais modelos de IA para texto rodam na V100?
O teste usou cinco modelos abertos, incluindo Qwen e Gemma. A velocidade fica entre 38 e 109 tokens por segundo, dependendo do modelo e da quantização.
Dá para usar uma V100 antiga para rodar IA localmente?
Sim. Segundo o teste, a V100 roda LLMs atuais para gerar texto, escrever código e atender a outros cenários reais.
Quantos tokens por segundo a
Tesla V100 entrega com modelos locais? De 38 a 109 tokens por segundo, dependendo do modelo, do tamanho e da quantização.
- 1 de nov. de 2026Juiz do EditAgent, da Adobe, escolhe uma edição aceitável em 81,3% dos casos, contra 74,8% do EditScore
- 1 de nov. de 2026Teste com 16 modelos em 7 buscadores: Exa fez em média 10,5 pontos de 14; SearXNG, cerca de 3
- 1 de nov. de 2026Camada de proteção MoneyGate barrou os 42 pedidos fraudulentos feitos a IAs locais
- 1 de nov. de 2026Tokenizador do BERT na Hugging Face fica 50 vezes mais rápido ao eliminar trabalho desnecessário com ASCII
Perguntas frequentes sobre a notícia
Quais modelos de IA para texto rodam na V100?
O teste usou cinco modelos abertos, incluindo Qwen e Gemma. A velocidade fica entre 38 e 109 tokens por segundo, dependendo do modelo e da quantização.
Dá para usar uma V100 antiga para rodar IA localmente?
Sim. Segundo o teste, a V100 roda LLMs atuais para gerar texto, escrever código e atender a outros cenários reais.
Quantos tokens por segundo a Tesla V100 entrega com modelos locais?
De 38 a 109 tokens por segundo, dependendo do modelo, do tamanho e da quantização.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.