Um laboratório de IA em casa por 200 mil rublos
Há cinco anos, uma Tesla V100 custava 8 mil dólares. Hoje, é vendida por 1.500. Isso quebrou a economia das GPUs na nuvem: comprar o próprio hardware agora sai mais barato do que pagar um mês a um provedor. Veja quais modelos se saem bem na V100, onde a placa tropeça e se o investimento de 200 mil rublos se paga.
Processado por IA de Habr AI; editado por Hamidun News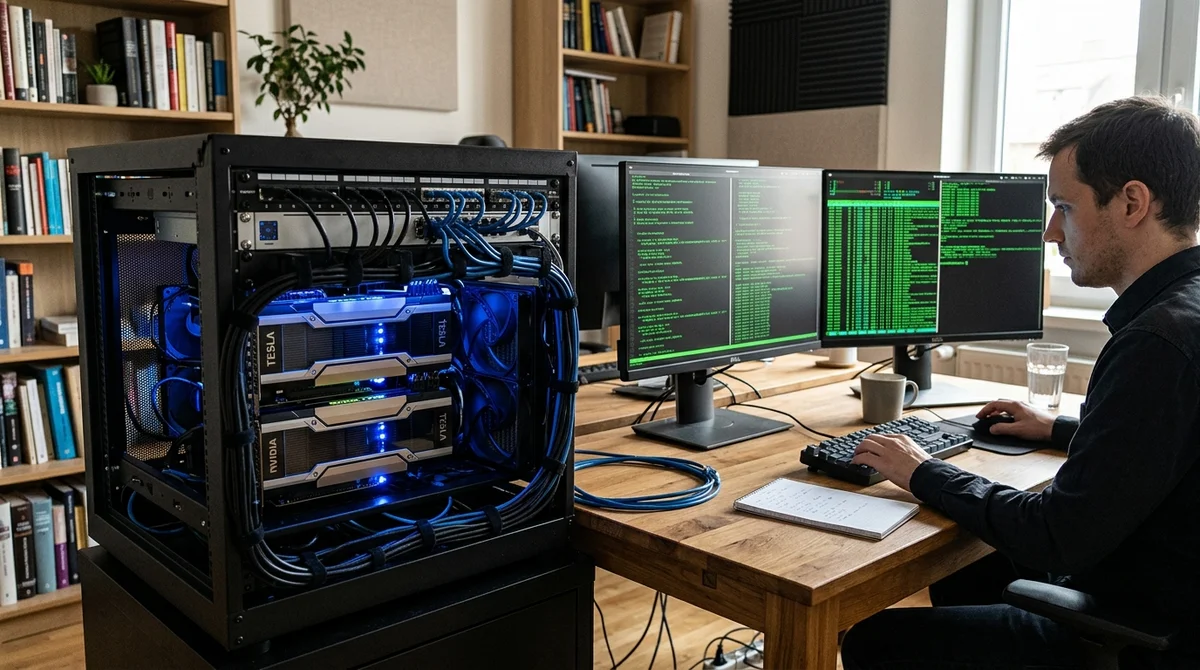
A Tesla V100 custava 8 mil dólares em 2017. Hoje, é vendida no mercado de usados por 1.500. Esse número quebrou a economia das GPUs na nuvem. Na Amazon ou na Vast.ai, alugar uma V100 custa 0,40-0,80 dólar por hora, ou 300-600 por mês. Compre duas V100, monte um servidor por 200 mil rublos e ele se paga em seis meses. O autor do teste comprou exatamente isso e testou 128 redes neurais diferentes, de LLMs pequenos a geradores de vídeo. Eis o resultado.
Por que a V100 é tão barata?
A Tesla V100 é uma placa profissional para data centers, lançada em 2017. Tem 32 GB de memória, 235 TFLOPS em meia precisão e TDP de 125 W. Foi produzida em quantidades enormes e, depois, chegou a A100. As fazendas de nuvem liquidaram as V100 antigas por quase nada. Mineradores individuais e startups compraram o que sobrou. Agora o mercado de usados está lotado dessas placas, e o preço caiu ainda mais. O chip está defasado em capacidade bruta, mas para inferência é ideal.
Onde a V100 tropeça?
Sendo honesto: a V100 engasga no TensorFlow (a otimização de cálculos limitados pela CPU é fraca). A geração de vídeo leva cinco minutos no Flux.1, e a espera seria exasperante. Gera texto razoavelmente bem, mas não rápido: o Llama 2 70B entrega 80 tokens por segundo em int4. Para comparação, uma A100 na nuvem chega a mais de 300. Há ressalvas de memória também: 32 GB bastam para a maioria dos modelos, mas não dá para rodar dois modelos de 70 bilhões de parâmetros ao mesmo tempo.
Benchmarks reais
- Mistral 7B: 200 tokens/s (int4)
- Llama 2 70B: 80 tokens/s (int4)
- Stable Diffusion 1.5: 0,8 segundo por imagem
- Stable Diffusion XL: 2,5 segundos
- Whisper Large: 0,3 do tempo real (um áudio de 60 minutos em 18 minutos)
- Flux.1: 300 segundos em 1024×1024
Economia: nuvem ou hardware próprio?
As GPUs na nuvem (Lambda, Vast.ai) custam 0,40-0,80 $/hora pela V100. O aluguel mensal fica entre 300 e 600 dólares. Nosso servidor se paga em 4-6 meses de uso. Vantagens do local: a eletricidade é mais barata que o tráfego para a nuvem, controle total e nenhuma latência. Desvantagens: a responsabilidade pelo hardware, pela refrigeração e pelos upgrades fica toda com você.
O que isso significa
Um servidor de IA local não substitui a nuvem, mas a complementa. Se você roda modelos todos os dias, já testou sua ideia e sabe quais redes neurais precisa, um servidor de 200 mil rublos economiza dezenas de milhares por ano e dá controle final sobre a infraestrutura.
- 1 de nov. de 2026Camada de proteção MoneyGate barrou os 42 pedidos fraudulentos feitos a IAs locais
- 31 de out. de 2026Gateway de LLM open source KTMS 1.0 conecta GPUs próprias à nuvem e sobrevive a falhas
- 31 de out. de 2026LTX-2.5 de 22 bilhões de parâmetros roda em RTX 3080 de 10 GB, mas leva 5 minutos por plano
- 29 de out. de 2026T-Tech cria o método LIMe, que treina modelos de linguagem com 15% menos computação
Perguntas frequentes sobre a notícia
Por que a V100 é tão barata?
A Tesla V100 é uma placa profissional para data centers, lançada em 2017. Tem 32 GB de memória, 235 TFLOPS em meia precisão e TDP de 125 W. Foi produzida em quantidades enormes e, depois, chegou a A100. As fazendas de nuvem liquidaram as V100 antigas por quase nada. Mineradores individuais e startups compraram o que sobrou. Agora o mercado de usados está lotado dessas placas, e o preço caiu ainda mais. O chip está defasado em capacidade bruta, mas para inferência é ideal.
Onde a V100 tropeça?
Sendo honesto: a V100 engasga no TensorFlow (a otimização de cálculos limitados pela CPU é fraca). A geração de vídeo leva cinco minutos no Flux.1, e a espera seria exasperante. Gera texto razoavelmente bem, mas não rápido: o Llama 2 70B entrega 80 tokens por segundo em int4. Para comparação, uma A100 na nuvem chega a mais de 300. Há ressalvas de memória também: 32 GB bastam para a maioria dos modelos, mas não dá para rodar dois modelos de 70 bilhões de parâmetros ao mesmo tempo.
Economia: nuvem ou hardware próprio?
As GPUs na nuvem (Lambda, Vast.ai) custam 0,40-0,80 $/hora pela V100. O aluguel mensal fica entre 300 e 600 dólares. Nosso servidor se paga em 4-6 meses de uso. Vantagens do local: a eletricidade é mais barata que o tráfego para a nuvem, controle total e nenhuma latência. Desvantagens: a responsabilidade pelo hardware, pela refrigeração e pelos upgrades fica toda com você.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.