NVIDIA Developer Blog
Source d'actualités IA. Les articles sont sélectionnés et adaptés par la rédaction de Hamidun News.
Dernières publications
NVIDIA DAQIRI : inférence IA en temps réel pour l'acquisition de données à haute vitesse
NVIDIA a présenté DAQIRI, un framework qui intègre l'IA directement dans le flux de données des capteurs et instruments scientifiques, sans latence.
NVIDIA dévoile Halos, un système de sécurité fonctionnelle pour les robots dotés d'IA
NVIDIA Halos est une pile complète de sécurité fonctionnelle pour l'IA physique : des robots qui travaillent aux côtés des humains dans les usines, les entrepôts et les hôpitaux.
NVIDIA a expliqué comment entraîner des transformers en précision réduite sans perte de qualité
NVIDIA a publié un guide d’optimisation des modèles transformer avec FP8 et BF16 — comment accélérer l’entraînement et réduire l’usage de la mémoire GPU sans perte de précision.
NVIDIA a expliqué comment gérer des agents autonomes dans des usines d'AI d'entreprise
Les agents d'AI ont largement dépassé le cadre du chat : ils travaillent pendant des heures avec des données et des systèmes d'entreprise, et NVIDIA a expliqué en détail comment mettre en place un environnement sûr et gé
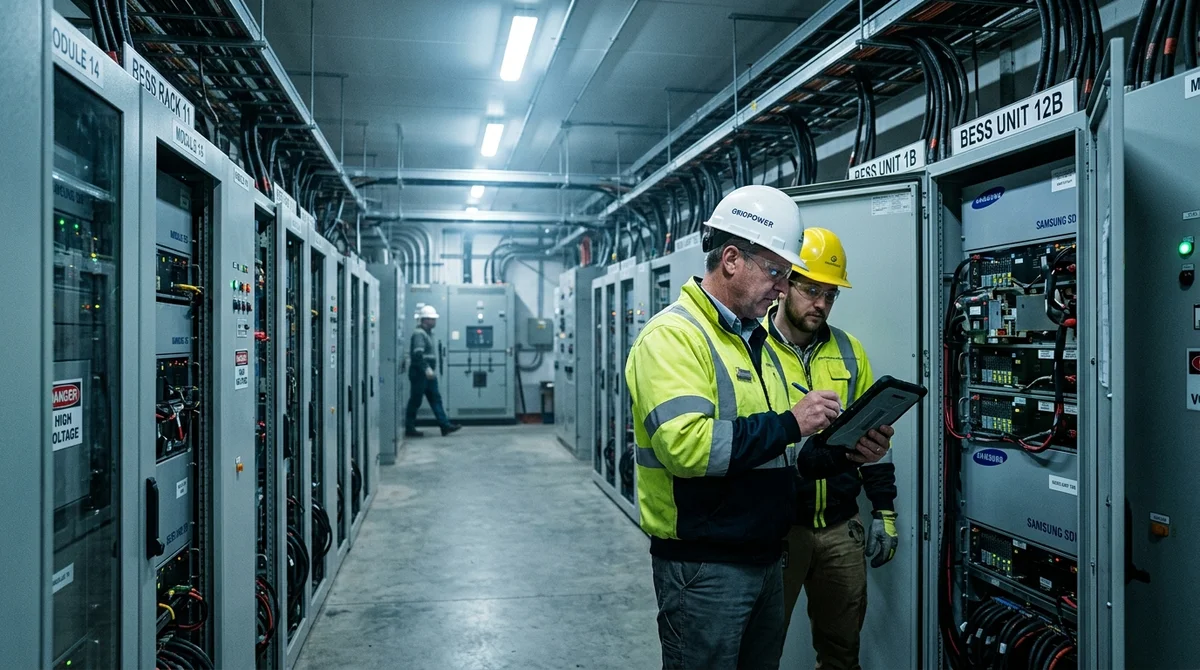
NVIDIA : comment concevoir des systèmes de stockage d'énergie par batterie pour les usines d'AI
NVIDIA a expliqué en quoi les usines d'AI diffèrent des centres de données classiques en matière de consommation d'énergie et a décrit les exigences applicables aux systèmes de stockage d'énergie par batterie (BESS) pour
NVIDIA TensorRT transforme les checkpoints FP8 en moteurs pour une inférence rapide
NVIDIA a expliqué comment convertir un checkpoint quantifié en FP8 en moteur TensorRT — une étape qui transforme un modèle optimisé en véritable outil de production.
NVIDIA JetPack 7.2 : des agents AI sur des appareils en périphérie avec une seule commande de déploiement
NVIDIA a lancé JetPack 7.2 pour la plateforme Jetson — une seule commande CLI déploie une stack complète d'agents avec confidentialité et optimisation de la mémoire.
NVIDIA accélère le préentraînement des LLM : NVFP4 sur Blackwell avec JAX et MaxText
NVIDIA a montré comment le format NVFP4 sur les puces Blackwell, associé à JAX et MaxText, réduit le temps de préentraînement des modèles frontier et les coûts de calcul.
NVIDIA BioNeMo permet d'affiner des modèles d'IA biologique par LoRA en quelques heures
NVIDIA a lancé BioNeMo Recipes, des pipelines prêts à l'emploi pour affiner les modèles de langage ESM2 et Evo 2 avec la méthode LoRA. Il est désormais possible de les spécialiser pour des tâches biologiques avec seuleme
NVIDIA accélère l'inférence sur Blackwell jusqu'à 15 fois avec DFlash Speculative Decoding
NVIDIA a publié la technique DFlash Speculative Decoding pour l'architecture Blackwell : la vitesse d'inférence des modèles de langage a été multipliée par 15 à précision égale.
NVIDIA Explique la Différence Entre VLA et WAM — Deux Approches du Contrôle Robotique
NVIDIA différencie VLA et WAM — deux classes de modèles robotiques : les premiers apprennent du langage, les seconds de la prédiction de la physique du monde. La différence définira l'architecture de l'IA physique.
NVIDIA domine le premier benchmark sectoriel pour agents IA AA-AgentPerf
Artificial Analysis a lancé AA-AgentPerf — le premier standard ouvert multi-fournisseurs pour évaluer la programmation agentica. NVIDIA a assuré la position de leader sur les métriques clés.
Google DeepMind présente DiffusionGemma pour la génération rapide de texte sur NVIDIA
Google DeepMind a optimisé le nouveau modèle DiffusionGemma pour les plateformes NVIDIA afin d'accélérer la génération de texte en temps réel dans les chats, copilotes et agents.
NVIDIA MCG Toolkit automatise la documentation des modèles d'AI pour les nouvelles réglementations
NVIDIA présente un outil d'automatisation de la documentation des modèles d'AI, qui aide les équipes à répondre aux exigences réglementaires comme l'EU AI Act et à créer des model cards vérifiables sans travail manuel.
NVIDIA présente DynoSim pour optimiser les paramètres du service LLM
NVIDIA présente DynoSim, un outil pour optimiser automatiquement la configuration du service des grands modèles de langage par simulation de la frontière de Pareto.
NVIDIA RTX présente DLSS 4.5 et des personnages IA multilingues pour les jeux
NVIDIA a présenté une mise à jour RTX avec support des personnages IA multilingues via ACE et le nouveau DLSS 4.5 pour Unreal Engine, simplifiant le développement de jeux avec l'IA.
Le nouveau CompileIQ de NVIDIA découvre le potentiel caché des cœurs GPU grâce à l'ajustement des paramètres du compilateur
NVIDIA a présenté CompileIQ — un outil basé sur l'IA qui sélectionne automatiquement les paramètres optimaux du compilateur pour maximiser les performances des cœurs GPU, découvrant des accélérations là où l'optimisation
NVIDIA Blackwell établit un record STAC-AI dans le trading AI financier
L'architecture NVIDIA Blackwell a démontré les meilleures performances au test STAC-AI pour l'IA financière, traitant un volume de données plus important plus rapidement que tous ses concurrents.
NVIDIA Dynamo Snapshot: accélération du lancement des modèles sur Kubernetes
NVIDIA a présenté un outil pour réduire le temps de chargement des modèles d'inférence sur Kubernetes de minutes à secondes — une solution pour éviter la perte de capacité GPU lors de pics de trafic.
StepFun présente Step 3.7 Flash sur GPU NVIDIA pour le travail multimodal
StepFun lance Step 3.7 Flash — un modèle d'IA multimodal avec 198 milliards de paramètres, qui traite simultanément du texte, des images, de la vidéo et des documents sur les accélérateurs NVIDIA.
NVIDIA RTX PRO 4500 Blackwell : accélération de la génomique et de la modélisation des protéines
NVIDIA a lancé la carte graphique RTX PRO 4500 Blackwell pour accélérer les calculs génomiques et la modélisation des protéines — des composants clés de la médecine de précision.
NVIDIA CUDA 13.3 simplifie le développement GPU avec Tile programming en C++
NVIDIA a lancé CUDA 13.3 avec Tile programming en C++, qui automatise l'optimisation des opérations mémoire GPU bas niveau pour les développeurs.
NVIDIA a ajouté CUDA Tile pour optimiser les noyaux GPU en C++
NVIDIA a présenté la technologie CUDA Tile intégrée en C++ pour développer des noyaux GPU haute performance basés sur une approche orientée tuiles.
NVIDIA Aide les Opérateurs Télécom à Déployer des Usines d'IA Souveraines avec Token-Metering
Les opérateurs télécom construisent des infrastructures d'IA souveraines sur l'architecture NVIDIA Cloud Partner, utilisant le token-metering pour un accès contrôlé—une approche vers des services scalables à marges élevé
NVIDIA GB200: Calcul à l'échelle exascalaire dans un rack par ordonnancement intelligent des tâches
NVIDIA a démontré comment maximiser les performances du GB200 NVL72 grâce à Slurm avec une connaissance de la topologie réseau—les résultats montrent un calcul à l'échelle exascalaire sur un seul rack.
NVIDIA Explique Comment Suivre les GPUs dans les Clusters Kubernetes
La plupart des équipes sous-utilisent les GPUs dans les clusters Kubernetes parce qu'elles ne voient tout simplement pas qui les utilise, combien de mémoire est consommée et si les conteneurs sont bloqués.
NVIDIA a montré comment les systèmes multi-agents trouvent des signaux sur les marchés financiers
Les systèmes multi-agents d'IA aident les chercheurs à automatiser la recherche de signaux de trading dans les données de marché en analysant les prix, les indicateurs économiques et les sources alternatives pour identif
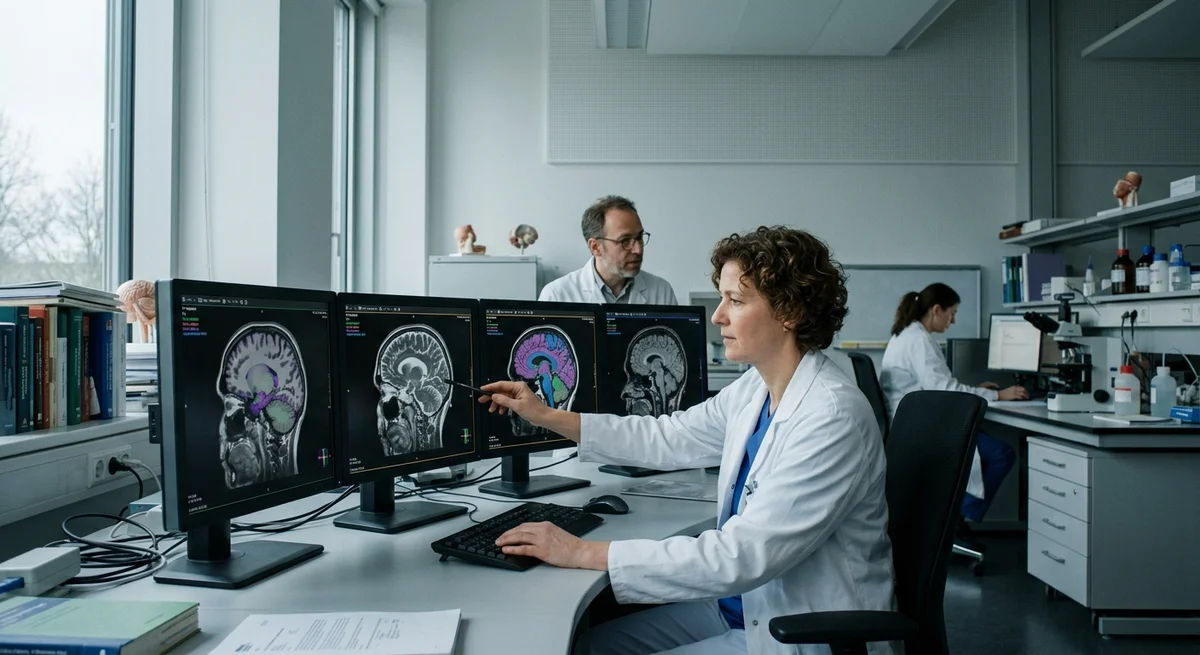
NVIDIA dévoile un outil de génération d'images médicales 3D
NVIDIA a présenté NV-Generate-CTMR pour synthétiser automatiquement des images médicales 3D réalistes, résolvant la pénurie de données en radiologie et accélérant l'entraînement de modèles IA généralisés.
NVIDIA Vera Rubin : comment les développeurs pourront mettre à l'échelle l'IA d'agent sans latence
NVIDIA présente Vera Rubin, une plateforme pour l'IA d'agent qui combine GPU Vera Rubin NVL72 et accélérateur Groq 3 LPX pour atteindre 400 tokens/sec sur les modèles trillion-paramétriques.
NVIDIA a montré la différence entre l'évaluation des modèles et l'évaluation des agents IA
Les benchmarks de modèles et l'évaluation d'agents résolvent des tâches différentes : les premiers testent la compréhension du langage, les seconds — le comportement réel du système en action.