NVIDIA distingue l'évaluation des modèles de celle des agents IA
NVIDIA met en avant une différence de fond dans l'évaluation des systèmes d'IA. Le benchmark d'un modèle vérifie la compréhension du langage et la capacité à résoudre des tâches statiques. Évaluer un agent est tout autre chose : il faut tester son comportement de bout en bout, avec planification, appels d'outils et fonctionnement en situation d'incertitude.
Traité par IA depuis NVIDIA Developer Blog ; édité par Hamidun News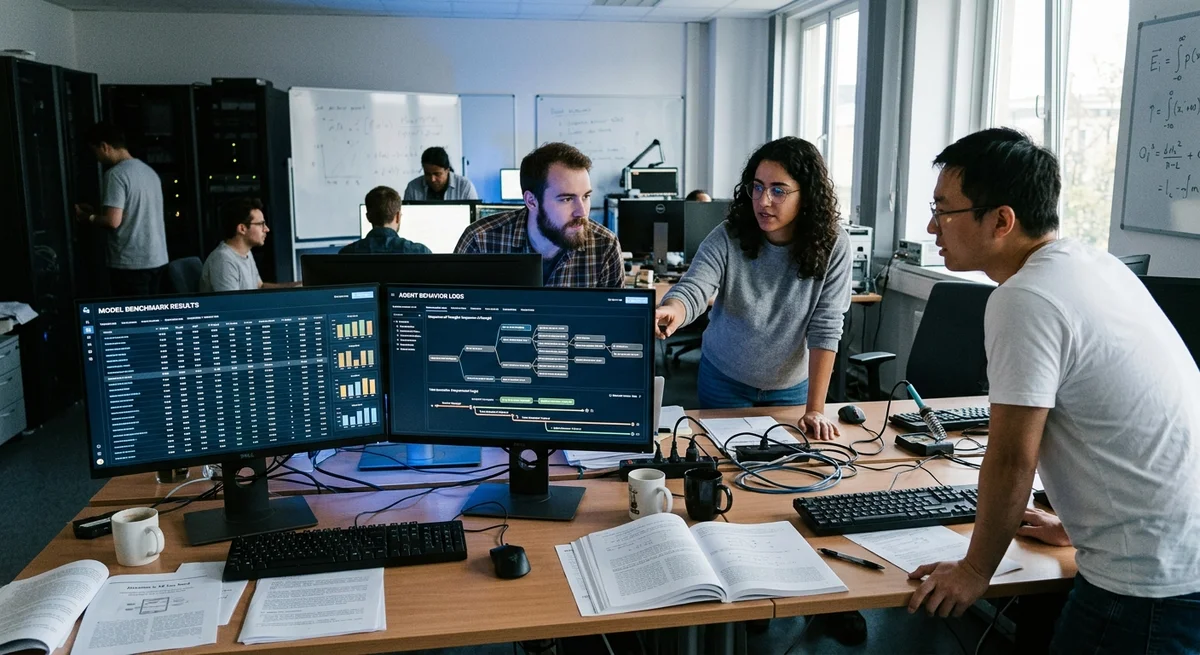
Évaluer un modèle d'IA et évaluer un agent d'IA sont deux tâches proches en apparence, mais radicalement différentes. NVIDIA a expliqué sur son blog pourquoi on ne peut pas juger les agents à partir des seules métriques des modèles.
Benchmark de modèle : des tâches statiques
Quand on évalue un modèle de fondation, on utilise des benchmarks : on vérifie dans quelle mesure il comprend le langage, suit des instructions, résout des problèmes de mathématiques ou des énigmes logiques. Ce sont des jeux d'exemples statiques : le modèle reçoit un texte en entrée et doit produire la bonne réponse. Des benchmarks classiques comme MMLU, GSM8K ou HumanEval montrent bien la puissance d'un modèle en tant que tel. Mais ils ne répondent qu'à une question : le système peut-il venir à bout d'une tâche dans des conditions idéales ?
Un agent est un système en action
Un agent, c'est tout autre chose. Ce n'est pas seulement un modèle qui répond à une question. C'est un système qui fonctionne de bout en bout : il reçoit une tâche, planifie des étapes, appelle des outils (navigateur, base de données, API), analyse les résultats, et gère les erreurs et l'incertitude. Même si le modèle est très puissant, un agent construit dessus peut échouer. Pourquoi ?
- La planification peut être erronée : le modèle choisit le mauvais outil
- La boucle de traitement des résultats se grippe : l'agent ne remarque pas une erreur dans la réponse d'un outil
- Incertitude et bruit dans l'environnement : les outils réels fonctionnent de façon instable et les données sont incomplètes
- Sécurité et fiabilité : l'agent peut être « trompé » ou exécuter une action dangereuse
- Efficacité : l'agent peut consommer trop d'étapes pour une tâche simple
Pourquoi c'est crucial pour les développeurs
Comprendre cette différence est important, car évaluer un agent exige des métriques tout à fait différentes. On ne peut pas simplement prendre les résultats d'un benchmark de modèle et les considérer comme l'évaluation finale du système. NVIDIA souligne que les agents nécessitent une évaluation de bout en bout (end-to-end evaluation). Cela signifie qu'il faut lâcher l'agent dans un environnement réel ou semi-réel, lui donner une tâche et voir s'il parvient à la résoudre en tenant compte de toutes les frictions : erreurs d'outils, informations contradictoires, nécessité de replanifier.
Ce que cela signifie
Évaluer correctement les agents devient crucial, car ces systèmes commencent à travailler sur des tâches réelles. Si vous vous fiez uniquement aux benchmarks de modèles, vous risquez de passer à côté de problèmes sérieux dans le comportement de l'agent et de vous y heurter en production.
- 2 nov. 2026Karpathy bâtit en deux heures un clone de YouTube avec 6454 vidéos issues des conseils de Hacker News
- 2 nov. 2026Avec Claude, Andrej Karpathy a assemblé HackerTube : 6454 vidéos recommandées sur Hacker News
- 2 nov. 2026Arca confie à des agents IA des tâches financières pouvant durer jusqu'à 10 jours, mais laisse les transactions aux humains
- 2 nov. 2026DeepSeek ouvre le code d'un prototype de Super-agent : p95 du temps d'exécution de 15,7 min contre 29,5
Questions clés sur cet article
Que sait-on sur Benchmark de modèle : des tâches statiques ?
Quand on évalue un modèle de fondation, on utilise des benchmarks : on vérifie dans quelle mesure il comprend le langage, suit des instructions, résout des problèmes de mathématiques ou des énigmes logiques. Ce sont des jeux d'exemples statiques : le modèle reçoit un texte en entrée et doit produire la bonne réponse. Des benchmarks classiques comme MMLU, GSM8K ou HumanEval montrent bien la puissance d'un modèle en tant que tel. Mais ils ne répondent qu'à une question : le système peut-il venir à bout d'une tâche dans des conditions idéales ?
Que sait-on sur Un agent est un système en action ?
Un agent, c'est tout autre chose. Ce n'est pas seulement un modèle qui répond à une question. C'est un système qui fonctionne de bout en bout : il reçoit une tâche, planifie des étapes, appelle des outils (navigateur, base de données, API), analyse les résultats, et gère les erreurs et l'incertitude. Même si le modèle est très puissant, un agent construit dessus peut échouer. Pourquoi ? La planification peut être erronée : le modèle choisit le mauvais outil La boucle de traitement des résultats se grippe : l'agent ne remarque pas une erreur dans la réponse d'un outil Incert
Pourquoi c'est crucial pour les développeurs?
Comprendre cette différence est important, car évaluer un agent exige des métriques tout à fait différentes. On ne peut pas simplement prendre les résultats d'un benchmark de modèle et les considérer comme l'évaluation finale du système. NVIDIA souligne que les agents nécessitent une évaluation de bout en bout (end-to-end evaluation). Cela signifie qu'il faut lâcher l'agent dans un environnement réel ou semi-réel, lui donner une tâche et voir s'il parvient à la résoudre en tenant compte de toutes les frictions : erreurs d'outils, informations contradictoires, nécessité de r
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.