ICLR 2026 à Rio : ce que pensent les chercheurs du passage à l'échelle des grands modèles
L'ICLR 2026 a réuni fin avril des chercheurs de premier plan à Rio de Janeiro. Lors de la conférence la plus prestigieuse de l'année, les discussions ont porté sur la façon de passer à l'échelle plus efficacement (les puces coûtent de plus en plus cher), sur les dangers de l'IA et les moyens de s'en protéger, et sur la place des modèles ouverts si les géants gardent fermés leurs systèmes les plus puissants. L'AIRI y était et partage ses premières impressions.
Traité par IA depuis Habr AI ; édité par Hamidun News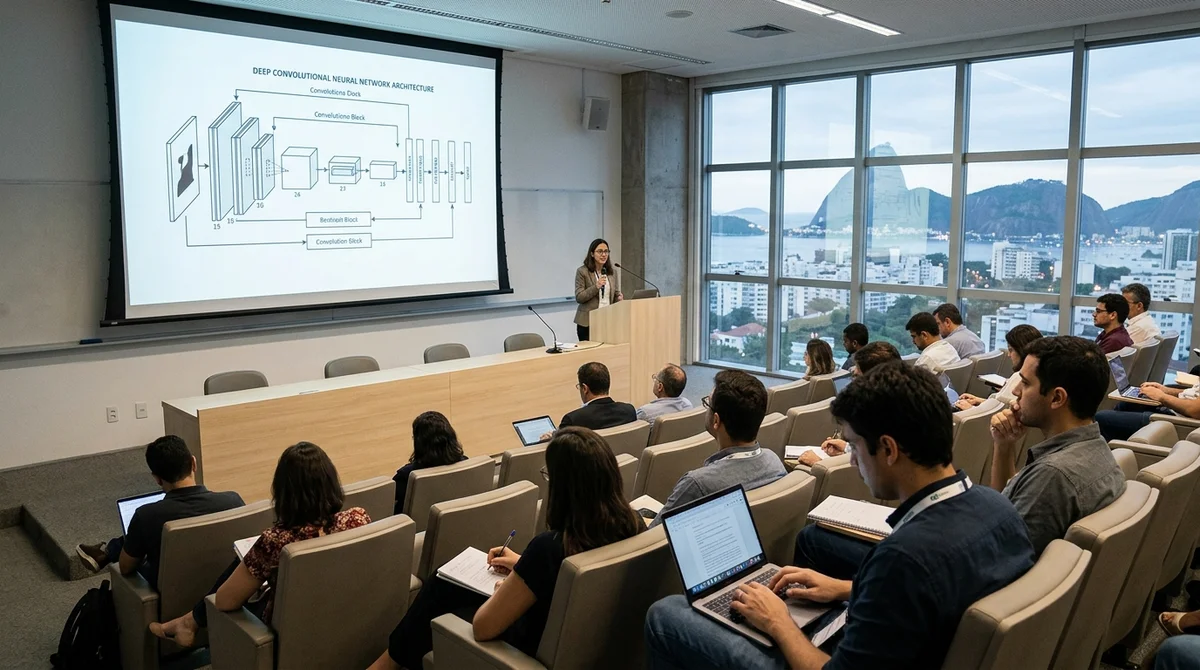
L'ICLR 2026 s'est tenue fin avril à Rio de Janeiro et a confirmé son statut de grand rendez-vous annuel des chercheurs en IA. Pour la communauté scientifique, c'est plus qu'une publication prestigieuse dans une revue : c'est le lieu où naissent et sont mises à l'épreuve des idées qui deviendront, un an plus tard, des standards industriels.
Passer à l'échelle en surveillant l'efficacité
L'ère du « plus de paramètres = meilleur modèle » touche lentement mais sûrement à sa fin. À l'ICLR, on a moins parlé de la taille des nouveaux modèles que du retour sur investissement : investir 100 millions pour gagner 3 %, cela n'a plus de sens économique. Les chercheurs en ont assez de faire semblant que le passage à l'échelle garantit le progrès.
Pourquoi en est-on arrivé là ? Les puces coûtent de plus en plus cher au lieu de baisser. Doubler les paramètres ne double plus les performances. Les entreprises ont commencé à chiffrer honnêtement le coût de l'entraînement d'un modèle de base, auquel s'ajoute le fine-tuning pour chaque tâche spécifique.
- Les contextes longs (200K+ tokens) deviennent un standard plutôt qu'une exotisme
- Les ingénieurs optimisent la vitesse d'inférence et l'efficacité énergétique, pas seulement la taille des poids
- Des méthodes de mise à l'échelle dynamique du calcul en fonction des données d'entrée apparaissent
- Les modèles à mélange d'experts (MoE) supplantent les architectures denses classiques
Un changement d'état d'esprit était perceptible à la conférence : les chercheurs parlent de long-lived foundation models, des modèles qui vivent longtemps et s'améliorent par itérations. Plutôt que de réentraîner sans cesse depuis zéro, on ajoute de nouvelles données, des adaptateurs spécialisés, de nouvelles couches. C'est moins cher, plus simple en production, et cela devient la nouvelle norme.
La sécurité comme priorité
Il y a eu nettement plus d'interventions sur la sécurité et les garanties qu'un an plus tôt. À l'ICLR 2025, le sujet était marginal. En 2026, il est devenu courant. Les chercheurs estiment qu'il faut entraîner les grands modèles non seulement pour la performance, mais aussi pour la robustesse : résistance aux exemples adversariaux, aux changements de distribution et aux tentatives de manipulation.
«
Nous ne pouvons plus publier un modèle en espérant que personne ne le cassera en conditions réelles » — une position typique des tables rondes de la conférence.
Il ne s'agit pas seulement de réglementation (même si les États imposent de nouvelles exigences). La communauté scientifique elle-même a pris conscience que la course aux résultats SOTA est dangereuse si l'on ne compte pas les coûts réels des dommages.
Poids ouverts dans l'ombre des systèmes d'entreprise
La question la plus tendue de la conférence : l'open source aura-t-il une chance en IA si Anthropic, OpenAI et Meta* gardent fermés leurs modèles les plus avancés ?
À l'ICLR, les avis étaient partagés. Une partie de la communauté scientifique insiste : les modèles ouverts sont une infrastructure critique et il faut les développer malgré les risques. L'autre est déjà réaliste : les meilleurs modèles reviendront aux grandes entreprises, qui ont les ressources pour l'entraînement et des comptes à rendre aux investisseurs. La science ouverte pourrait rester dans un rôle de soutien, en développant la méthodologie sans tenir la ligne de front.
Ce que cela signifie
L'ICLR 2026 a montré que l'ère de la croissance exponentielle par la taille touche à sa fin, mais l'IA ne ralentit pas : elle change de direction. Une ère d'optimisation systémique s'annonce : mieux utiliser les ressources, rendre les modèles plus fiables, permettre à la science ouverte de rester pertinente.
Pour les startups et les ingénieurs, cela signifie que l'avantage concurrentiel ne réside plus dans l'entraînement d'un modèle encore plus gros, mais dans le déploiement des modèles existants à moindre coût, plus vite et plus sûrement.
*Meta a été classée organisation extrémiste et est interdite en Russie.
- 1 nov. 2026Les modèles locaux battus par Opus et Codex : 0,21 sur MacBook contre 1,00 pour Codex
- 1 nov. 2026Kimi obtient 96,2 % à un test d'analytique sur une base 1C et s'impose comme solution de repli en cas de blocage de Claude
- 1 nov. 2026OpenAI réécrit les règles de comportement de GPT : cinq valeurs et une chaîne de priorités
- 1 nov. 2026Google reconnaît que l'AI Mode réduit les revenus de la recherche, l'action chute de 15%
Questions clés sur cet article
Que sait-on sur Passer à l'échelle en surveillant l'efficacité ?
L'ère du « plus de paramètres = meilleur modèle » touche lentement mais sûrement à sa fin. À l'ICLR, on a moins parlé de la taille des nouveaux modèles que du retour sur investissement : investir 100 millions pour gagner 3 %, cela n'a plus de sens économique. Les chercheurs en ont assez de faire semblant que le passage à l'échelle garantit le progrès. Pourquoi en est-on arrivé là ? Les puces coûtent de plus en plus cher au lieu de baisser. Doubler les paramètres ne double plus les performances. Les entreprises ont commencé à chiffrer honnêtement le coût de l'entraînement d'
Que sait-on sur La sécurité comme priorité ?
Il y a eu nettement plus d'interventions sur la sécurité et les garanties qu'un an plus tôt. À l'ICLR 2025, le sujet était marginal. En 2026, il est devenu courant. Les chercheurs estiment qu'il faut entraîner les grands modèles non seulement pour la performance, mais aussi pour la robustesse : résistance aux exemples adversariaux, aux changements de distribution et aux tentatives de manipulation. « Nous ne pouvons plus publier un modèle en espérant que personne ne le cassera en conditions réelles » — une position typique des tables rondes de la conférence. Il ne s'agit pas
Que sait-on sur Poids ouverts dans l'ombre des systèmes d'entreprise ?
La question la plus tendue de la conférence : l'open source aura-t-il une chance en IA si Anthropic, OpenAI et Meta gardent fermés leurs modèles les plus avancés ? À l'ICLR, les avis étaient partagés. Une partie de la communauté scientifique insiste : les modèles ouverts sont une infrastructure critique et il faut les développer malgré les risques. L'autre est déjà réaliste : les meilleurs modèles reviendront aux grandes entreprises, qui ont les ressources pour l'entraînement et des comptes à rendre aux investisseurs. La science ouverte pourrait rester dans un rôle de souti
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.