Les LLM peuvent-ils repérer les tests flaky à partir du code ? Une étude répond non
Une étude a vérifié si les LLM peuvent trouver les tests flaky, ces tests qui échouent sans cause apparente. Le résultat est décevant : de bonnes métriques sur un jeu de données ne signifient pas que le modèle comprend réellement la nature du problème. C'est un exemple typique de la raison pour laquelle on ne peut pas se fier aux seuls chiffres.
Traité par IA depuis Habr AI ; édité par Hamidun News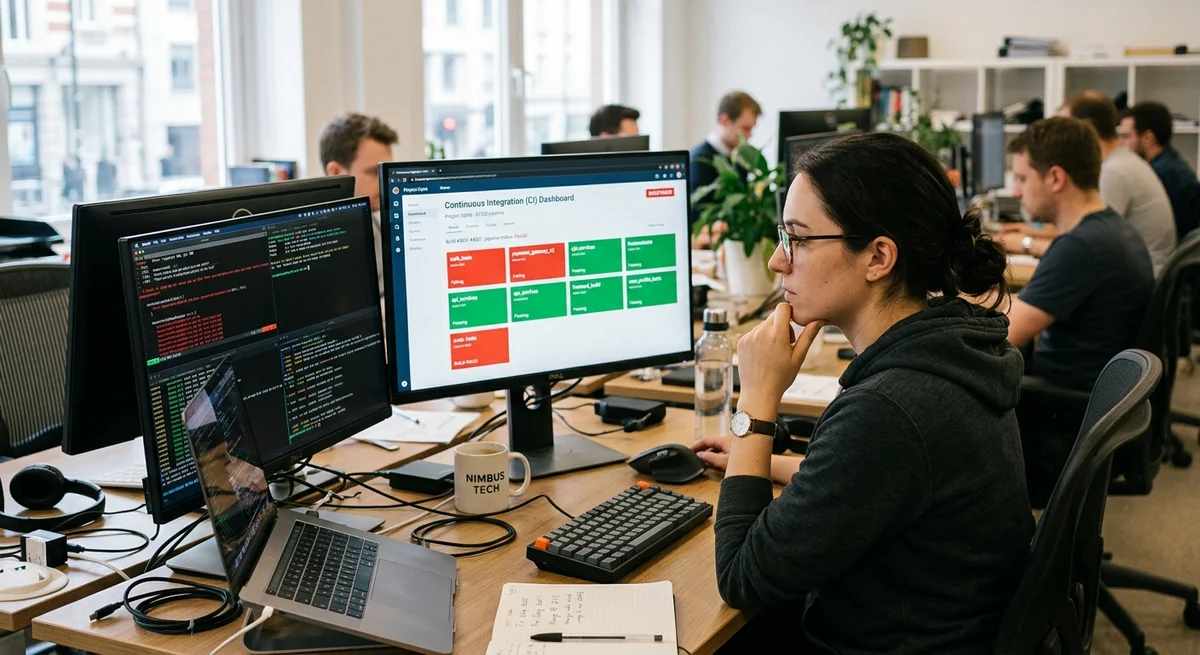
Les tests flaky sont des tests qui échouent parfois et réussissent parfois, sans raison visible. Ils cassent la CI/CD, obligent à refaire le travail et sapent la confiance dans les tests automatisés. Des chercheurs ont décidé de confier le problème aux LLM : un réseau de neurones pourrait-il comprendre le code et repérer les tests suspects ? Les résultats ont déçu.
Pourquoi les tests flaky sont un ennemi si redoutable
Un test peu fiable n'est pas qu'un simple bug. Quand un test échoue à des moments aléatoires, les ingénieurs cessent de lui faire confiance. Ils refont le travail, relancent le pipeline et passent des heures à déboguer. Un bug classique se reproduit ; un test flaky ne se reproduit que le lundi à 3 h 43 du matin. Cela tue la vitesse de développement.
Les sources des tests flaky sont variées et souvent cachées :
- Race conditions et problèmes de timing
- Dépendances à l'état de la base de données ou du système de fichiers
- Tests mal isolés qui s'influencent mutuellement
- Code asynchrone sans waits corrects
- Timeouts rigides qui ne supportent pas la surcharge du serveur
Comment les chercheurs ont testé les LLM
L'équipe a pris plusieurs LLM et leur a posé une question simple : voici le code d'un test, est-il flaky ? Les modèles ont examiné le code source, tenté de reconnaître des motifs (logique de retry, sleep, isolation faible) et renvoyé une probabilité de problème.
Sur un jeu de données contrôlé, les résultats paraissaient excellents : les modèles atteignaient plus de 85 % de précision. La precision et le recall étaient bons, et les courbes ressemblaient à celles de tout projet de ML réussi. Le problème semblait résolu.
Mais voici le paradoxe : quand les chercheurs ont appliqué les mêmes modèles à des tests réels issus d'autres projets, l'effet a presque disparu. La précision a chuté et les faux positifs ont augmenté. Le modèle n'avait manifestement pas compris la nature du comportement flaky.
Pourquoi les métriques ne valent pas compréhension
C'est un piège classique du machine learning, qu'on oublie entre la lecture d'articles sur de nouveaux modèles et le travail réel. Un modèle peut apprendre des corrélations dans un jeu de données, mais cela ne veut pas dire qu'il en a compris la cause. Par exemple, si tous les tests flaky du jeu d'entraînement contenaient Thread.sleep(), le modèle signalera comme suspect tout test utilisant cette fonction, même si le sleep sert correctement à la synchronisation.
Pour les tests flaky, le problème est aigu : chaque projet a ses propres schémas de défaillance. Ce qui casse dans une architecture de microservices peut être tout à fait normal dans une application mono-thread. Les modèles ont été entraînés sur une seule tranche de données et ne voient ni le contexte de l'environnement, ni les versions des frameworks, ni les particularités de l'infrastructure.
De bonnes métriques sur le jeu de test sont une condition nécessaire, mais non suffisante.
Il faut une vraie validation sur des exemples en production.
Ce que cela signifie
Les LLM sont un outil puissant, mais pas magique. Pour des problèmes spécialisés comme la recherche de tests flaky, il faut soit davantage de contexte (historique des échecs, métadonnées sur l'environnement, informations de charge), soit une approche hybride (LLM + analyse statique + suivi des échecs en production).
La morale est simple : ne vous fiez pas qu'aux métriques. Les tâches spécifiques exigent une approche spécifique.
Questions clés sur cet article
Pourquoi les tests flaky sont un ennemi si redoutable?
Un test peu fiable n'est pas qu'un simple bug. Quand un test échoue à des moments aléatoires, les ingénieurs cessent de lui faire confiance. Ils refont le travail, relancent le pipeline et passent des heures à déboguer. Un bug classique se reproduit ; un test flaky ne se reproduit que le lundi à 3 h 43 du matin. Cela tue la vitesse de développement.
Comment les chercheurs ont testé les LLM?
L'équipe a pris plusieurs LLM et leur a posé une question simple : voici le code d'un test, est-il flaky ? Les modèles ont examiné le code source, tenté de reconnaître des motifs (logique de retry, sleep, isolation faible) et renvoyé une probabilité de problème. Sur un jeu de données contrôlé, les résultats paraissaient excellents : les modèles atteignaient plus de 85 % de précision. La precision et le recall étaient bons, et les courbes ressemblaient à celles de tout projet de ML réussi.
Pourquoi les métriques ne valent pas compréhension?
C'est un piège classique du machine learning, qu'on oublie entre la lecture d'articles sur de nouveaux modèles et le travail réel. Un modèle peut apprendre des corrélations dans un jeu de données, mais cela ne veut pas dire qu'il en a compris la cause. Par exemple, si tous les tests flaky du jeu d'entraînement contenaient Thread.sleep(), le modèle signalera comme suspect tout test utilisant cette fonction, même si le sleep sert correctement à la synchronisation.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.