Comment éviter la fuite de données en machine learning : le target encoding
Le target encoding semble un moyen simple de traiter les variables catégorielles, mais une implémentation naïve injecte discrètement la cible dans le jeu d'entraînement. Les métriques de validation sont excellentes, mais le modèle ne fonctionne pas en production. Cet article explique d'où vient la fuite (leakage) et présente des implémentations correctes avec Leave-One-Out et K-Fold, pour obtenir un résultat honnête plutôt que de jolis chiffres sur un tableau de bord.
Traité par IA depuis Habr AI ; édité par Hamidun News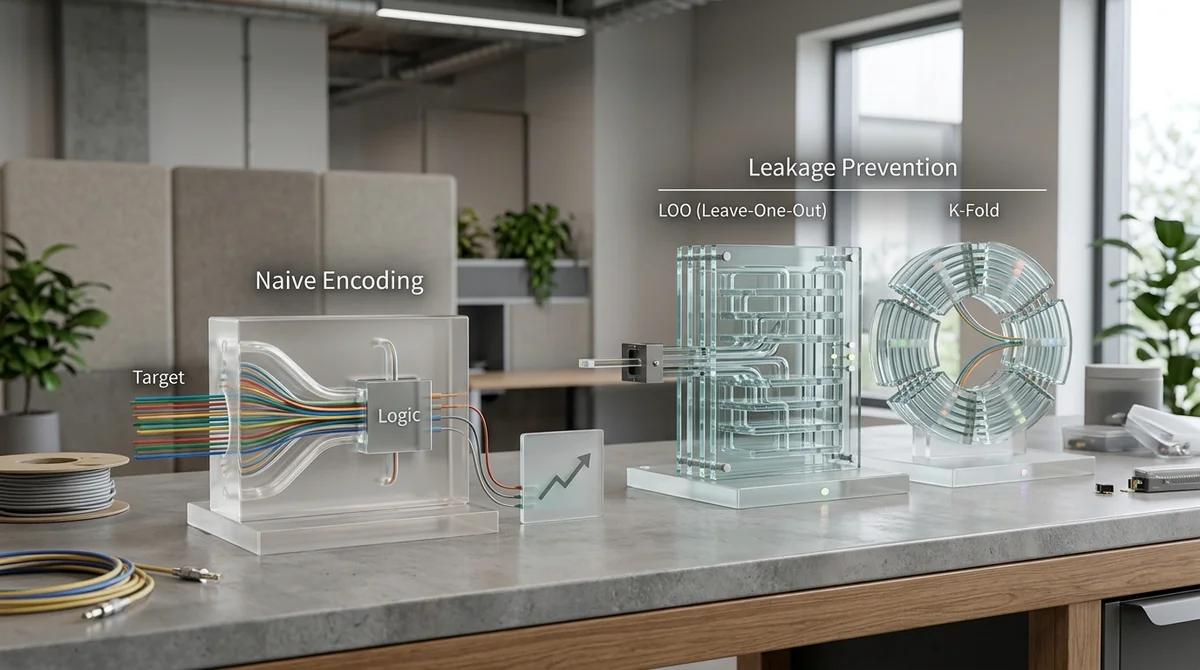
Le target encoding est une méthode de machine learning pour encoder les variables catégorielles, mais son implémentation naïve provoque systématiquement une fuite de données et gonfle les métriques du modèle lors des tests, avant que celui-ci ne s'effondre en production.
Qu'est-ce que le target encoding en machine learning ?
Le target encoding remplace chaque valeur unique d'une variable catégorielle par la moyenne de la variable cible pour cette catégorie. Par exemple, chaque ville se voit attribuer la valeur moyenne des ventes auprès des clients de cette ville.
Ship AI Faster with Founders, Engineers & Weekly Architecture Reviews
Inside Vibe Club (hamidun.com/club) — weekly live masterminds with Zhemal Khamidun, Tech Radar, full LMS access, and 370+ production Claude Code skills.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.