Habr AI détaille une caméra virtuelle pour Shorts et Reels avec suivi du visage
Habr AI a publié une analyse détaillée d'une caméra virtuelle pour Shorts et Reels. Plutôt qu'un simple recadrage automatique, l'auteur a monté un pipeline de production avec une cascade de détecteurs, un suivi du visage, un filtrage anti-jerk et un modèle physique du mouvement de la caméra. Résultat : le cadre vertical ne se comporte pas comme un recadreur saccadé, mais comme un opérateur doté d'inertie et d'un mode de repli. Une transition douce de type Ken Burns est aussi prévue lorsque le visage disparaît du cadre.
Traité par IA depuis Habr AI ; édité par Hamidun News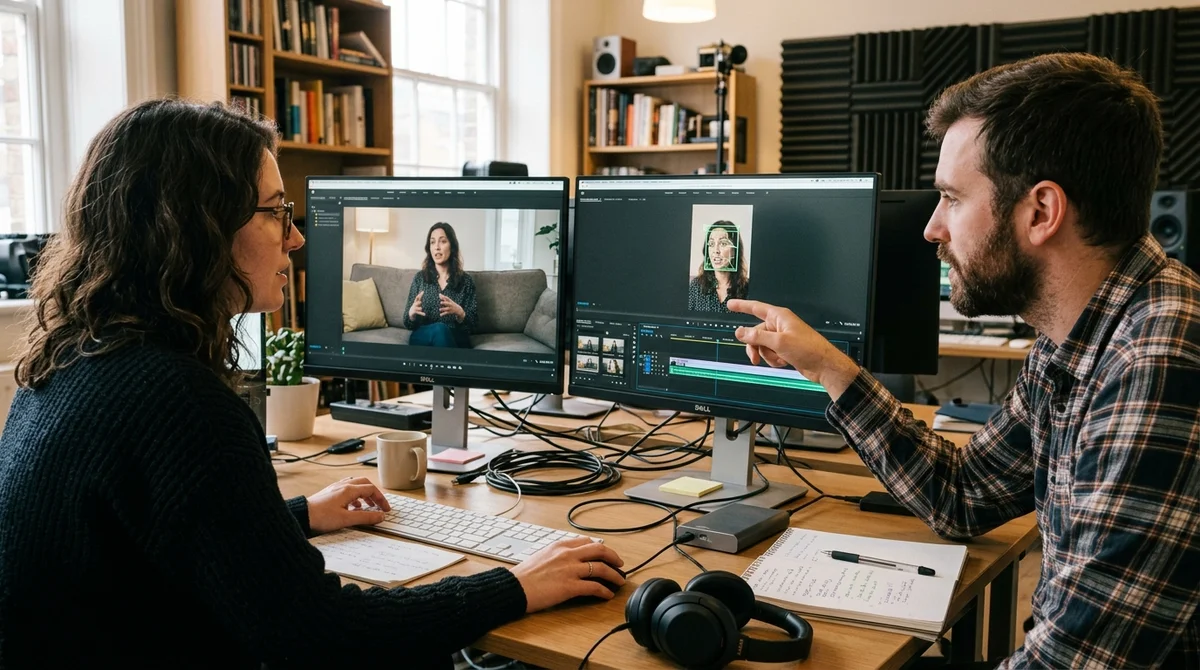
Habr AI a publié une analyse détaillée d'une caméra virtuelle pour la vidéo verticale, qui transforme un clip horizontal ordinaire en Shorts ou Reels sans recadrage automatique saccadé. L'auteur décrit un pipeline de production où la caméra suit le visage dans le cadre non pas à partir d'une seule boîte englobante, mais comme un système dynamique à part entière.
Pourquoi le recadrage automatique échoue
Sur le papier, la tâche semble simple : prendre l'image source en 16:9, en extraire une fenêtre 9:16 et garder la personne au centre. Dans une vraie vidéo, cette approche s'effondre vite. Le visage peut partir à gauche ou à droite, une deuxième personne peut entrer dans le cadre, et le détecteur lui-même tantôt produira du bruit, tantôt perdra sa cible lors d'un mouvement de tête, d'un reflet ou d'un geste. Résultat : le clip vertical finit par ressembler à un vieil autofocus, avec une image qui saute nerveusement et se trompe sans cesse de composition.
L'auteur propose d'aborder le problème non comme un recadrage automatique, mais comme une caméra virtuelle dotée de sa propre inertie, d'une limite de vitesse, d'un délai de réaction et d'une logique de repli. Il ne suffit donc pas que le système « suive le centre de la boîte ». Il doit fonctionner dans la durée, tolérer des données imprécises, ne pas paniquer lors de brèves pertes du visage et conserver un mouvement cohérent même dans des scènes sans aucun visage dans le cadre. C'est crucial pour les longs segments.
«
Une caméra n'est pas une coordonnée, mais un système dynamique ».
Comment fonctionne le pipeline
La base de la solution est une chaîne de détection de visages à trois niveaux : MediaPipe → YuNet → Haar Cascade. Le premier détecteur est la solution principale, le deuxième sert de backend ONNX de secours via OpenCV, et le troisième reste la dernière ligne de défense lorsque tout le reste est indisponible ou a mal fonctionné. En sortie, la chaîne fournit un format de données unique : centre du visage, taille, confidence et bounding box. Du coup, le reste du système ne dépend pas d'un détecteur précis et peut fonctionner de façon stable, même en mode dégradé.
Par-dessus la détection vient un suivi simple mais pratique : le système compare le centre du visage de l'image précédente aux candidats actuels et choisit l'objet le plus proche. Si le visage disparaît brièvement, un grace period s'active : la caméra fait confiance un court instant à la dernière position connue pour ne pas sursauter sur une erreur isolée. Ensuite, le signal est nettoyé en deux étapes supplémentaires et reçoit un fallback distinct pour les scènes sans visage dans le clip.
- Anti-jerk écrête les sauts de coordonnées trop importants entre images
- Low-pass filter lisse le bruit résiduel et les micro-tremblements
- Ken Burns fallback reprend la scène si le visage est perdu ou absent
- Interpolation de trajectoire transforme l'analyse à 8 FPS en mouvement fluide pour les 30 ou 60 FPS finaux
À l'étape finale, le système ne se contente pas de stocker des états discrets de la caméra : il construit une trajectoire continue. Ensuite, pour chaque image, il prend le centre et le zoom, calcule la ROI, découpe la zone voulue et la met à l'échelle au format vertical final. Le pipeline reste ainsi raisonnable en calcul : l'analyse peut se faire sur une copie réduite de la vidéo, et le recadrage final sur l'original, sans perte de fluidité dans le rendu final.
Comment la caméra devient un opérateur
La partie la plus intéressante est le modèle de mouvement. Au lieu de sauter instantanément vers le point cible, la caméra est décrite comme un oscillateur amorti : elle possède une « masse », une raideur, un amortissement, des limites d'accélération et une vitesse maximale. Ce schéma apporte de l'inertie et rend le déplacement crédible. Si la personne se met à bouger plus vite, on peut ajouter un predictive lead pour que la caméra regarde légèrement en avant au lieu de seulement rattraper la cible. Paradoxalement, un petit retard artificiel, le human lag, améliore aussi le résultat : une réaction parfaitement exacte paraît souvent moins naturelle qu'une réaction un peu ralentie.
Par-dessus la physique, l'auteur superpose des règles de composition. La caméra sait décaler le visage vers les lignes des tiers, remonter le point d'attention près du niveau des yeux, ignorer les micromouvements à l'intérieur d'une dead zone et laisser une face margin de sécurité pour ne pas couper les oreilles, les cheveux et les gestes sur les bords du cadre. Pour les scènes de talking head, un mode single-face distinct offre une vitesse plus prudente et une stabilisation renforcée ; pour les clips sans visage, une transition douce vers un Ken Burns avec panoramique et zoom remplace le centre « figé ».
Ce que cela signifie
Cette analyse montre bien où vont les outils de montage vidéo par IA. La qualité ne naît pas d'un seul modèle « magique », mais d'un assemblage d'ingénierie : détecteurs de secours, suivi, filtrage, physique du mouvement et composition travaillent ensemble. Pour les créateurs de contenu et les équipes qui découpent en masse de longues vidéos en Shorts et Reels, ce n'est plus un recadrage automatique jouet, mais un modèle pratique de caméra de production, reproductible et adaptable à différents styles de tournage.
Questions clés sur cet article
Pourquoi le recadrage automatique échoue?
Sur le papier, la tâche semble simple : prendre l'image source en 16:9, en extraire une fenêtre 9:16 et garder la personne au centre. Dans une vraie vidéo, cette approche s'effondre vite. Le visage peut partir à gauche ou à droite, une deuxième personne peut entrer dans le cadre, et le détecteur lui-même tantôt produira du bruit, tantôt perdra sa cible lors d'un mouvement de tête, d'un reflet ou d'un geste. Résultat : le clip vertical finit par ressembler à un vieil autofocus, avec une image qui saute nerveusement et se trompe sans cesse de composition. L'auteur propose d'a
Comment fonctionne le pipeline?
La base de la solution est une chaîne de détection de visages à trois niveaux : MediaPipe → YuNet → Haar Cascade. Le premier détecteur est la solution principale, le deuxième sert de backend ONNX de secours via OpenCV, et le troisième reste la dernière ligne de défense lorsque tout le reste est indisponible ou a mal fonctionné. En sortie, la chaîne fournit un format de données unique : centre du visage, taille, confidence et bounding box. Du coup, le reste du système ne dépend pas d'un détecteur précis et peut fonctionner de façon stable, même en mode dégradé. Par-dessus la
Comment la caméra devient un opérateur?
La partie la plus intéressante est le modèle de mouvement. Au lieu de sauter instantanément vers le point cible, la caméra est décrite comme un oscillateur amorti : elle possède une « masse », une raideur, un amortissement, des limites d'accélération et une vitesse maximale. Ce schéma apporte de l'inertie et rend le déplacement crédible. Si la personne se met à bouger plus vite, on peut ajouter un predictive lead pour que la caméra regarde légèrement en avant au lieu de seulement rattraper la cible. Paradoxalement, un petit retard artificiel, le human lag, améliore aussi le
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.