Le STM32N6 de STMicroelectronics reconnaît la parole en local, sans cloud, avec 0,2 W
Le microcontrôleur STM32N6, doté d'un NPU intégré, a réussi à reconnaître de la parole libre directement sur l'appareil, sans cloud et avec une consommation d'environ 0,215 W. Pour l'instant, seul le modèle acoustique est prêt : il produit des phonèmes en temps réel, tandis que le décodeur et le modèle de langage sont encore en développement. Le projet montre néanmoins que les interfaces vocales locales pour la maison connectée, l'industrie et l'électronique portable deviennent concrètes.
Traité par IA depuis Habr AI ; édité par Hamidun News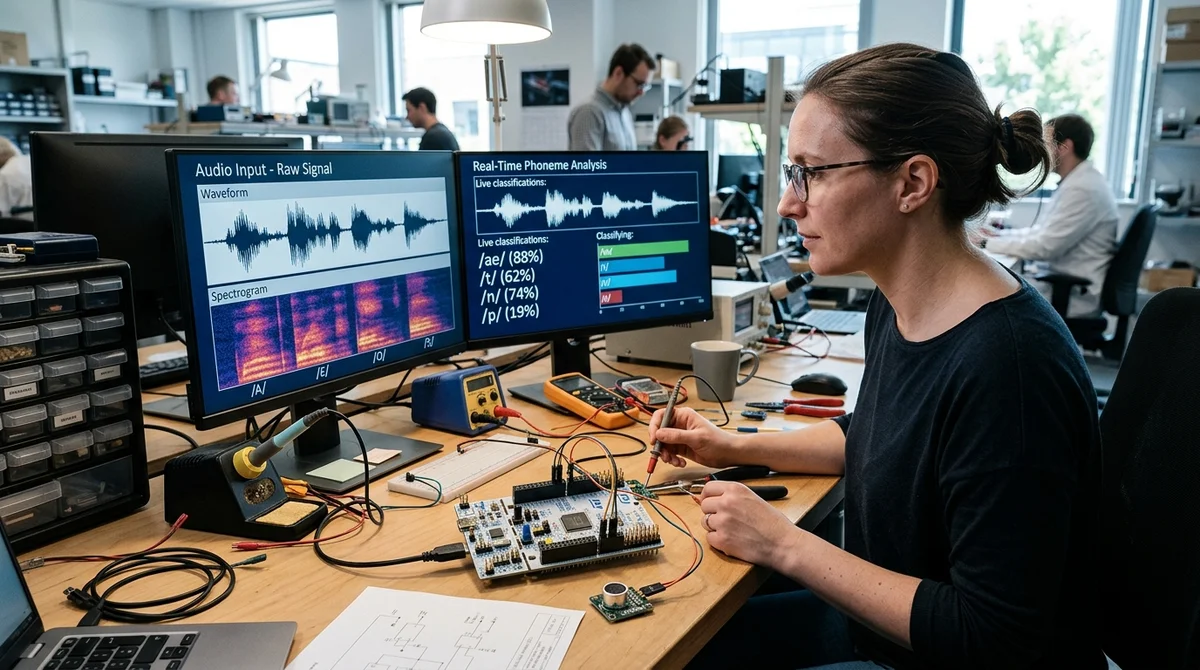
Les microcontrôleurs dotés d'un NPU intégré commencent à s'aventurer sur un terrain qui appartenait jusqu'ici presque entièrement aux services de reconnaissance vocale dans le cloud. Une expérience sur le STM32N6 a montré que la reconnaissance locale de parole libre peut déjà tourner directement sur l'appareil, sans internet, quasiment en temps réel et pour une consommation d'environ 0,215 W.
Comment fonctionne le système
L'auteur du projet a construit la reconnaissance vocale en trois blocs : un modèle acoustique, un décodeur et un module de rescoring. La partie la plus lourde est l'acoustique : elle reçoit le signal audio brut du microphone et le convertit en une séquence de phonèmes. Le décodeur doit assembler des mots à partir de ces phonèmes, et le bloc de rescoring revérifier le résultat en tenant compte du contexte. À ce stade, ce qui tourne déjà sur le STM32N6, c'est le modèle acoustique, c'est-à-dire la fondation de tout le système.
Concrètement, l'appareil écoute la parole en temps réel, la fait passer par le NPU et produit un flux de phonèmes. Dans la démonstration, les mots et les nombres s'affichent en haut, et les phonèmes « bruts » prédits par le modèle en bas. Pour l'instant, la conversion des phonèmes en mots repose sur une correspondance rigide, et non sur un véritable décodeur de langage. Le système reste donc limité, mais le fait que le modèle acoustique fonctionne en local sur un microcontrôleur compte déjà davantage que l'échafaudage actuel qui l'entoure.
Chiffres et limites
Le résultat le plus marquant concerne la consommation. Pendant la reconnaissance active, l'ensemble du système consomme environ 215 mW. Sur ce total, environ 160 mW vont au NPU et au cœur Cortex-M55, 45 mW à la mémoire externe Flash et PSRAM, et environ 10 mW aux broches externes. Et il ne s'agit pas d'un mode optimisé : le cœur n'utilise pas encore de veille agressive et le NPU n'est chargé qu'à 10,4 %, il reste donc de la marge pour réduire encore la consommation.
Côté qualité, le tableau est aussi sérieux pour cette classe de matériel. Le modèle compte 8,5 millions de paramètres, a perdu très peu de précision après quantification en int8 et a atteint sur la cible un PER de 5,3 % sur dev_clean et de 14,4 % sur dev_other. L'inférence sur le NPU a pris 52 ms pour 500 ms d'audio, et la latence totale s'est élevée à 985 ms. Près de la moitié de ce délai ne vient pas du matériel, mais de la « fenêtre sur le futur » que le modèle utilise pour prédire plus précisément les phonèmes.
- Taille du modèle acoustique : 8,5 millions de paramètres
- Consommation pendant la reconnaissance : environ 0,215 W
- Temps d'inférence du NPU : 52 ms pour 500 ms d'audio
- Perte de qualité après quantification en int8 : moins de 0,5 %
- Utilisation de la RAM : 18 %, charge du NPU : 10,4 %
La comparaison avec des systèmes plus gros mérite d'être soulignée. En PER, ce modèle se révèle comparable à wav2vec 2.0 Base et HuBERT Base, alors que ceux-ci sont environ 11 fois plus gros et ne sont pas conçus pour tourner sur des microcontrôleurs. L'auteur précise aussi honnêtement les limites du projet : ce n'est pas encore un substitut à la dictée de texte complète, mais plutôt un moteur local pour des commandes et des phrases courtes, là où l'autonomie et l'économie d'énergie sont critiques.
Où le microcontrôleur l'emporte
La force de cette approche n'est pas l'universalité à tout prix, mais de combler l'écart entre le simple keyword spotting et l'ASR lourd dans le cloud. Les interfaces vocales locales classiques attendent une correspondance exacte de la commande, alors qu'ici l'appareil peut déjà interpréter différentes formulations d'une même demande. Au lieu d'une phrase figée, l'utilisateur peut dire « mets plus chaud », « monte de cinq degrés » ou « température en hausse », et le système comprendra une seule action.
De là naissent des scénarios bien concrets : une maison connectée qui n'envoie pas la voix à l'extérieur, la saisie vocale de nombres et de paramètres en production, et l'usage dans les entrepôts, les dispositifs médicaux et les transports, où le réseau est instable ou carrément absent.
Autre atout : la marge de progression. Pour l'instant, le STM32N6 n'utilise que 18 % de sa RAM, et le NPU est sollicité à environ un dixième. Les prochaines étapes sont claires : ajouter un décodeur de phonèmes, un modèle de langage et une suppression du bruit. C'est ce qui devrait transformer un prototype technique convaincant en une interface réellement utile.
Ce que cela signifie
Le STM32N6 ne supprime pas la reconnaissance vocale dans le cloud, mais il montre qu'une partie des tâches peut déjà être déplacée en toute confiance à la périphérie du réseau. Là où comptent l'autonomie, la confidentialité, le prix et la faible consommation, les MCU dotés d'un NPU commencent à ressembler non plus à une expérience, mais à une nouvelle classe concrète d'interfaces vocales.
Questions clés sur cet article
Comment fonctionne le système?
L'auteur du projet a construit la reconnaissance vocale en trois blocs : un modèle acoustique, un décodeur et un module de rescoring. La partie la plus lourde est l'acoustique : elle reçoit le signal audio brut du microphone et le convertit en une séquence de phonèmes. Le décodeur doit assembler des mots à partir de ces phonèmes, et le bloc de rescoring revérifier le résultat en tenant compte du contexte. À ce stade, ce qui tourne déjà sur le STM32N6, c'est le modèle acoustique, c'est-à-dire la fondation de tout le système. Concrètement, l'appareil écoute la parole en temps
Que sait-on sur Chiffres et limites ?
Le résultat le plus marquant concerne la consommation. Pendant la reconnaissance active, l'ensemble du système consomme environ 215 mW. Sur ce total, environ 160 mW vont au NPU et au cœur Cortex-M55, 45 mW à la mémoire externe Flash et PSRAM, et environ 10 mW aux broches externes. Et il ne s'agit pas d'un mode optimisé : le cœur n'utilise pas encore de veille agressive et le NPU n'est chargé qu'à 10,4 %, il reste donc de la marge pour réduire encore la consommation. Côté qualité, le tableau est aussi sérieux pour cette classe de matériel. Le modèle compte 8,5 millions de pa
Que sait-on sur Où le microcontrôleur l'emporte ?
La force de cette approche n'est pas l'universalité à tout prix, mais de combler l'écart entre le simple keyword spotting et l'ASR lourd dans le cloud. Les interfaces vocales locales classiques attendent une correspondance exacte de la commande, alors qu'ici l'appareil peut déjà interpréter différentes formulations d'une même demande. Au lieu d'une phrase figée, l'utilisateur peut dire « mets plus chaud », « monte de cinq degrés » ou « température en hausse », et le système comprendra une seule action. De là naissent des scénarios bien concrets : une maison connectée qui n'
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.