Amazon Bedrock détaille désormais les coûts d'inférence par utilisateur et par application
AWS a intégré à Amazon Bedrock l'attribution détaillée des coûts d'inférence. La plateforme rattache désormais automatiquement les dépenses à un utilisateur IAM, à un rôle ou à une session fédérée, et les tags permettent de regrouper les coûts par équipe, projet et tenant. La fonction est particulièrement utile aux entreprises qui gèrent plusieurs applications, des équipes IA internes et des passerelles LLM, où tout le trafic pouvait auparavant se fondre en une seule ligne de facturation.
Traité par IA depuis AWS Machine Learning Blog ; édité par Hamidun News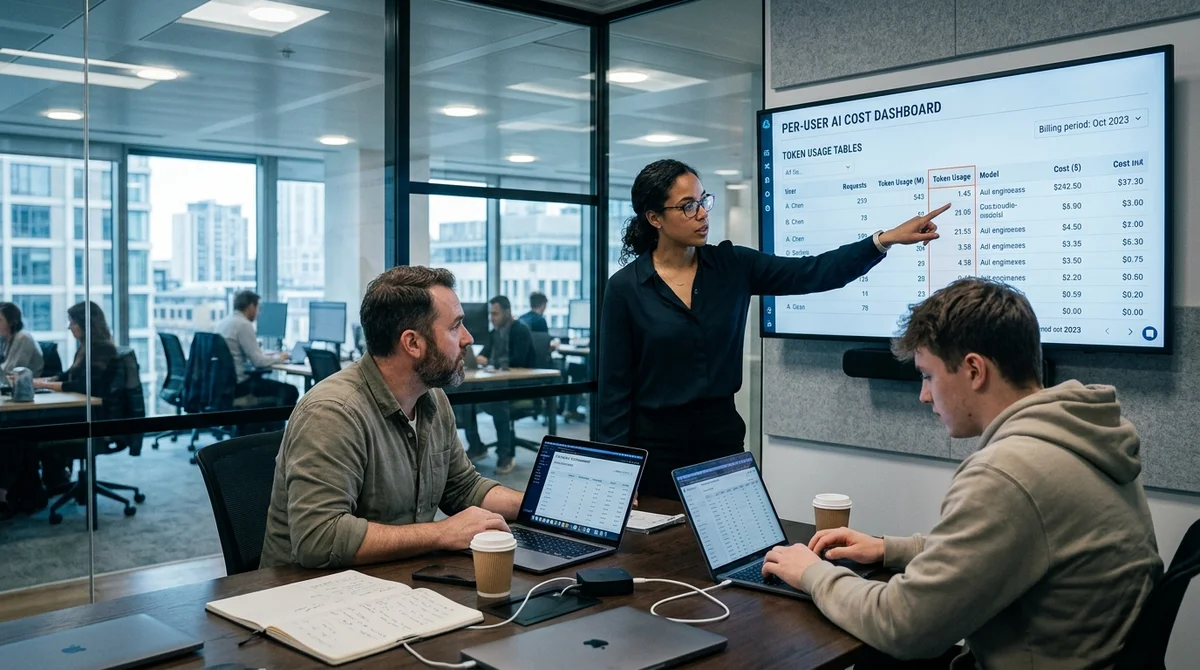
Le 17 avril 2026, AWS a lancé pour Amazon Bedrock la fonction granular cost attribution, un suivi détaillé des dépenses d'inférence. Les coûts peuvent désormais être rattachés automatiquement à un utilisateur, une application, un rôle IAM ou un tenant précis, sans modifier les scénarios existants d'appel aux modèles.
Comment ça marche
Bedrock transmet désormais à AWS Billing des données indiquant quel IAM principal a envoyé chaque requête à un modèle. Il peut s'agir d'un utilisateur IAM classique, du rôle d'une application, d'une session fédérée temporaire via Okta ou Entra ID, ou d'une clé d'API Bedrock si elle est liée à une identité IAM.
Le rapport CUR 2.0 comporte un nouveau champ line_item_iam_principal, et line_item_usage_type permet de savoir quel modèle a été utilisé, dans quelle région et si l'argent est parti en tokens d'entrée ou de sortie.
AWS propose en plus d'activer des tags d'allocation des coûts. On peut les attacher directement aux utilisateurs et rôles IAM, ou les transmettre comme session tags lors de l'autorisation fédérée et d'AssumeRole. Une fois activés dans la facturation, ces tags apparaissent dans CUR 2.0 comme dans Cost Explorer, où les dépenses peuvent être regroupées par équipe, projet, centre de coûts ou tenant.
La fonction est disponible dans les régions commerciales sans supplément, mais il faut activer l'export de l'IAM principal dans CUR 2.0 et attendre 24 à 48 heures pour que les tags apparaissent.
«
Comprendre qui dépense exactement l'argent en inférence est la première étape vers le chargeback, la prévision et l'optimisation. »
Quatre scénarios de suivi
AWS décrit quatre schémas types où la nouvelle attribution est particulièrement utile. La logique est la même : celui qui appelle Bedrock devient l'unité de comptabilisation. Mais la méthode de marquage dépend de qui utilise les modèles : une personne, un service, une session SSO d'entreprise ou une passerelle LLM partagée.
La différence compte, car c'est elle qui détermine où sont stockés l'identifiant de l'appelant et les tags servant ensuite à agréger les coûts dans les rapports et les alertes.
- Utilisateurs IAM et clés d'API : adapté aux petites équipes et aux prototypes ; on voit les dépenses de chaque développeur séparément.
- Rôles IAM pour les applications : pratique pour les services en production ; les coûts se répartissent par backend, batch job et projet.
- Utilisateurs fédérés via un IdP : les utilisateurs d'entreprise sont identifiables par le nom de session et les tags SAML ou OIDC.
- Passerelle ou proxy LLM : pour les SaaS et plateformes IA internes qui ont besoin d'une ventilation par utilisateur et par tenant, et non d'une seule ligne pour toute la passerelle.
Le cas le plus délicat est celui de la passerelle. Si le proxy appelle Bedrock sous un seul rôle, la facturation ne verra que ce rôle et perdra le détail. AWS propose de résoudre cela avec AssumeRole pour chaque utilisateur ou tenant, en transmettant un role-session-name et des tags. Les identifiants obtenus peuvent être mis en cache jusqu'à une heure, si bien que ce modèle n'impose pas d'appeler STS à chaque requête. Par défaut, la limite STS pour AssumeRole est de 500 appels par seconde et par compte, un point à prendre en compte dans les systèmes à fort débit.
L'effet concret pour les équipes
Pour les équipes FinOps et les plateformes IA, cela comble une lacune ancienne : les coûts de Bedrock n'étaient souvent visibles qu'au niveau du compte ou d'un seul utilisateur de service, et il fallait construire sa propre couche de journalisation et répartir les dépenses à la main. AWS offre désormais un mécanisme natif de chargeback et de showback, fondé sur les mêmes identités IAM et les mêmes tags que ceux déjà utilisés pour l'accès et la gouvernance. Autre avantage : on repère vite qui consomme des modèles coûteux comme Opus, qui reste sur des configurations plus légères, et où les output tokens engloutissent le budget.
Pour les équipes d'ingénierie, l'intérêt ne se limite pas à la finance. Si chaque microservice a son propre rôle et chaque employé sa propre session fédérée, le même mécanisme renforce à la fois la sécurité et la transparence. Dans un SaaS multi-tenant, c'est particulièrement utile : on peut comparer le coût de service des clients, construire des tarifs internes et définir des alertes Cost Explorer par tag.
Au fond, AWS transforme l'identité de l'appel au modèle en véritable étiquette financière, à partir de laquelle on peut déjà produire des rapports sans data pipeline séparé.
Ce que cela signifie
Amazon Bedrock devient nettement plus pratique pour les entreprises qui déploient l'IA générative à grande échelle, au-delà de quelques dizaines de requêtes de démonstration, avec de vraies équipes, de vrais services et de vrais clients. Plus une entreprise génère de trafic IA, plus il importe de voir non seulement la facture globale, mais la source précise des dépenses.
- 2 nov. 2026Un journaliste de The Verge assemble un équivalent du Meta Muse Charm à $50 avec Claude Code
- 31 oct. 2026Worldwide Express confie ses factures litigieuses à des agents IA et réduit sa dette de 75%
- 30 oct. 2026AWS offre aux agents de codage un aperçu en direct du site, depuis leur session isolée
- 30 oct. 2026Zocdoc : le trafic des agents multiplié par 30 depuis juillet, deux plaintes sur la santé visent ChatGPT
Questions clés sur cet article
Comment ça marche?
Bedrock transmet désormais à AWS Billing des données indiquant quel IAM principal a envoyé chaque requête à un modèle. Il peut s'agir d'un utilisateur IAM classique, du rôle d'une application, d'une session fédérée temporaire via Okta ou Entra ID, ou d'une clé d'API Bedrock si elle est liée à une identité IAM. Le rapport CUR 2.0 comporte un nouveau champ line_item_iam_principal, et line_item_usage_type permet de savoir quel modèle a été utilisé, dans quelle région et si l'argent est parti en tokens d'entrée ou de sortie. AWS propose en plus d'activer des tags d'allocation d
Que sait-on sur Quatre scénarios de suivi ?
AWS décrit quatre schémas types où la nouvelle attribution est particulièrement utile. La logique est la même : celui qui appelle Bedrock devient l'unité de comptabilisation. Mais la méthode de marquage dépend de qui utilise les modèles : une personne, un service, une session SSO d'entreprise ou une passerelle LLM partagée. La différence compte, car c'est elle qui détermine où sont stockés l'identifiant de l'appelant et les tags servant ensuite à agréger les coûts dans les rapports et les alertes. Utilisateurs IAM et clés d'API : adapté aux petites équipes et aux prototypes
Que sait-on sur L'effet concret pour les équipes ?
Pour les équipes FinOps et les plateformes IA, cela comble une lacune ancienne : les coûts de Bedrock n'étaient souvent visibles qu'au niveau du compte ou d'un seul utilisateur de service, et il fallait construire sa propre couche de journalisation et répartir les dépenses à la main. AWS offre désormais un mécanisme natif de chargeback et de showback, fondé sur les mêmes identités IAM et les mêmes tags que ceux déjà utilisés pour l'accès et la gouvernance. Autre avantage : on repère vite qui consomme des modèles coûteux comme Opus, qui reste sur des configurations plus légè
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.