En 2026, les startups d'IA passent du prompt unique aux pipelines multi-agents
Un bon prompt et une jolie interface ne suffisent plus à faire un produit d'IA complet. En 2026, les startups qui ont besoin d'un résultat stable pour l'utilisateur et pour l'entreprise passent aux pipelines multi-agents : un agent collecte les données, un autre génère, un troisième vérifie, et un orchestrateur assemble le tout. C'est cette architecture qui commence à distinguer la démo du service qui fonctionne réellement.
Traité par IA depuis Habr AI ; édité par Hamidun News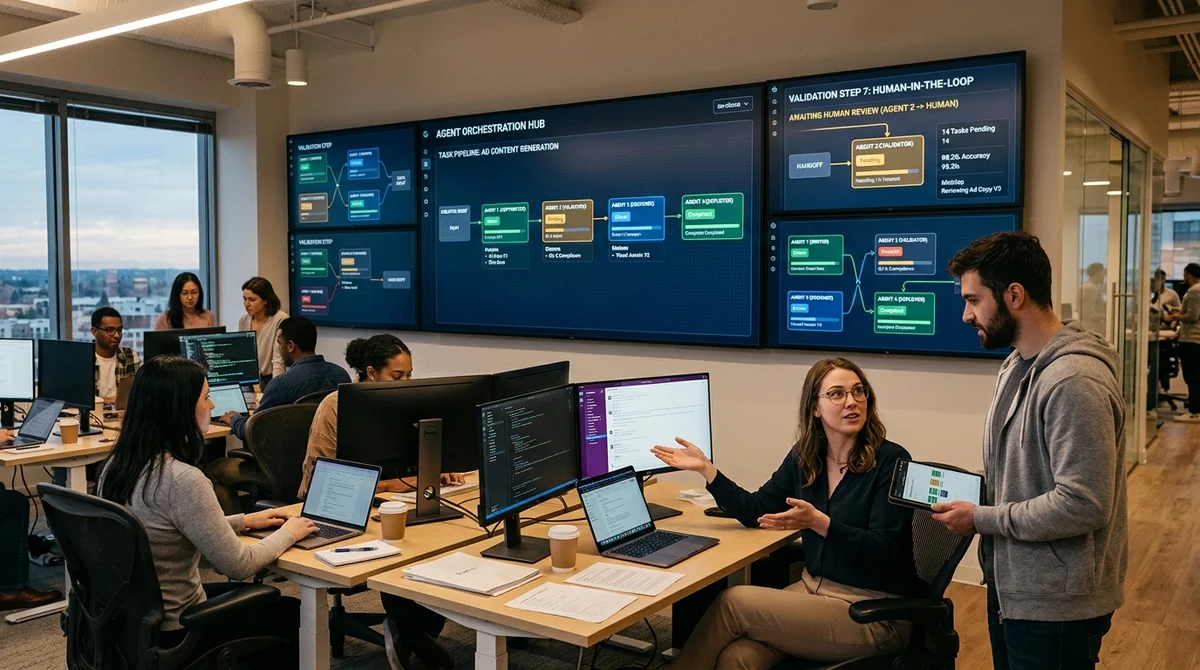
Le marché des services d'IA se heurte en 2026 de plus en plus souvent à une vérité désagréable : une belle interface autour d'un prompt réussi crée rarement un produit durable. Les équipes qui veulent amener l'IA à un résultat exploitable abandonnent la « requête magique » et montent des pipelines multi-agents, où différents modèles et contrôles prennent en charge des étapes distinctes de la tâche.
Pourquoi un seul prompt ne suffit pas
La logique « prenons un modèle puissant, écrivons un bon prompt système et emballons le tout dans un abonnement » a fonctionné sur le marché naissant, mais elle a vite atteint un plafond. Une seule requête peut rédiger un texte, proposer une idée ou assembler un brouillon, mais elle gère mal un contexte long, ne sait pas se vérifier de façon stable et casse facilement dès que la saisie de l'utilisateur est un peu plus complexe que prévu. Résultat : le produit fait bonne impression en démo, mais s'effondre dans les scénarios réels, où il faut de la mémoire, du routage de tâches et un contrôle qualité.
Le problème est particulièrement visible quand on promet d'automatiser un processus métier et que l'on livre, en pratique, un chat avec un seul bouton. Tant que l'utilisateur pose une question type, tout paraît convaincant. Mais dès qu'il faut relier plusieurs sources, respecter un format, vérifier des chiffres et renvoyer une réponse prévisible, le système produit des résultats différents pour une même entrée. Pour le B2B et le travail en équipe, c'est presque une condamnation : un tel outil s'intègre difficilement dans le circuit opérationnel.
À quoi ressemble un pipeline
La nouvelle approche ne s'articule pas autour d'un modèle unique, mais d'une chaîne de rôles. Un agent reçoit la tâche et précise les données d'entrée, un deuxième cherche des faits ou des documents, un troisième écrit un brouillon, un quatrième vérifie la logique, le format et les contraintes, et l'orchestrateur assemble le résultat et décide s'il faut renvoyer la tâche pour un tour supplémentaire. Une telle chaîne est nettement plus complexe à construire, mais elle ressemble davantage au fonctionnement des équipes solides : pas un exécutant universel, mais plusieurs spécialisations aux responsabilités bien définies.
Un pipeline multi-agents n'est pas là pour suivre un mot à la mode, mais pour la maîtrise. Quand chaque étape est isolée, l'équipe peut améliorer précisément le point faible : changer de modèle uniquement pour la recherche, ajouter des règles de vérification uniquement à la relecture finale, conserver la mémoire uniquement là où elle aide réellement. Cela réduit le coût des erreurs et rend le développement du produit plus ingénieur et moins intuitif. L'équipe voit exactement où la sortie casse et peut réparer ce segment sans réécrire tout le système.
« Un prompt n'est pas un produit ».
Ce qui change pour les startups
Le schéma multi-agents coûte plus cher à développer, mais il apporte ce qui manque à la plupart des surcouches d'IA : la répétabilité du résultat. Au lieu d'espérer une génération réussie, l'équipe se met à concevoir un processus : où valider les données, comment détecter les hallucinations, comment réutiliser le contexte, quand demander une confirmation humaine. C'est là qu'apparaît une valeur produit difficile à copier en une soirée. L'IA cesse d'être un simple générateur de réponses pour devenir un service maîtrisé, avec des SLA clairs.
- Décomposition de la tâche en étapes plutôt qu'une requête unique
- Agents distincts pour la recherche, la génération et la vérification
- Règles d'escalade si le modèle n'est pas sûr de sa réponse
- Stockage du contexte intermédiaire et de l'historique des décisions
- Métriques de qualité pour chaque étape, et pas seulement pour la réponse finale
Cette approche change aussi l'économie du produit. Oui, un pipeline peut coûter plus cher en tokens et en infrastructure, mais il réduit le prix de l'erreur : moins de reprises manuelles, moins de retours, moins de défiance du client. Si le service promet un résultat, et pas seulement une « aide à la génération », la stabilité commence à compenser les surcoûts dès la phase initiale de croissance.
Pour le marché, c'est un déplacement important. Les gagnants ne seront pas ceux qui ont les premiers greffé un LLM à un formulaire de saisie, mais ceux qui ont bâti une architecture fiable autour du modèle. En 2026, l'avantage concurrentiel n'est plus l'accès à l'API en soi, mais la capacité à organiser agents, outils et données en un flux de travail unique, sans magie superflue.
Ce que cela signifie
La période où l'on pouvait faire passer un produit d'IA pour « un prompt solide plus une jolie interface » touche à sa fin. Si une équipe veut vendre non pas une démo mais un service stable, elle devra raisonner comme un système d'ingénierie : découper la tâche, vérifier les étapes et construire l'orchestration entre les agents.
- 2 nov. 2026Karpathy bâtit en deux heures un clone de YouTube avec 6454 vidéos issues des conseils de Hacker News
- 2 nov. 2026Avec Claude, Andrej Karpathy a assemblé HackerTube : 6454 vidéos recommandées sur Hacker News
- 2 nov. 2026Arca confie à des agents IA des tâches financières pouvant durer jusqu'à 10 jours, mais laisse les transactions aux humains
- 2 nov. 2026DeepSeek ouvre le code d'un prototype de Super-agent : p95 du temps d'exécution de 15,7 min contre 29,5
Questions clés sur cet article
Pourquoi un seul prompt ne suffit pas?
La logique « prenons un modèle puissant, écrivons un bon prompt système et emballons le tout dans un abonnement » a fonctionné sur le marché naissant, mais elle a vite atteint un plafond. Une seule requête peut rédiger un texte, proposer une idée ou assembler un brouillon, mais elle gère mal un contexte long, ne sait pas se vérifier de façon stable et casse facilement dès que la saisie de l'utilisateur est un peu plus complexe que prévu. Résultat : le produit fait bonne impression en démo, mais s'effondre dans les scénarios réels, où il faut de la mémoire, du routage de tâc
Que sait-on sur à quoi ressemble un pipeline ?
La nouvelle approche ne s'articule pas autour d'un modèle unique, mais d'une chaîne de rôles. Un agent reçoit la tâche et précise les données d'entrée, un deuxième cherche des faits ou des documents, un troisième écrit un brouillon, un quatrième vérifie la logique, le format et les contraintes, et l'orchestrateur assemble le résultat et décide s'il faut renvoyer la tâche pour un tour supplémentaire. Une telle chaîne est nettement plus complexe à construire, mais elle ressemble davantage au fonctionnement des équipes solides : pas un exécutant universel, mais plusieurs spéci
Que sait-on sur Ce qui change pour les startups ?
Le schéma multi-agents coûte plus cher à développer, mais il apporte ce qui manque à la plupart des surcouches d'IA : la répétabilité du résultat. Au lieu d'espérer une génération réussie, l'équipe se met à concevoir un processus : où valider les données, comment détecter les hallucinations, comment réutiliser le contexte, quand demander une confirmation humaine. C'est là qu'apparaît une valeur produit difficile à copier en une soirée. L'IA cesse d'être un simple générateur de réponses pour devenir un service maîtrisé, avec des SLA clairs. Décomposition de la tâche en étape
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.