Amazon dévoile une recherche en langage naturel dans de grandes archives vidéo avec Nova
Amazon a présenté une architecture opérationnelle pour rechercher dans de grandes archives vidéo sans balisage manuel ni mots-clés rigides. Nova découpe les vidéos en segments de 15 secondes, génère des embeddings multimodaux et les stocke dans OpenSearch avec des tags. Sur un corpus d'environ 792 000 vidéos, la recherche sémantique a répondu en 76 ms et le mode hybride en environ 106 ms.
Traité par IA depuis AWS Machine Learning Blog ; édité par Hamidun News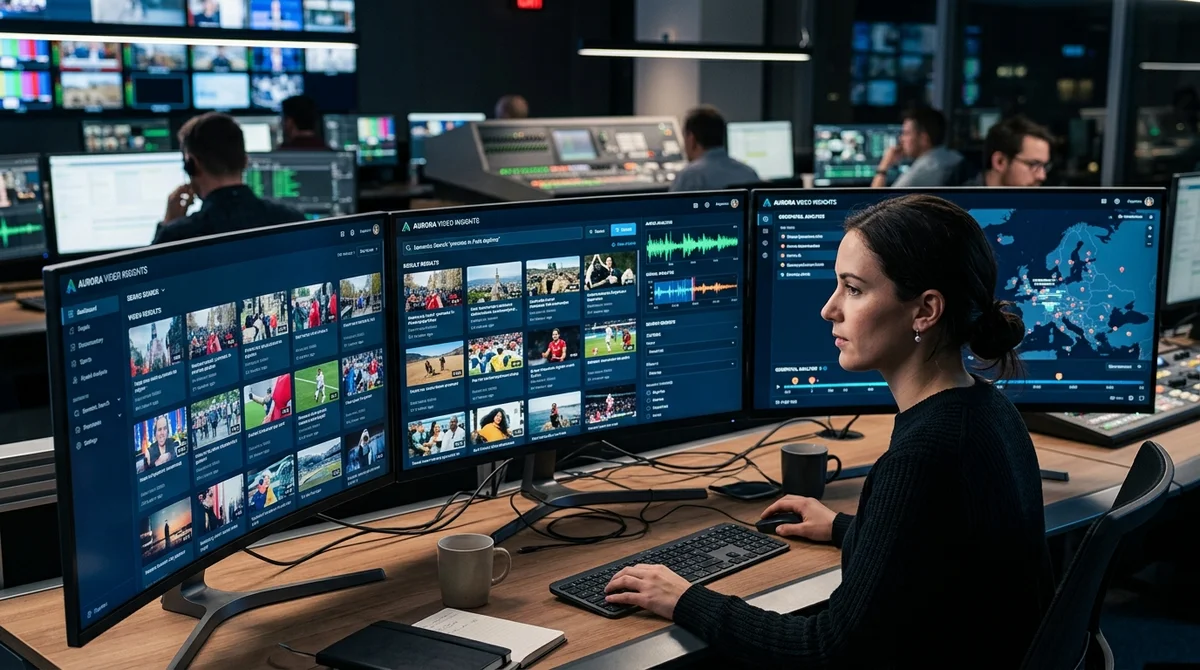
Amazon a montré comment construire une recherche dans de grandes archives vidéo sans balisage manuel ni dépendance stricte aux mots-clés. Au lieu d'un étiquetage selon un scénario, le système génère des embeddings multimodaux pour le son et l'image, puis retrouve les vidéos par le sens via OpenSearch.
Comment fonctionne la recherche
La solution repose sur Amazon Nova Multimodal Embeddings et Amazon OpenSearch Service. Les vidéos sont chargées dans S3, puis l'API asynchrone de Nova les découpe automatiquement en segments de 15 secondes et génère des vecteurs de 1024 dimensions en mode AUDIO_VIDEO_COMBINED. Le point est important : le modèle prend en compte non seulement l'image mais aussi le son, si bien que la recherche ne comprend pas des mots isolés dans une légende, mais le contexte de la scène : qui parle, ce qui se passe à l'écran et quelle est l'ambiance du passage.
Par ailleurs, AWS propose de passer les vidéos par Nova Pro ou Nova 2 Lite pour produire 10 à 15 tags descriptifs selon une taxonomie donnée. Le système conserve ainsi deux index : un index vectoriel pour la recherche sémantique et un index textuel pour la recherche par mots-clés. Ce schéma évite de choisir entre recherche « intelligente » et filtrage par métadonnées : on peut combiner les deux approches dans une seule interface. Concrètement, la même archive peut être explorée aussi bien avec des requêtes comme « une personne marche sur la plage au coucher du soleil » qu'avec des filtres textuels stricts.
- Recherche vidéo par texte : une requête en langage naturel est transformée en embedding et comparée aux segments vidéo.
- Recherche de vidéos similaires : le système prend le vecteur d'une vidéo déjà connue et trouve des passages au contenu proche.
- Recherche hybride : les résultats de k-NN et de BM25 sont fusionnés, par défaut avec des poids de 70 % pour la sémantique et 30 % pour le texte.
Échelle et économie
AWS a testé le schéma non pas sur un jeu de démonstration de quelques fichiers, mais sur un corpus d'environ 792 000 vidéos issues des jeux de données Multimedia Commons et MEVA. Cela représente environ 8 480 heures de contenu, soit 30,5 millions de secondes. Le traitement complet a pris 41 heures sur quatre instances c7i.48xlarge avec 600 workers parallèles. Bedrock limite à 30 les tâches asynchrones simultanées par compte ; l'exemple utilise donc une file de tâches qui interroge l'état et charge de nouvelles vidéos à mesure que des emplacements se libèrent.
Le tableau des coûts est lui aussi assez transparent. AWS estime la première année d'un tel système à environ 23,6–27,3 milliers de dollars, selon le modèle de paiement d'OpenSearch retenu. Sur ce total, environ 18,1 milliers de dollars correspondent au chargement initial et à la génération des embeddings, le reste au fonctionnement annuel de la couche de recherche. Le principal poste de dépense n'est pas le calcul sur EC2, mais les embeddings eux-mêmes, car Nova est facturé selon la durée des vidéos. Le détail :
- environ 17 096 $ : génération d'embeddings multimodaux dans Amazon Bedrock
- environ 571 $ : étiquetage automatique avec Nova Pro
- environ 421 $ : calcul sur EC2 pour le traitement par lots
- de 5 544 à 9 240 $ par an : stockage et recherche dans OpenSearch, selon le modèle de paiement
AWS explique aussi pourquoi l'exemple retient des vecteurs de 1024 dimensions plutôt que de 3072 : le coût de génération ne change pas, mais le stockage devient environ trois fois moins cher pour une perte de précision minime.
Côté recherche, les chiffres ressemblent déjà à de la production : le k-NN sémantique répond en 76 ms environ, BM25 en 30 ms et le mode hybride en 106 ms. Les index couvrant tout le corpus occupent environ 29,8 Go ; même une grande archive vidéo n'exige donc pas d'infrastructure exotique.
Nuances pratiques
Ce contenu compte non comme l'annonce d'un énième modèle, mais comme un modèle d'ingénierie prêt à l'emploi. AWS montre en réalité comment passer du balisage manuel des vidéos à un AI data lake, où la recherche s'articule autour des embeddings plutôt que des descriptions humaines. Pour les équipes des médias et du divertissement, cela peut résoudre plusieurs besoins à la fois : détection de doublons, navigation dans l'archive, sélection rapide de b-roll et création d'outils internes pour les monteurs, producteurs et archivistes.
Mais il y a des limites. Le lancement exige Bedrock dans la région us-east-1, OpenSearch 2.11 ou plus récent, S3 et des droits IAM configurés. La vitesse et le prix dépendent directement de la durée des vidéos : lors du test, une vidéo de 45 secondes a été traitée en environ 70 secondes. Si les métadonnées sont de bonne qualité, AWS conseille d'augmenter la part de la recherche textuelle, jusqu'à 50/50. Et si la bibliothèque continue de grossir, la logique de traitement peut être déplacée vers AWS Batch et mise à l'échelle par morceaux.
Ce que cela signifie
Amazon montre que la recherche vidéo multimodale peut désormais être vue non comme un jouet de recherche, mais comme un schéma d'infrastructure bien compris. Pour les équipes médias, c'est l'occasion de cesser de vivre au rythme des tags manuels et de chercher enfin dans l'archive comme les gens formulent réellement leurs requêtes : en langage courant.
- 31 oct. 2026Worldwide Express confie ses factures litigieuses à des agents IA et réduit sa dette de 75%
- 30 oct. 2026AWS offre aux agents de codage un aperçu en direct du site, depuis leur session isolée
- 30 oct. 2026MoEngage ouvre 400 API privées à ses agents IA via AgentCore Gateway, sans serveurs MCP maison
- 29 oct. 2026NVIDIA Nemotron 3.5 Super VL : 120 milliards de paramètres, 12 milliards actifs, déploiement sur AWS
Questions clés sur cet article
Comment fonctionne la recherche?
La solution repose sur Amazon Nova Multimodal Embeddings et Amazon OpenSearch Service. Les vidéos sont chargées dans S3, puis l'API asynchrone de Nova les découpe automatiquement en segments de 15 secondes et génère des vecteurs de 1024 dimensions en mode AUDIO_VIDEO_COMBINED. Le point est important : le modèle prend en compte non seulement l'image mais aussi le son, si bien que la recherche ne comprend pas des mots isolés dans une légende, mais le contexte de la scène : qui parle, ce qui se passe à l'écran et quelle est l'ambiance du passage. Par ailleurs, AWS propose de p
Que sait-on sur échelle et économie ?
AWS a testé le schéma non pas sur un jeu de démonstration de quelques fichiers, mais sur un corpus d'environ 792 000 vidéos issues des jeux de données Multimedia Commons et MEVA. Cela représente environ 8 480 heures de contenu, soit 30,5 millions de secondes. Le traitement complet a pris 41 heures sur quatre instances c7i.48xlarge avec 600 workers parallèles. Bedrock limite à 30 les tâches asynchrones simultanées par compte ; l'exemple utilise donc une file de tâches qui interroge l'état et charge de nouvelles vidéos à mesure que des emplacements se libèrent. Le tableau des
Que sait-on sur Nuances pratiques ?
Ce contenu compte non comme l'annonce d'un énième modèle, mais comme un modèle d'ingénierie prêt à l'emploi. AWS montre en réalité comment passer du balisage manuel des vidéos à un AI data lake, où la recherche s'articule autour des embeddings plutôt que des descriptions humaines. Pour les équipes des médias et du divertissement, cela peut résoudre plusieurs besoins à la fois : détection de doublons, navigation dans l'archive, sélection rapide de b-roll et création d'outils internes pour les monteurs, producteurs et archivistes. Mais il y a des limites. Le lancement exige B
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.