Le MIT apprend à une IA générative à reconstituer des objets cachés à partir de signaux sans fil
Le MIT a amélioré la « vision » sans fil des robots : un modèle génératif complète les parties cachées des objets à partir des réflexions de signaux mmWave, proches du Wi-Fi. Le système Wave-Former est presque 20 % plus précis que les approches précédentes, tandis que RISE sait reconstruire une pièce entière avec un seul radar fixe et le déplacement d'une personne. La technologie pourrait servir dans les entrepôts, les maisons connectées et les situations où les caméras sont indésirables pour des raisons de confidentialité.
Traité par IA depuis MIT News ; édité par Hamidun News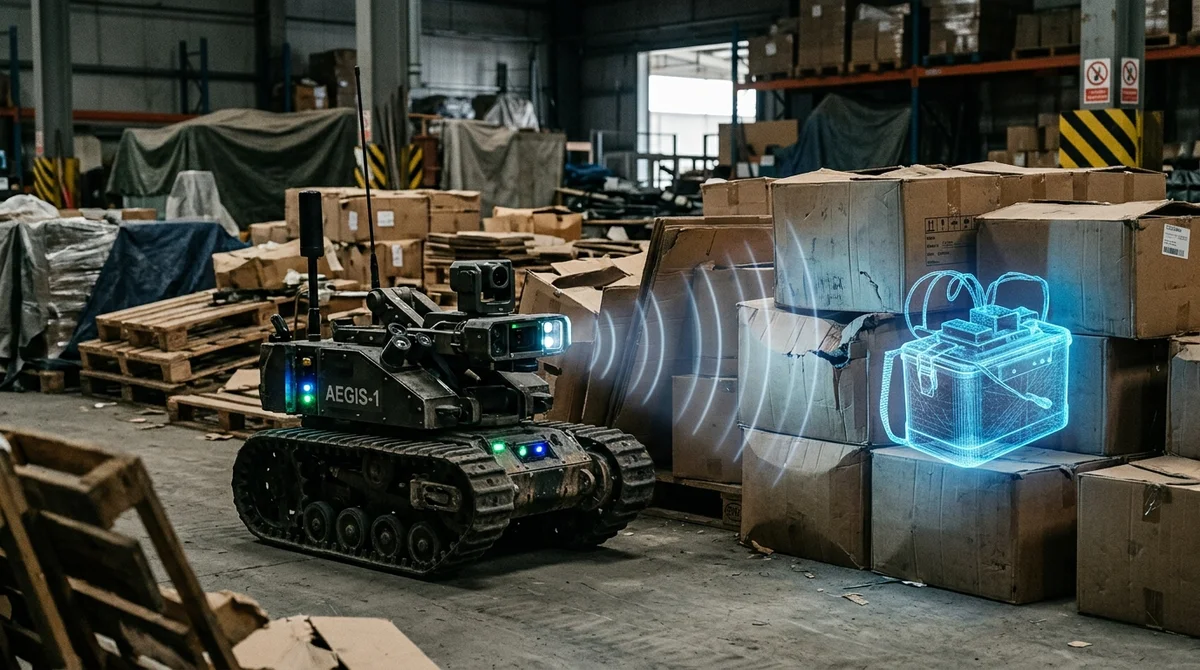
Des chercheurs du MIT ont amélioré un système de « vision » sans fil qui reconnaît des objets dissimulés derrière des obstacles grâce aux réflexions de signaux en ondes millimétriques. Un modèle génératif complète désormais les parties manquantes de la forme et aide les robots à mieux comprendre ce qui se trouve derrière du carton, du plastique, du placoplâtre ou du tissu.
Comment ça fonctionne
Les versions précédentes de ces systèmes savaient déjà exploiter les signaux mmWave pour construire un modèle 3D grossier d'un objet caché derrière une barrière. Le problème tenait à la physique de la réflexion : les ondes repartent souvent dans une direction au lieu de revenir vers le capteur. Résultat, le système ne « voyait » généralement que le dessus de l'objet, tandis que les surfaces latérales et inférieures restaient des zones vides.
Pour un robot, c'est critique : si la forme est reconstruite de façon imprécise, le manipulateur détermine moins bien comment saisir l'objet en sécurité et comment il est positionné dans l'espace.
Pour contourner cette limite, l'équipe du MIT a ajouté un modèle génératif qui reçoit une reconstruction incomplète et la complète en une forme entière plausible. Mais il manquait de jeux de données mmWave réels pour l'entraînement ; les chercheurs ont donc pris un détour : ils ont repris de grands jeux d'images générées par ordinateur et les ont adaptés aux propriétés des réflexions sans fil, notamment la spécularité et le bruit. Ils ont entraîné le système Wave-Former sur cette base synthétique. Il propose d'abord des surfaces possibles de l'objet à partir des réflexions, puis le modèle comble les lacunes, et affine ensuite la géométrie jusqu'à obtenir une reconstruction 3D complète.
Précision et scènes
Lors des tests, Wave-Former a reconstitué les formes d'environ 70 objets du quotidien, des canettes et boîtes aux fruits et ustensiles de cuisine. Les objets étaient cachés derrière du carton, du bois, du placoplâtre, du plastique et du tissu, ou placés sous ces matériaux. Selon le MIT, le nouveau schéma a donné une reconstruction presque 20 pour cent plus précise que les meilleures approches antérieures. En pratique, c'est une étape importante : le système ne se contente pas de détecter la présence d'un objet, il se rapproche d'une compréhension de sa forme, de son volume et de ses contours réels.
«
Nous utilisons l'IA pour enfin libérer le potentiel de la vision sans fil », déclare Fadel Adib, qui dirige ces travaux.
L'équipe ne s'est pas arrêtée là et a mis au point un second système, RISE, qui reconstruit non plus un objet isolé, mais une pièce entière. Il lui suffit d'un radar fixe et du déplacement d'une personne dans le local. Quand une personne marche, une partie du signal se réfléchit sur elle, puis sur les murs et les meubles, avant de revenir vers le capteur. Ces réflexions secondaires sont généralement considérées comme du bruit et écartées, mais le MIT a appris au modèle à en extraire l'agencement de la scène. Lors d'expériences sur plus de 100 trajectoires de déplacement de personnes, RISE s'est montré en moyenne environ deux fois plus précis que les méthodes existantes.
À quoi cela pourrait servir
La valeur pratique ne tient pas seulement à la précision, mais aussi au mode d'utilisation. Pour analyser une scène, nul besoin d'un robot mobile équipé d'un capteur qui doit parcourir la pièce et la scanner depuis différents points. Un seul radar immobile suffit. De plus, la méthode ne repose pas sur des caméras classiques, ce qui la rend plus adaptée aux scénarios où la vie privée des personnes dans le champ compte.
- Vérification du contenu de cartons et d'emballages avant expédition
- Recherche d'objets masqués par d'autres choses dans un entrepôt ou à la maison
- Reconstitution de l'agencement d'une pièce avec un seul capteur fixe
- Détermination de la position d'une personne pour que le robot se déplace plus sûrement
- Scénarios où il est préférable de ne pas utiliser de caméras pour des raisons de confidentialité
Si la technologie gagne en finesse et en robustesse, elle pourrait avoir une chance de sortir du laboratoire. L'équipe du MIT dit sans détour que la prochaine étape consiste à développer des modèles de fondation plus grands pour les signaux sans fil, sur le modèle de ce que font GPT, Claude et Gemini avec le texte et les images. Cette approche pourrait faire passer la détection sans fil d'un outil de recherche étroit à une couche de perception universelle pour les robots et les espaces connectés.
Ce que cela signifie
Le MIT montre un déplacement intéressant : au lieu de tirer manuellement le maximum de chaque réflexion, les chercheurs confient à un modèle génératif le soin de deviner la géométrie manquante à partir de données partielles. Si cette approche passe à l'échelle, les robots pourront « voir » derrière les obstacles avec plus d'assurance là où une caméra ordinaire est inutile ou indésirable.
Questions clés sur cet article
Comment ça fonctionne?
Les versions précédentes de ces systèmes savaient déjà exploiter les signaux mmWave pour construire un modèle 3D grossier d'un objet caché derrière une barrière. Le problème tenait à la physique de la réflexion : les ondes repartent souvent dans une direction au lieu de revenir vers le capteur. Résultat, le système ne « voyait » généralement que le dessus de l'objet, tandis que les surfaces latérales et inférieures restaient des zones vides. Pour un robot, c'est critique : si la forme est reconstruite de façon imprécise, le manipulateur détermine moins bien comment saisir l
Que sait-on sur Précision et scènes ?
Lors des tests, Wave-Former a reconstitué les formes d'environ 70 objets du quotidien, des canettes et boîtes aux fruits et ustensiles de cuisine. Les objets étaient cachés derrière du carton, du bois, du placoplâtre, du plastique et du tissu, ou placés sous ces matériaux. Selon le MIT, le nouveau schéma a donné une reconstruction presque 20 pour cent plus précise que les meilleures approches antérieures. En pratique, c'est une étape importante : le système ne se contente pas de détecter la présence d'un objet, il se rapproche d'une compréhension de sa forme, de son volume
Que sait-on sur à quoi cela pourrait servir ?
La valeur pratique ne tient pas seulement à la précision, mais aussi au mode d'utilisation. Pour analyser une scène, nul besoin d'un robot mobile équipé d'un capteur qui doit parcourir la pièce et la scanner depuis différents points. Un seul radar immobile suffit. De plus, la méthode ne repose pas sur des caméras classiques, ce qui la rend plus adaptée aux scénarios où la vie privée des personnes dans le champ compte. Vérification du contenu de cartons et d'emballages avant expédition Recherche d'objets masqués par d'autres choses dans un entrepôt ou à la maison Reconstitut
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.