Sber montre comment RAG et un LLM dans l'IDE transforment des scénarios manuels en tests automatisés
Sber a présenté un prototype pour les IDE de JetBrains qui génère des tests automatisés à partir de scénarios manuels en combinant un LLM et RAG. Le système cherche des étapes et des tests pertinents dans le projet lui-même, conserve le style du code et vérifie le résultat via PSI. En interne, 68 % des tests générés n'ont demandé que des retouches minimes, et la satisfaction des utilisateurs atteint environ 80 %.
Traité par IA depuis Habr AI ; édité par Hamidun News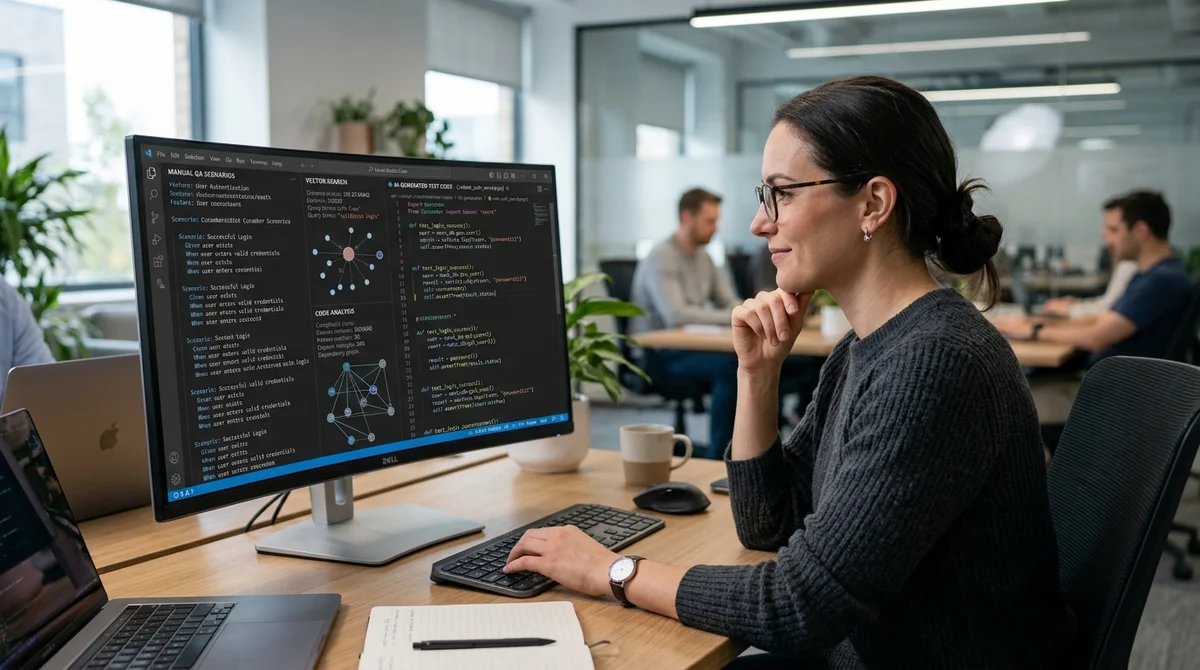
Sber a montré comment alléger l'une des tâches les plus routinières du QA : convertir des scénarios manuels en tests automatisés directement dans l'IDE. Le dispositif associe un LLM et RAG : au lieu de simplement écrire du code, il cherche d'abord des exemples pertinents dans le projet lui-même afin d'en préserver le style, les conventions et l'architecture.
Pourquoi un prompt direct ne fonctionne pas
L'idée d'« envoyer simplement le test manuel au modèle et d'obtenir du code prêt à l'emploi » se heurte aux détails. Un LLM peut bien produire un test Java fonctionnel, mais presque à coup sûr pas comme on le fait dans une équipe donnée : il oubliera Allure, enfreindra le schéma de nommage, placera l'URL et le corps de la requête au mauvais endroit, ajoutera des vérifications superflues ou n'utilisera pas les utilitaires internes, comme une méthode commune de contrôle du statut. En automatisation des tests, ce n'est pas cosmétique : c'est une perte réelle de compatibilité avec le projet.
Le problème va plus loin que la qualité du prompt. Les tests automatisés vivent dans leur propre framework et dépendent de l'architecture, du CI, de Page Object, des clés TMS et des conventions d'annotations. Si l'on tente de transmettre tout le projet au modèle, on se heurte vite aux limites de la fenêtre de contexte, à la hausse de la latence et au coût des requêtes. Même ainsi, il reste des hallucinations, des étapes omises et un résultat instable qu'il faut remettre à la main dans l'état voulu.
Comment fonctionne RAG
À la place d'un few-shot statique avec des exemples choisis à la main, l'équipe de Sber a conçu un plugin pour les IDE de JetBrains. Il analyse le projet via la structure PSI, et non comme du texte brut, ce qui lui permet de voir les classes, méthodes, annotations et appels. Sur cette base, le système collecte les étapes Allure, les tests automatisés existants, leurs clés TMS, le code et de courtes descriptions textuelles. Ces descriptions sont ensuite converties en embeddings et stockées avec leurs métadonnées dans une base de connaissances locale ou un magasin vectoriel.
Lorsqu'un nouveau scénario manuel arrive, le système franchit plusieurs étapes :
- il extrait l'action et le résultat attendu de chaque étape ;
- il construit plusieurs variantes sémantiques de la requête pour chercher des étapes similaires ;
- il demande au LLM de décrire brièvement l'ensemble du test afin de trouver un test automatisé proche par le sens ;
- il insère automatiquement les exemples trouvés dans le prompt, à la place du few-shot manuel ;
- il vérifie le résultat par une nouvelle requête au modèle et via PSI dans l'IDE.
Cette approche produit un code qui semble écrit par un membre de l'équipe, et non par un modèle externe sans contexte. L'article souligne que la recherche sémantique n'est pas là pour suivre la mode du RAG, mais dans un but pratique : amener dans la génération précisément les étapes, utilitaires et motifs qui ont déjà fait leurs preuves dans le projet.
RAG, c'est du few-shot qui trouve lui-même les bons exemples.
Résultats du prototype
Selon l'équipe, le prototype interne a déjà produit un effet mesurable. Environ 68 % des tests générés étaient d'un niveau acceptable et n'ont demandé que des retouches minimes, et la satisfaction globale des utilisateurs s'établit à environ 80 %. L'outil s'est montré le plus efficace sur des scénarios d'API simples et semblables, où il importe surtout de reproduire vite un modèle de code établi sans copier à la main depuis des tests voisins. Les ingénieurs en automatisation ont aussi noté une charge cognitive réduite : moins de temps passé sur la routine, davantage sur les scénarios complexes et les décisions d'architecture.
Mais il n'existe pas de « pilote automatique » universel. Le modèle a encore tendance à simplifier les tests complexes comportant beaucoup d'étapes, et pour les scénarios d'UI, il lui faut davantage de contexte, par exemple des informations sur les objets de la page. Les hallucinations n'ont pas disparu non plus, la vérification finale reste donc obligatoire. Les auteurs précisent par ailleurs n'avoir constaté aucune limitation sérieuse liée au langage : des résultats similaires ont été obtenus non seulement en Java, mais aussi en Python et en Gherkin. D'après leur estimation, un tel outil peut faire gagner à l'ingénieur en automatisation plus de la moitié du temps passé à écrire de nouveaux tests routiniers.
Ce que cela signifie
Pour les outils d'IA dédiés au développement, une étape plus intéressante commence : la valeur se déplace de « générer n'importe quel code » vers « générer du code qui s'intègre aussitôt dans un projet vivant ». Le cas de Sber suggère qu'en QA, les gagnants ne seront pas les équipes qui branchent simplement un LLM à l'IDE, mais celles qui entourent le modèle de leur propre base de connaissances, de vérifications et de règles d'ingénierie.
Questions clés sur cet article
Pourquoi un prompt direct ne fonctionne pas?
L'idée d'« envoyer simplement le test manuel au modèle et d'obtenir du code prêt à l'emploi » se heurte aux détails. Un LLM peut bien produire un test Java fonctionnel, mais presque à coup sûr pas comme on le fait dans une équipe donnée : il oubliera Allure, enfreindra le schéma de nommage, placera l'URL et le corps de la requête au mauvais endroit, ajoutera des vérifications superflues ou n'utilisera pas les utilitaires internes, comme une méthode commune de contrôle du statut. En automatisation des tests, ce n'est pas cosmétique : c'est une perte réelle de compatibilité a
Comment fonctionne RAG?
À la place d'un few-shot statique avec des exemples choisis à la main, l'équipe de Sber a conçu un plugin pour les IDE de JetBrains. Il analyse le projet via la structure PSI, et non comme du texte brut, ce qui lui permet de voir les classes, méthodes, annotations et appels. Sur cette base, le système collecte les étapes Allure, les tests automatisés existants, leurs clés TMS, le code et de courtes descriptions textuelles. Ces descriptions sont ensuite converties en embeddings et stockées avec leurs métadonnées dans une base de connaissances locale ou un magasin vectoriel.
Que sait-on sur Résultats du prototype ?
Selon l'équipe, le prototype interne a déjà produit un effet mesurable. Environ 68 % des tests générés étaient d'un niveau acceptable et n'ont demandé que des retouches minimes, et la satisfaction globale des utilisateurs s'établit à environ 80 %. L'outil s'est montré le plus efficace sur des scénarios d'API simples et semblables, où il importe surtout de reproduire vite un modèle de code établi sans copier à la main depuis des tests voisins. Les ingénieurs en automatisation ont aussi noté une charge cognitive réduite : moins de temps passé sur la routine, davantage sur les
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.