Leman Tech montre comment elle a combiné LLM, RAG et ML classique dans son support technique
Leman Tech explique comment elle a remanié son support après la hausse du nombre de demandes : la classification de masse est restée au ML classique, et le LLM avec RAG n'est activé que pour les requêtes complexes propres à un domaine, dans l'environnement d'entreprise. Cette approche a porté la classification automatisée à 76 %, accéléré les réponses réussies de plus de 20 fois et soulagé les spécialistes les plus coûteux, sans risque supplémentaire, sans retards ni automatisation aveugle.
Traité par IA depuis Habr AI ; édité par Hamidun News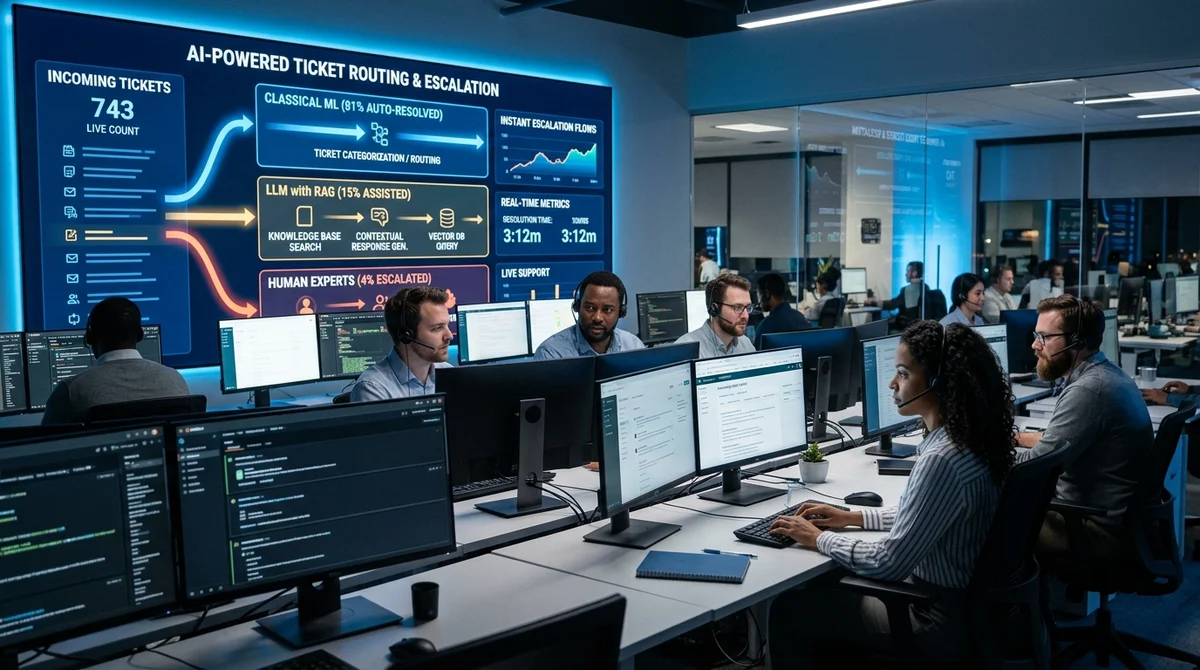
Leman Tech explique comment elle a remanié l'automatisation de son Service Desk après la hausse du flux de demandes. L'entreprise n'a pas remplacé tout le support par un seul gros modèle : elle a monté un dispositif hybride, en laissant la classification de masse au ML classique et en ne faisant appel au LLM avec RAG que là où il apporte un vrai bénéfice.
Pourquoi l'ancien ML ne suffit plus
L'écosystème de Leman Tech compte plus de 500 systèmes métier, 2500 opérations de service et environ 100 mille demandes de support par mois. Avec une telle charge, la qualité du modèle ne suffit pas : le coût d'une erreur, la vitesse de réaction et le coût de calcul comptent aussi.
La pile de base, avec boosting et TF-IDF, a bien fonctionné longtemps. Un modèle enrichi de variables comme le poste, le lieu de travail et l'heure de la demande atteignait un F1 d'environ 0,86 et couvrait une grande part des routes standard. Mais à mesure que le nombre de scénarios augmentait, cela n'a plus suffi.
L'équipe a testé LSTM, GRU, BERT, RoBERTa, Electra, Yandex Foundation Models et des adaptateurs LoRA pour LLM ouverts. Certaines approches ont perdu face au boosting sur les métriques, d'autres se sont révélées trop coûteuses à entraîner. Au final, le meilleur résultat en classification n'est pas venu d'une approche LLM « pure », mais d'un transformer avec des variables tabulaires supplémentaires et de l'additive attention : ce dispositif a porté le F1 macro à 0,89 et a mieux pris en compte le contexte de chaque employé.
Où le RAG est activé
Dans cette architecture, le LLM n'essaie pas de tout résoudre. Il n'est activé que dans les classes de demandes où l'utilisateur a besoin d'une réponse pertinente fondée sur la documentation interne, et pas seulement d'un bon routage du ticket.
Un exemple : le support de la plateforme MLOps, où les employés attendent des réponses sur Kubeflow, Jenkins et les pipelines internes. Ici, la demande arrive dans le chat, passe par le classifieur et entre dans un circuit RAG fondé sur Qwen2.5 8B avec un embedder sur mesure. Si la réponse figure dans la base de connaissances, l'utilisateur la reçoit en 60 secondes environ. Si le modèle n'est pas sûr du résultat, ou si la personne utilise la commande pour passer à un spécialiste, le ticket part directement chez un expert humain, sans attendre selon le SLA habituel.
C'est un point important : le LLM n'est pas posé comme une barrière supplémentaire devant la personne, mais sert de première couche rapide, là où l'on peut économiser le temps des coûteux spécialistes L4 sans perdre le contrôle de la qualité.
- Qwen2.5 8B est utilisé dans une version quantifiée pour CPU
- L'embedder sur mesure a été entraîné sur 10 mille triplets
- La précision de la recherche dans la base de connaissances a atteint 92 % en Hit@3
- L'escalade se déclenche lorsque le confidence score passe sous 0,7
- L'utilisateur peut basculer instantanément vers un humain
Ce qui a le mieux fonctionné
Une partie à part du cas concerne les autorésolutions. L'équipe a repéré des modèles de demandes récurrents qui peuvent être clos sans intervention du support, mais elle n'a pas automatisé aveuglément toutes les réponses fréquentes. Pour la sélection, elle a utilisé Qwen2.5 14B : le modèle évaluait si une personne pouvait réellement résoudre seule le problème en suivant la consigne, ou si rien ne marcherait sans un employé. Cela a écarté de faux modèles, comme la réinitialisation de mot de passe, où l'e-mail est standard mais où l'action doit tout de même être exécutée par un spécialiste.
«
Il ne faut pas utiliser des LLM partout, comme c'est la mode en ce moment. »
Après cette sélection, c'est de nouveau non pas un LLM qui tourne en production, mais un modèle léger : la régression logistique. Elle apprend vite, ne coûte presque rien en inférence et peut traiter en continu le flux de demandes.
En résultat, Leman Tech fait état d'une hausse de la classification automatisée de 55 % à 76 %, d'une précision de classification montée à 92 % en tenant compte des seuils, et d'une accélération de plus de 20 fois des autorésolutions réussies et des réponses du bot. Le LLM n'a pas remplacé le ML classique ici : il a pris une place étroite mais précieuse dans la chaîne.
Ce que cela signifie
Le cas de Leman Tech illustre bien la logique mûre actuelle d'adoption de l'IA générative dans le support : les LLM coûteux n'ont pas à former le cœur de tout le système. Le meilleur résultat vient souvent d'un hybride, où le ML classique trie vite le flux, où le RAG ne répond que dans les zones de domaine complexes, et où un humain intervient sans friction si la confiance du modèle est insuffisante. Pour les équipes en entreprise, c'est probablement une voie plus réaliste que de vouloir basculer tout le Service Desk sur un seul modèle universel.
Questions clés sur cet article
Pourquoi l'ancien ML ne suffit plus?
L'écosystème de Leman Tech compte plus de 500 systèmes métier, 2500 opérations de service et environ 100 mille demandes de support par mois. Avec une telle charge, la qualité du modèle ne suffit pas : le coût d'une erreur, la vitesse de réaction et le coût de calcul comptent aussi. La pile de base, avec boosting et TF-IDF, a bien fonctionné longtemps. Un modèle enrichi de variables comme le poste, le lieu de travail et l'heure de la demande atteignait un F1 d'environ 0,86 et couvrait une grande part des routes standard. Mais à mesure que le nombre de scénarios augmentait, c
Que sait-on sur Où le RAG est activé ?
Dans cette architecture, le LLM n'essaie pas de tout résoudre. Il n'est activé que dans les classes de demandes où l'utilisateur a besoin d'une réponse pertinente fondée sur la documentation interne, et pas seulement d'un bon routage du ticket. Un exemple : le support de la plateforme MLOps, où les employés attendent des réponses sur Kubeflow, Jenkins et les pipelines internes. Ici, la demande arrive dans le chat, passe par le classifieur et entre dans un circuit RAG fondé sur Qwen2.5 8B avec un embedder sur mesure. Si la réponse figure dans la base de connaissances, l'util
Que sait-on sur Ce qui a le mieux fonctionné ?
Une partie à part du cas concerne les autorésolutions. L'équipe a repéré des modèles de demandes récurrents qui peuvent être clos sans intervention du support, mais elle n'a pas automatisé aveuglément toutes les réponses fréquentes. Pour la sélection, elle a utilisé Qwen2.5 14B : le modèle évaluait si une personne pouvait réellement résoudre seule le problème en suivant la consigne, ou si rien ne marcherait sans un employé. Cela a écarté de faux modèles, comme la réinitialisation de mot de passe, où l'e-mail est standard mais où l'action doit tout de même être exécutée par
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.