NVIDIA et PNY misent sur la RTX PRO 6000 Blackwell pour l'analyse de données et le développement d'IA
PNY met en avant des stations de travail équipées de la NVIDIA RTX PRO 6000 Blackwell pour remplacer les systèmes à base de CPU en data science. Ses principaux arguments : jusqu'à 50 fois plus de vitesse sur pandas via cuDF sans réécrire le code, un temps d'entraînement de XGBoost réduit et la possibilité d'installer jusqu'à quatre GPU dans une seule machine. Le pari repose sur le traitement local des données, une moindre dépendance au cloud et la maîtrise des coûts.
Traité par IA depuis IEEE Spectrum AI ; édité par Hamidun News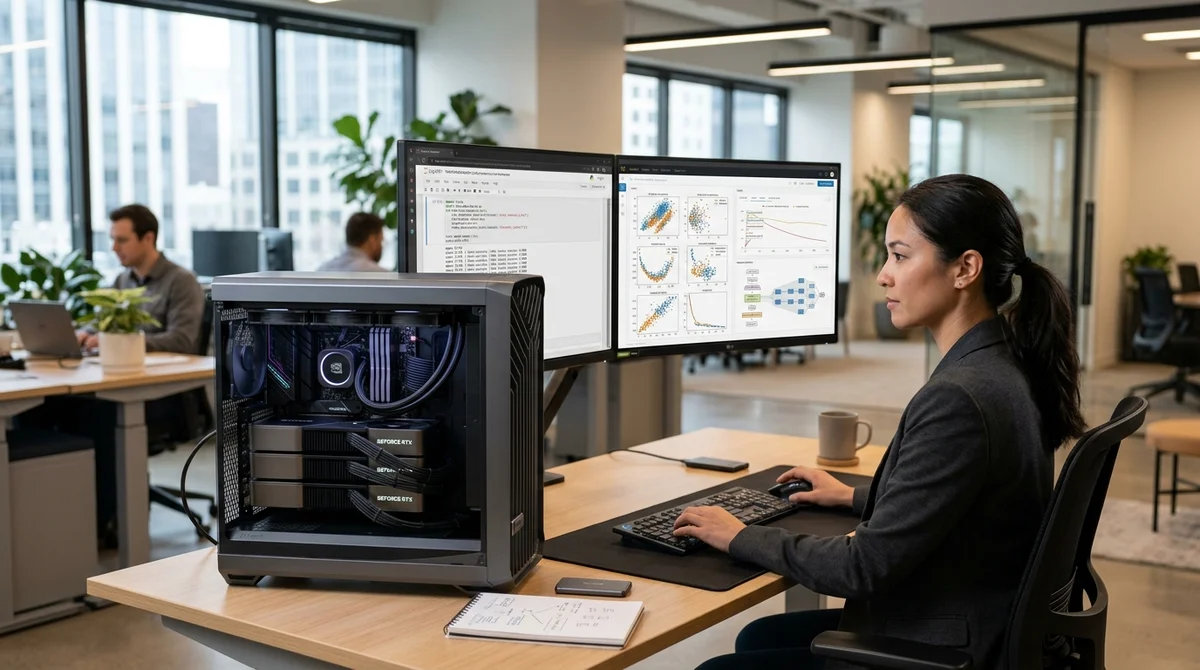

Dans un contenu sponsorisé pour IEEE Spectrum, PNY présente la NVIDIA RTX PRO 6000 Blackwell Workstation Edition comme une alternative locale au cloud et aux centres de données pour les tâches de data science. L'argument central : une partie des pipelines lourds d'IA et d'analyse peut être accélérée de plusieurs dizaines de fois directement sur le poste de travail.
Pourquoi le CPU ne suffit pas
Le propos repose sur trois goulots d'étranglement que connaissent la plupart des équipes de data science. Le premier est la préparation des données : nettoyage, jointure de tables, remplissage des valeurs manquantes et création de variables absorbent souvent l'essentiel du temps avant l'entraînement du modèle. Le deuxième est l'échelle : les volumes croissent plus vite que les machines de bureau à base de CPU ne parviennent à les digérer, si bien que les équipes réduisent parfois leurs échantillons et perdent en qualité de résultat. Le troisième est le matériel : l'accès aux accélérateurs dans le cloud et les centres de données est coûteux et, par endroits, limité.
Dans ce contexte, NVIDIA et PNY proposent de ramener une partie de la charge vers des stations de travail locales. L'idée est simple : si un analyste ou un ingénieur ML dispose sous son bureau d'une machine à plusieurs GPU, il dépend moins des files d'attente de l'infrastructure partagée, teste ses hypothèses plus vite et ne fait pas sortir de données sensibles. Pour les équipes en entreprise, cela est présenté comme un compromis entre vitesse, confidentialité et maîtrise des coûts.
Ce que promet Blackwell
L'accent est mis sur l'accélération de toute la chaîne, des opérations pandas à l'entraînement des modèles. Selon NVIDIA, la bibliothèque cuDF de la pile CUDA-X peut accélérer les pipelines Python sans réécriture du code, et son association avec PyData et XGBoost devrait réduire sensiblement le temps d'analyse exploratoire et d'entraînement. La plateforme est aussi conçue pour les usages multiutilisateurs, la visualisation avancée et le travail collaboratif via NVIDIA AI Workbench, afin qu'un même projet puisse tourner sur une machine locale, dans le cloud et dans un centre de données.
- jusqu'à quatre GPU RTX PRO 6000 Blackwell Max-Q dans une seule station de travail
- accélération de pandas via cuDF sans modifier le code, jusqu'à 50 fois selon l'entreprise
- opération join : près de 5 minutes sur CPU contre 14 secondes sur GPU
- group by : près de 4 minutes sur CPU contre 4 secondes sur GPU
- entraînement de XGBoost qui prenait auparavant des semaines, que l'entreprise promet de ramener à quelques minutes
« le GPU de bureau le plus puissant jamais conçu »
Le ton marketing de la publication est direct : c'est ainsi que PNY décrit la RTX PRO 6000 Blackwell dans la vidéo qui l'accompagne. L'affirmation est forte, mais le contenu ne comporte ni tests indépendants ni comparaison avec des alternatives dans une configuration identique. Mieux vaut donc considérer ces chiffres comme un repère donné par le fabricant : ils montrent le type de tâches où un GPU apporte réellement un gain, mais ne remplacent pas un vrai benchmark sur votre propre stack et vos données.
Le pari du local
Un autre argument tient à l'économie et à la sécurité. Quand une partie du pipeline passe du cloud à la station de travail, l'entreprise paie moins pour la location de calcul et le stockage, et les jeux de données sensibles restent dans son périmètre. Pour les secteurs soumis à des exigences de traitement on-premise, cela compte davantage que la performance brute. Une machine locale réduit aussi la dépendance à la pénurie de GPU dans les centres de données : on attend moins souvent un créneau d'entraînement ou la validation d'un budget distinct.
PNY insiste aussi sur la dimension entreprise : intégration à l'infrastructure informatique existante, solutions réseau NVIDIA ConnectX, outils de déploiement et haute disponibilité. Le message est clair : la RTX PRO 6000 Blackwell n'est pas vendue comme une « carte pour passionnés », mais comme une brique pour le développement d'IA en entreprise. En particulier pour les équipes qui ont besoin d'itérations rapides sur de gros jeux de données, mais qui ne sont pas prêtes à basculer entièrement dans le cloud ni à se disputer en permanence les ressources d'un cluster partagé.
Ce que cela signifie
Le marché du matériel d'IA passe de plus en plus des promesses universelles à un scénario précis : offrir à une équipe de data science des performances dignes d'un centre de données directement sur son poste de travail. Si les accélérations annoncées se confirment sur des charges réelles, ces stations pourraient devenir une couche intermédiaire entre l'ordinateur portable de l'analyste et un cluster de GPU coûteux. Mais il vaut mieux les acheter après des essais sur ses propres pipelines, et non sur la foi d'un benchmark publicitaire.
- 1 nov. 2026Les modèles locaux battus par Opus et Codex : 0,21 sur MacBook contre 1,00 pour Codex
- 1 nov. 2026Un auteur de Habr affine YOLOv8l sur des radiographies dentaires et atteint un mAP50 de 0,642
- 1 nov. 2026Les bots vocaux à base de LLM s'appuient sur le classifieur rapide Jev : une décision en 200–500 ms
- 1 nov. 2026La couche de protection MoneyGate n'a laissé passer aucune des 42 demandes frauduleuses adressées à des IA locales
Questions clés sur cet article
Pourquoi le CPU ne suffit pas?
Le propos repose sur trois goulots d'étranglement que connaissent la plupart des équipes de data science. Le premier est la préparation des données : nettoyage, jointure de tables, remplissage des valeurs manquantes et création de variables absorbent souvent l'essentiel du temps avant l'entraînement du modèle. Le deuxième est l'échelle : les volumes croissent plus vite que les machines de bureau à base de CPU ne parviennent à les digérer, si bien que les équipes réduisent parfois leurs échantillons et perdent en qualité de résultat. Le troisième est le matériel : l'accès au
Que sait-on sur Ce que promet Blackwell ?
L'accent est mis sur l'accélération de toute la chaîne, des opérations pandas à l'entraînement des modèles. Selon NVIDIA, la bibliothèque cuDF de la pile CUDA-X peut accélérer les pipelines Python sans réécriture du code, et son association avec PyData et XGBoost devrait réduire sensiblement le temps d'analyse exploratoire et d'entraînement. La plateforme est aussi conçue pour les usages multiutilisateurs, la visualisation avancée et le travail collaboratif via NVIDIA AI Workbench, afin qu'un même projet puisse tourner sur une machine locale, dans le cloud et dans un centre
Que sait-on sur Le pari du local ?
Un autre argument tient à l'économie et à la sécurité. Quand une partie du pipeline passe du cloud à la station de travail, l'entreprise paie moins pour la location de calcul et le stockage, et les jeux de données sensibles restent dans son périmètre. Pour les secteurs soumis à des exigences de traitement on-premise, cela compte davantage que la performance brute. Une machine locale réduit aussi la dépendance à la pénurie de GPU dans les centres de données : on attend moins souvent un créneau d'entraînement ou la validation d'un budget distinct. PNY insiste aussi sur la dim
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.