L'algorithme TurboQuant de Google fait chuter les actions des fabricants de mémoire après la publication de l'étude
Google a présenté TurboQuant, une méthode de compression du KV cache pour les LLM qui réduit l'usage de mémoire d'au moins six fois et, selon l'entreprise, ne dégrade pas la qualité. Le marché a réagi en quelques heures : les actions de Micron, Western Digital et SanDisk ont reculé, car les investisseurs ont immédiatement recalculé la demande future de mémoire pour l'IA. Si l'approche s'impose, l'inférence pourrait devenir nettement moins chère. La méthode compresse le KV cache à 3 bits par valeur au lieu des 16 bits standard, sans réentraînement ni fine-tuning.
Traité par IA depuis TNW ; édité par Hamidun News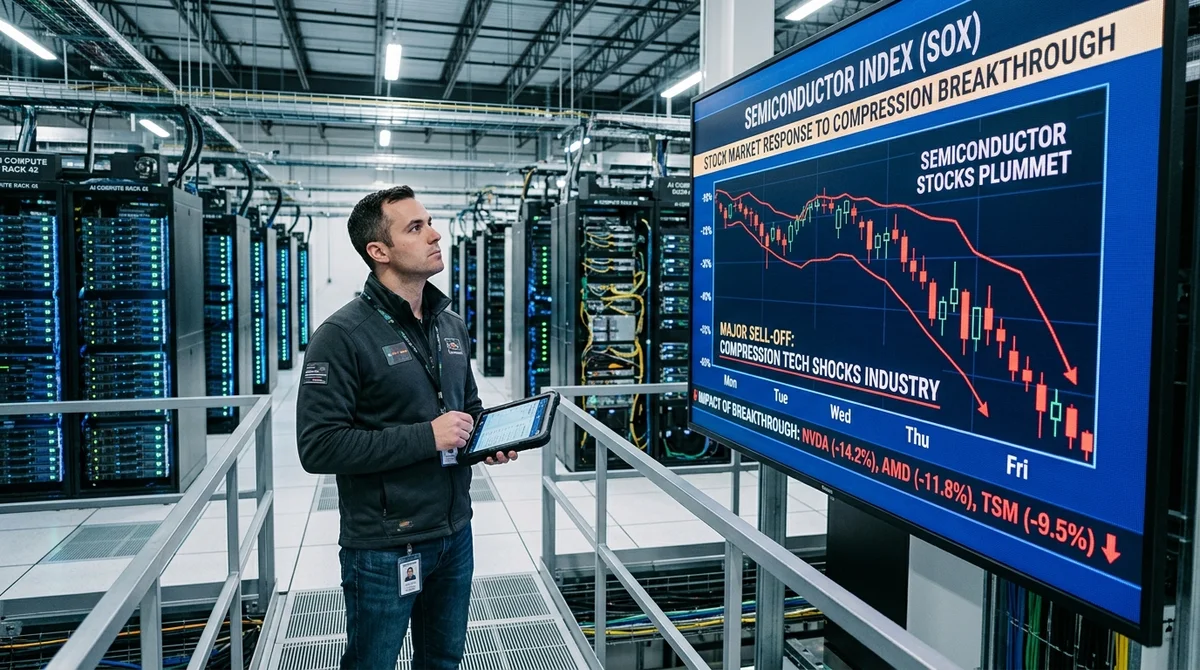
Google Research a dévoilé TurboQuant, un algorithme de compression pour les modèles d'IA qui réduit d'au moins six fois le volume de la mémoire de travail clé, sans perte de qualité notable. Le marché a réagi instantanément : après la publication du 24 mars 2026, les investisseurs ont commencé à réévaluer la quantité de mémoire dont l'industrie de l'IA générative aura réellement besoin.
Ce que Google a montré
TurboQuant s'attaque à un point étroit mais coûteux de l'inférence des grands modèles de langage : le key-value cache, ou KV cache. C'est le stockage du contexte, qui évite au modèle de recalculer les tokens déjà traités. Plus la requête, le document ou la conversation est long, plus ce cache grossit vite et plus il occupe de mémoire GPU.
Selon Google, la nouvelle méthode compresse le KV cache à 3 bits par valeur au lieu des 16 bits standard et réduit la consommation de mémoire d'au moins six fois.
En pratique, cela compte autant que pour la recherche. La mémoire libérée permet de servir davantage de requêtes simultanées sur le même matériel, d'utiliser des fenêtres de contexte plus longues ou des modèles plus gros sans agrandir le parc d'accélérateurs. Les auteurs écrivent que TurboQuant ne nécessite ni réentraînement ni fine-tuning et sera présenté à l'ICLR 2026. Les tests ont porté sur les familles de modèles Gemma, Mistral et Llama, ainsi que sur des benchmarks standard de contexte long.
Comment fonctionne l'algorithme
TurboQuant repose sur un schéma en deux étapes. D'abord, la méthode PolarQuant convertit les vecteurs en représentation polaire pour supprimer les données auxiliaires superflues, qui grignotent d'ordinaire une partie du gain de la quantification classique. Ensuite intervient QJL, une technique qui encode l'erreur résiduelle avec un seul bit supplémentaire par dimension et réduit les distorsions dans l'attention. Résultat : l'essentiel du budget de bits sert à préserver le sens des données d'origine plutôt que l'overhead technique.
Google qualifie le KV cache d'« aide-mémoire numérique à haute vitesse » pour le modèle.
- compression du KV cache de 16 à 3 bits
- réduction de la mémoire d'au moins 6 fois
- jusqu'à 8 fois plus rapide pour le calcul de l'attention sur Nvidia H100 en mode 4 bits
- fonctionne sans entraînement ni fine-tuning
- applicable non seulement aux LLM mais aussi à la recherche vectorielle
Google affirme que sur les tâches Needle in a Haystack, TurboQuant a conservé un résultat parfait même avec un cache compressé six fois. Sur LongBench et ZeroSCROLLS, la méthode a aussi égalé ou dépassé KIVI, l'une des approches de référence connues pour la quantification du KV cache. Séparément, l'entreprise a testé TurboQuant sur la recherche vectorielle et obtenu un recall plus élevé, sans gros codebooks ni ajustement à un jeu de données précis. C'est un terrain d'intérêt direct pour la recherche, les recommandations et les systèmes publicitaires.
Pourquoi le marché a réagi
La Bourse n'a pas lu cette publication comme une avancée académique, mais comme un signal de baisse possible de la demande de mémoire pour l'infrastructure d'IA. Dans les heures qui ont suivi la publication, l'action Micron a reculé de 3 %, Western Digital de 4,7 % et SanDisk de 5,7 %.
La logique est simple : si un composant clé de l'inférence exige soudain plusieurs fois moins de mémoire, les achats futurs de HBM, de DRAM et de stockage pourraient paraître moins linéaires que ne le prévoyaient les investisseurs.
Mais cela ne signifie pas que l'industrie aura soudain besoin de six fois moins de matériel. La mémoire n'est qu'un poste de dépense des centres de données, et l'appétit des modèles pour le calcul croît plus vite que n'importe quelle optimisation locale. Même les analystes mettent en garde contre des conclusions trop directes : des algorithmes de compression existaient déjà, mais ils n'ont pas fait s'effondrer la demande d'infrastructure dans son ensemble. L'histoire de l'informatique montre plus souvent l'effet inverse : quand les ressources deviennent moins chères, les entreprises construisent des systèmes plus lourds et plus massifs avec le même budget.
Ce que cela signifie
TurboQuant n'est pas une raison de rayer les fabricants de mémoire, mais un indicateur précoce d'une nouvelle étape dans la course à l'efficacité. Les gagnants ne seront plus seulement ceux qui achètent plus de GPU, mais aussi ceux qui savent comprimer davantage l'inférence sans perdre en qualité. Pour les produits d'IA, c'est l'occasion de réduire le coût par requête ; pour le marché, un rappel que le logiciel pèse déjà sur la capitalisation du matériel.
- 12 nov. 2026Google ouvre les précommandes de lunettes Gemini à partir de 395 $ et bloque la prise de vue discrète
- 12 nov. 2026Google apporte Gemini Intelligence à Android Auto — pour l'instant uniquement sur Pixel
- 12 nov. 2026Selon une plainte, une collégienne a parlé de suicide avec Gemini pendant trois mois, tandis que la surveillance est restée muette des semaines
- 12 nov. 2026Google et Adobe rapprochent leurs produits : Acrobat arrive dans Gmail, Drive et Gemini
Questions clés sur cet article
Que sait-on sur Ce que Google a montré ?
TurboQuant s'attaque à un point étroit mais coûteux de l'inférence des grands modèles de langage : le key-value cache, ou KV cache. C'est le stockage du contexte, qui évite au modèle de recalculer les tokens déjà traités. Plus la requête, le document ou la conversation est long, plus ce cache grossit vite et plus il occupe de mémoire GPU. Selon Google, la nouvelle méthode compresse le KV cache à 3 bits par valeur au lieu des 16 bits standard et réduit la consommation de mémoire d'au moins six fois.
Comment fonctionne l'algorithme?
TurboQuant repose sur un schéma en deux étapes. D'abord, la méthode PolarQuant convertit les vecteurs en représentation polaire pour supprimer les données auxiliaires superflues, qui grignotent d'ordinaire une partie du gain de la quantification classique. Ensuite intervient QJL, une technique qui encode l'erreur résiduelle avec un seul bit supplémentaire par dimension et réduit les distorsions dans l'attention.
Pourquoi le marché a réagi?
La Bourse n'a pas lu cette publication comme une avancée académique, mais comme un signal de baisse possible de la demande de mémoire pour l'infrastructure d'IA. Dans les heures qui ont suivi la publication, l'action Micron a reculé de 3 %, Western Digital de 4,7 % et SanDisk de 5,7 %. La logique est simple : si un composant clé de l'inférence exige soudain plusieurs fois moins de mémoire, les achats futurs de HBM, de DRAM et de stockage pourraient paraître moins linéaires que ne le prévoyaient les investisseurs.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.