Qdrant et DRAG with KNEE : rendre le RAG adaptatif sans gaspiller de tokens
Une nouvelle analyse s'attaque au déséquilibre central du RAG classique : soit le modèle reçoit trop peu de contexte, soit un pavé de texte dont il n'a pas besoin. L'approche DRAG with KNEE, fondée sur Qdrant et Python, organise les documents en hiérarchie, cherche un point d'inflexion dans la pertinence et coupe la queue de fragments non pertinents. L'idée : donner au modèle exactement le contexte qu'exige chaque requête.
Traité par IA depuis Habr AI ; édité par Hamidun News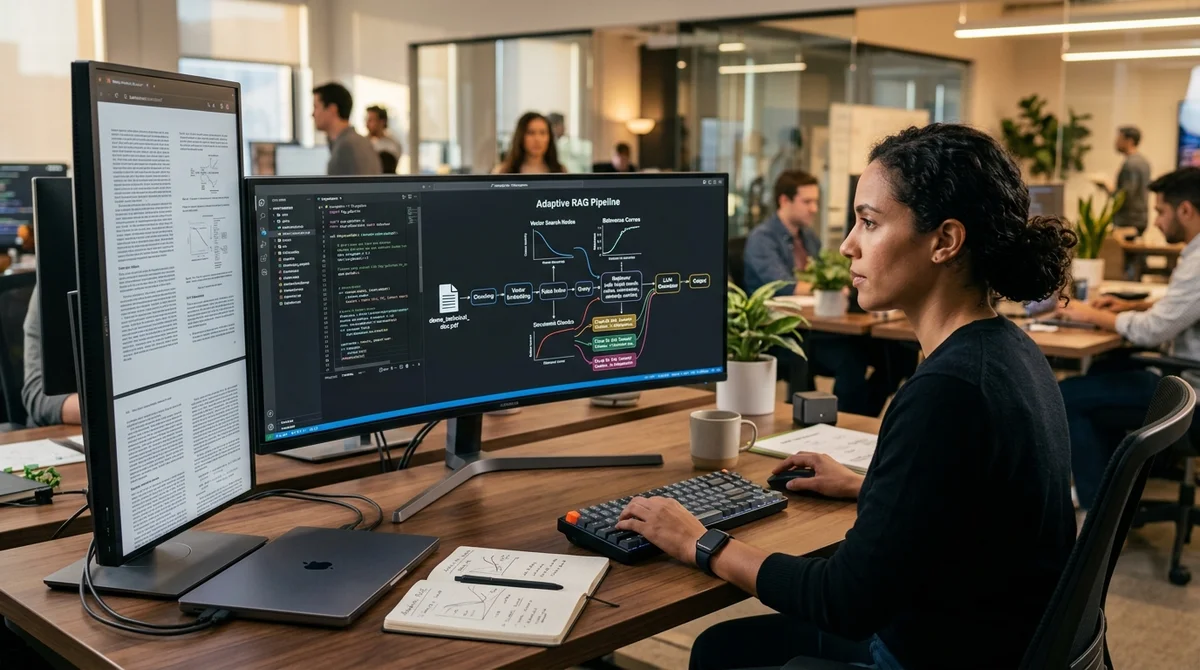
Une analyse pratique vient de paraître sur la façon de rendre un système RAG moins gourmand et plus précis. Elle est centrée sur DRAG with KNEE, une approche fondée sur Qdrant et Python qui ajuste dynamiquement le volume de contexte au lieu de s'appuyer sur un top_k fixe.
Pourquoi le top_k statique pose problème
Presque tous ceux qui ont monté un RAG sur de longs PDF ont rencontré le même problème. Si l'on récupère trop peu de chunks, le modèle ne voit pas un contexte important et se met à extrapoler. Si l'on en récupère trop, le prompt se remplit de bruit, et avec lui grimpent le coût, la latence et le risque que le LLM s'accroche à un fragment aléatoire. Dans ce schéma, un seul paramètre top_k tente de résoudre des tâches très différentes, et s'en acquitte presque toujours mal.
L'auteur qualifie ce compromis de faiblesse fondamentale du RAG classique. Un nombre fixe de documents ignore le type de requête, la structure du fichier source et la densité d'informations utiles dans le corpus. Pour un fait bref, quelques passages peuvent suffire, mais pas pour une question complexe sur un document de plusieurs pages. Résultat : le système sous-alimente le modèle en contexte ou, à l'inverse, le surcharge de texte non pertinent et brûle le budget de tokens.
Comment fonctionne DRAG
L'idée de DRAG with KNEE n'est pas seulement de chercher des morceaux similaires, mais de regarder d'abord les documents comme une hiérarchie, puis de décider dynamiquement où arrêter la sélection. Plutôt qu'une limite rigide, l'algorithme analyse la distribution de la pertinence et cherche un point d'inflexion, le « coude » au-delà duquel chaque fragment ajouté apporte de moins en moins. Tout ce qui se trouve dans la longue queue après ce point peut être écarté sans perte de sens notable.
En pratique, cela donne une stratégie d'extraction de contexte plus adaptative. Le système n'est pas tenu de renvoyer le même nombre de chunks pour chaque requête : trois dans un cas, dix dans un autre, et dans un troisième plusieurs groupes liés issus de différentes parties du document. Le RAG s'ajuste ainsi à la structure réelle des connaissances, et non à une constante choisie à l'avance.
- D'abord, les candidats sont trouvés par proximité vectorielle
- Ensuite, ils sont regroupés et ordonnés par document et par niveau
- L'algorithme cherche alors le point où l'utilité commence à chuter brutalement
- Seul le noyau pertinent, sans la longue queue de bruit, entre dans le contexte final
Cette approche est particulièrement utile lorsque les connaissances ne sont pas rangées dans une base FAQ bien nette, mais dispersées dans des consignes, des rapports, des règlements et de gros PDF. Dans de tels corpus, les distances entre fragments disent peu de choses à elles seules si l'on ne tient pas compte de la manière dont ils sont reliés et de la vitesse à laquelle leur valeur pour la réponse s'effondre. C'est là que l'analyse géométrique cesse d'être un ornement mathématique pour devenir un filtre pratique.
Pourquoi Qdrant
Un point fort de l'article : il ne sombre pas dans la théorie pure. L'auteur montre comment construire ce pipeline avec Qdrant et Python, une pile familière déjà utilisée dans de nombreux projets RAG. Qdrant assure la recherche vectorielle et le travail sur les candidats, tandis que la logique de DRAG with KNEE ajoute par-dessus une couche d'adaptation : non pas simplement trouver ce qui est similaire, mais déterminer combien de ce contenu le modèle a réellement besoin de recevoir maintenant.
Pour les équipes qui ont déjà déployé un retrieval classique et butent sur la qualité des réponses ou sur le coût d'inférence, c'est un signal important. Le problème peut ne résider ni dans les embeddings ni dans le LLM lui-même, mais dans la manière de découper et de fournir le contexte. Remplacer le top_k statique par une coupure dynamique au point d'inflexion peut réduire le bruit et améliorer la précision à la fois, sans refonte complète de l'architecture.
Ce que cela signifie
Le RAG s'éloigne peu à peu du réglage grossier d'un paramètre unique pour tous les cas. Le matériel sur DRAG with KNEE illustre un changement simple mais important : le prochain palier de qualité ne tient pas seulement à une bonne recherche, mais aussi à l'art de s'arrêter à temps, afin que le LLM reçoive assez de contexte pour répondre, et non un excès aléatoire de texte.
Questions clés sur cet article
Pourquoi le top_k statique pose problème?
Presque tous ceux qui ont monté un RAG sur de longs PDF ont rencontré le même problème. Si l'on récupère trop peu de chunks, le modèle ne voit pas un contexte important et se met à extrapoler. Si l'on en récupère trop, le prompt se remplit de bruit, et avec lui grimpent le coût, la latence et le risque que le LLM s'accroche à un fragment aléatoire. Dans ce schéma, un seul paramètre top_k tente de résoudre des tâches très différentes, et s'en acquitte presque toujours mal. L'auteur qualifie ce compromis de faiblesse fondamentale du RAG classique. Un nombre fixe de documents
Comment fonctionne DRAG?
L'idée de DRAG with KNEE n'est pas seulement de chercher des morceaux similaires, mais de regarder d'abord les documents comme une hiérarchie, puis de décider dynamiquement où arrêter la sélection. Plutôt qu'une limite rigide, l'algorithme analyse la distribution de la pertinence et cherche un point d'inflexion, le « coude » au-delà duquel chaque fragment ajouté apporte de moins en moins. Tout ce qui se trouve dans la longue queue après ce point peut être écarté sans perte de sens notable. En pratique, cela donne une stratégie d'extraction de contexte plus adaptative. Le sy
Pourquoi Qdrant?
Un point fort de l'article : il ne sombre pas dans la théorie pure. L'auteur montre comment construire ce pipeline avec Qdrant et Python, une pile familière déjà utilisée dans de nombreux projets RAG. Qdrant assure la recherche vectorielle et le travail sur les candidats, tandis que la logique de DRAG with KNEE ajoute par-dessus une couche d'adaptation : non pas simplement trouver ce qui est similaire, mais déterminer combien de ce contenu le modèle a réellement besoin de recevoir maintenant. Pour les équipes qui ont déjà déployé un retrieval classique et butent sur la qual
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.