Raft décortique les endroits où MCP et Thin MCP ajoutent de la latence aux agents IA
L'équipe de Raft a analysé où les agents IA perdent précisément en vitesse lorsqu'ils passent par MCP. Ses tests montrent que MCP seul ajoute environ 10 ms dans le processus, et que l'essentiel du ralentissement vient du réseau, de la sérialisation et des sauts superflus entre services. Thin MCP simplifie l'architecture, mais ne garantit pas d'accélération. Les meilleurs résultats viennent d'un schéma asynchrone et d'une organisation plus soignée des services backend.
Traité par IA depuis Habr AI ; édité par Hamidun News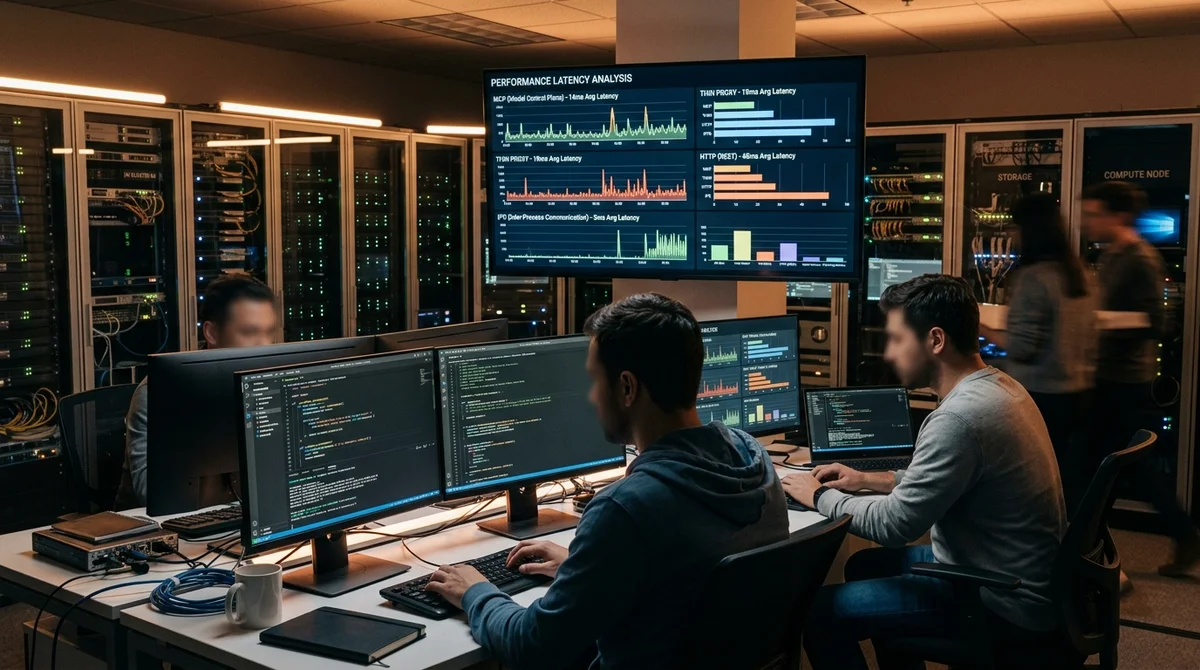
MCP est souvent présenté comme une manière universelle de brancher proprement des outils à une application LLM, mais en pratique cette modularité se paie en latence. Dans une nouvelle analyse, Raft a comparé plusieurs architectures et montré que le problème ne vient généralement pas d'un composant précis, mais de la façon dont est conçu tout le trajet de la requête, de l'agent à l'outil et retour.
D'où vient la latence
L'auteur est parti d'une question simple : combien de latence MCP ajoute-t-il à lui seul si l'on supprime le réseau et que l'on garde tout dans un seul processus ? Pour le savoir, il a comparé un monolithe sans MCP à un monolithe avec MCP in-process. Le motif s'avère n'induire qu'un overhead relativement faible : environ 10–11 ms en moyenne, jusqu'à 35 ms par moments. C'est un point de départ important : si un agent rame pendant des centaines de millisecondes, le coupable n'est généralement pas l'usage de MCP en lui-même, mais la couche externe qui l'entoure.
La comparaison a ensuite été transposée dans une architecture plus réaliste, où les serveurs MCP sont déportés dans des conteneurs Docker distincts. Le tableau change nettement : la latence supplémentaire moyenne des principaux outils grimpe à environ 169 ms par appel. Pourtant, les traces montrent que ce n'est pas encore le principal poste de consommation de temps. Les étapes les plus lourdes sont l'obtention des embeddings et le travail du reranker, tandis que la recherche dans la base vectorielle prend comparativement peu de temps. Autrement dit, MCP a un coût, mais n'est pas toujours le principal goulot d'étranglement de la chaîne.
Ce que les tests ont montré
L'article examine plusieurs scénarios pour isoler l'influence du transport, de la sérialisation et du runtime lui-même.
- S1, MCP in-process : environ 10–11 ms de latence supplémentaire, ce qui signifie que le runtime est relativement léger.
- S2, MCP séparés via le réseau Docker : en moyenne environ 169 ms d'overhead par appel, à cause du réseau, de la sérialisation et de la communication inter-processus.
- S3a, Thin MCP via HTTP + JSON : sur une série de mesures, l'overhead est tombé à environ 128 ms, mais le résultat s'est révélé instable et, lors d'exécutions répétées, pouvait être nettement moins bon.
- S3b, Thin MCP via HTTP + YAML : la latence est montée à environ 274 ms, ce qui indique le coût supplémentaire de la sérialisation et de la désérialisation.
- S4 et S5 : ZeroMQ a donné environ 200 ms, mais avec un comportement plus prévisible, tandis qu'un runtime C++ a ramené l'overhead à environ 130–145 ms, sans changement radical d'ordre de grandeur.
L'enseignement principal de ces chiffres : les optimisations intuitives ne fonctionnent pas toujours comme on l'attend. Remplacer JSON par YAML n'a pas accéléré le système, mais l'a dégradé. Passer de HTTP à l'IPC n'a pas non plus été une victoire automatique : l'implémentation avec iceoryx2 n'a pas montré le gain espéré, et seule la variante ZeroMQ s'est révélée réellement plus utile, grâce à son modèle asynchrone. Même C++ n'a aidé que modérément, pas de façon spectaculaire.
Pourquoi thin ne sauve pas la mise
Dans l'article, Thin MCP n'apparaît pas comme un bouton magique d'accélération, mais comme un moyen de simplifier l'architecture. Dans ce schéma, la couche proxy reste minimale et se contente de traduire les appels, tandis que la logique métier migre vers des services HTTP distincts. Cette approche apporte l'indépendance vis-à-vis du langage, simplifie le passage à l'échelle et permet d'écrire des exécuteurs en Go, en Rust ou en C++, même s'il n'existe pas encore de SDK MCP complet pour eux.
Thin MCP est davantage un outil d'architecture qu'un moyen d'optimiser
la latence.
Un point pratique : l'approche thin peut sembler plus rapide lors d'une exécution sans se reproduire de façon stable lors d'une autre. Pour un système en production, c'est critique : il vaut parfois mieux un comportement prévisible sous charge répétée que le meilleur p95 ponctuel. C'est pourquoi Raft tire une conclusion assez dure mais utile : pour vraiment accélérer un agent IA, il ne suffit pas de changer de langage ou de protocole. Il faut remanier le schéma d'interaction entre le proxy, les composants backend et les étapes de calcul lourdes.
Ce que cela signifie
Pour les équipes qui construisent des agents IA, c'est un bon antidote à l'optimisation superficielle. Si un système est lent, il faut d'abord regarder le nombre de sauts entre composants, les opérations bloquantes, le modèle d'exécution concurrente et les étapes lourdes comme les embeddings et le reranking. Thin MCP peut rendre un système plus propre et plus souple, et C++ ou l'IPC peuvent apporter un gain supplémentaire, mais l'effet décisif n'apparaît que lorsque l'architecture cesse de faire transiter la requête par des couches superflues.
- 1 nov. 2026Les modèles locaux battus par Opus et Codex : 0,21 sur MacBook contre 1,00 pour Codex
- 1 nov. 2026Le juge d'EditAgent (Adobe) retient une retouche valable dans 81,3% des cas, contre 74,8% pour EditScore
- 1 nov. 2026Test de 16 modèles sur 7 moteurs de recherche : Exa obtient en moyenne 10,5 points sur 14, SearXNG environ 3
- 1 nov. 2026L'agent vidéo StreamVibe de Google devance les autres modèles de 10,7 % sur le timing et la qualité des réponses
Questions clés sur cet article
Que sait-on sur D'où vient la latence ?
L'auteur est parti d'une question simple : combien de latence MCP ajoute-t-il à lui seul si l'on supprime le réseau et que l'on garde tout dans un seul processus ? Pour le savoir, il a comparé un monolithe sans MCP à un monolithe avec MCP in-process. Le motif s'avère n'induire qu'un overhead relativement faible : environ 10–11 ms en moyenne, jusqu'à 35 ms par moments. C'est un point de départ important : si un agent rame pendant des centaines de millisecondes, le coupable n'est généralement pas l'usage de MCP en lui-même, mais la couche externe qui l'entoure. La comparaison
Que sait-on sur Ce que les tests ont montré ?
L'article examine plusieurs scénarios pour isoler l'influence du transport, de la sérialisation et du runtime lui-même. S1, MCP in-process : environ 10–11 ms de latence supplémentaire, ce qui signifie que le runtime est relativement léger. S2, MCP séparés via le réseau Docker : en moyenne environ 169 ms d'overhead par appel, à cause du réseau, de la sérialisation et de la communication inter-processus. S3a, Thin MCP via HTTP + JSON : sur une série de mesures, l'overhead est tombé à environ 128 ms, mais le résultat s'est révélé instable et, lors d'exécutions répétées, pouvai
Pourquoi thin ne sauve pas la mise?
Dans l'article, Thin MCP n'apparaît pas comme un bouton magique d'accélération, mais comme un moyen de simplifier l'architecture. Dans ce schéma, la couche proxy reste minimale et se contente de traduire les appels, tandis que la logique métier migre vers des services HTTP distincts. Cette approche apporte l'indépendance vis-à-vis du langage, simplifie le passage à l'échelle et permet d'écrire des exécuteurs en Go, en Rust ou en C++, même s'il n'existe pas encore de SDK MCP complet pour eux. Thin MCP est davantage un outil d'architecture qu'un moyen d'optimiser la latence.
Build & Ship Production AI Agents Without Boilerplate Code
Start your free 72-hour trial at Hamidun Academy (academy.hamidun.com) — interactive lessons on Claude Code & Cursor, live Tech Radar, and production agent templates.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.