Turnitin et OpenAI perdent la partie : pourquoi les détecteurs d'IA ne distinguent plus les humains des modèles
Les détecteurs d'IA perdent rapidement leur raison d'être : les modèles de langage actuels imitent déjà trop bien l'écriture humaine. Les études montrent une précision proche du hasard, et la paraphrase efface encore davantage les traces de génération. En pratique, ce sont les étudiants, les auteurs et les rédactions qui en paient le prix : certains textes passent sans encombre, d'autres valent à leurs auteurs de fausses accusations. Et le marché ne dispose toujours d'aucun arbitre automatique fiable.
Traité par IA depuis Habr AI ; édité par Hamidun News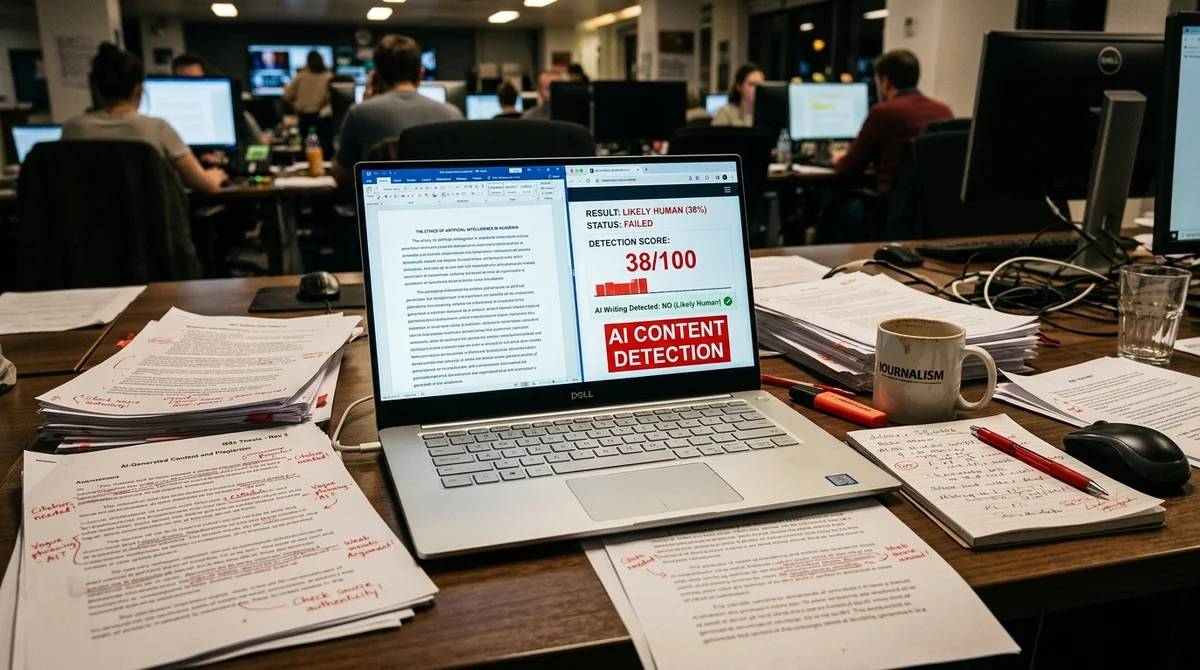
Les modèles de langage ont atteint un point où il devient de plus en plus difficile de savoir, à partir d'un seul texte, s'il a été écrit par un humain ou par une machine. Les détecteurs d'IA se réduisent donc à un filtre peu efficace : ils laissent passer les contenus synthétiques et se trompent de plus en plus souvent sur des auteurs bien réels.
Pourquoi les modèles se ressemblent
Il y a peu encore, on pensait pouvoir reconnaître un texte machine à sa fluidité aseptisée, à ses tournures répétitives et à sa structure trop parfaite. Mais les LLM actuels ont largement dépassé le stade rudimentaire du « devine le mot suivant ». Au-dessus de la prédiction linguistique de base se sont ajoutés des mécanismes qui permettent de conserver le sens, de copier une intonation et d'adapter la réponse à un public précis. Le modèle n'apprend pas seulement à s'exprimer de façon cohérente : il apprend aussi à ressembler à quelqu'un qui rédige un mémoire, débat dans un chat ou explique un sujet à un collègue.
Plusieurs couches y contribuent simultanément. Le transfert de style permet de reproduire une manière d'écrire individuelle, le fine-tuning affine l'expression à partir d'exemples réels, l'inférence exploite le contexte de la conversation, et le RLHF ajuste les réponses aux attentes humaines en matière de logique, de politesse et de naturel. Résultat : l'ancien écart entre texte « machine » et texte « humain » disparaît. Le modèle peut se montrer sec et académique, familier et irrégulier, voire volontairement un peu rugueux si ce style passe mieux pour de l'écriture humaine.
Où les détecteurs échouent
Dans ce contexte, les détecteurs eux-mêmes perdent pied. Une étude de 2025, citée par l'auteur de l'article, aboutit à un quasi-match nul : humains comme algorithmes identifiaient les textes générés par IA avec une précision d'environ 57%. Ce n'est plus un outil de contrôle, c'est presque un tirage à pile ou face. Autre problème : on peut faire passer le texte par une étape de paraphrase, ce qui efface encore davantage les traces statistiques de la génération. Plus les modèles savent se réécrire eux-mêmes, moins les systèmes qui traquent les anciennes signatures fonctionnent.
« GPT ou pas GPT ? » : trop souvent, la vérification se résume
aujourd'hui à cela.
- Dans les études, la précision de détection se révèle de plus en plus proche du hasard.
- Une paraphrase répétée supprime le caractère stéréotypé, la prévisibilité et les autres marqueurs visibles de génération.
- Les faux positifs pénalisent davantage les auteurs réels que ceux qui utilisent massivement l'IA.
- OpenAI a fermé son AI Classifier après des résultats médiocres : l'outil ne repérait qu'environ 26% des textes générés.
L'effet le plus douloureux, ce sont les erreurs au détriment des humains. En 2023, aux États-Unis, une affaire retentissante impliquant Turnitin a touché une lycéenne dont le système avait classé la dissertation presque entièrement comme travail d'IA. Une vérification indépendante a montré par la suite que le détecteur lui-même était loin d'être infaillible et ne reconnaissait qu'une partie des textes générés par machine. Cette asymétrie est dangereuse : un texte généré peut passer inaperçu, tandis qu'un auteur de bonne foi peut voir sa réputation entachée. Lorsqu'il s'agit d'un diplôme, d'une publication scientifique ou d'une évaluation, le coût d'une seule erreur devient bien trop élevé.
Ce qu'il faut changer dès maintenant
Pour l'enseignement et la recherche, la conclusion principale est simple : il faut vérifier non seulement le texte final, mais l'ensemble du processus qui l'a produit. Plus un système récompense le volume, la structure formelle et le remplissage administratif, plus il est facile de le tromper avec un LLM. Mieux vaut donc mettre l'accent sur la soutenance orale, les brouillons, l'historique des modifications, la qualité des sources, la reproductibilité des conclusions et la capacité de l'auteur à expliquer son argumentation sans antisèche. Là où il faut démontrer une compréhension du sujet, et pas seulement produire beaucoup de texte lisse, le modèle dispose de moins de marge pour une substitution discrète.
Hors du monde académique, le problème n'est pas moins concret. Des détecteurs peu fiables n'arrêtent pas la désinformation et sont presque inutiles face à l'ingénierie sociale, où comptent la vitesse, l'échelle et un ton convaincant. Dans les rédactions, les entreprises et les échanges courants, il ne faut donc pas un « scanner d'IA magique », mais une vérification sérieuse : recoupement des faits auprès de plusieurs sources, confirmation de l'identité par un second canal, vigilance face aux messages trop rapides et trop léchés. Un texte lisse peut être un signal, mais pas une preuve, et c'est précisément ce qui replace la vérification humaine au centre.
Ce que cela signifie
On ne peut plus considérer un détecteur d'IA comme un juge qui rend un verdict définitif sur un texte. Au mieux, c'est un indicateur d'appoint. La confiance se déplace désormais de la surface du texte vers sa provenance, son processus de création et la capacité de l'auteur à prouver qu'il comprend réellement ce qu'il a écrit.
- 1 nov. 2026Les modèles locaux battus par Opus et Codex : 0,21 sur MacBook contre 1,00 pour Codex
- 1 nov. 2026Kimi obtient 96,2 % à un test d'analytique sur une base 1C et s'impose comme solution de repli en cas de blocage de Claude
- 1 nov. 2026OpenAI réécrit les règles de comportement de GPT : cinq valeurs et une chaîne de priorités
- 1 nov. 2026Google reconnaît que l'AI Mode réduit les revenus de la recherche, l'action chute de 15%
Questions clés sur cet article
Pourquoi les modèles se ressemblent?
Il y a peu encore, on pensait pouvoir reconnaître un texte machine à sa fluidité aseptisée, à ses tournures répétitives et à sa structure trop parfaite. Mais les LLM actuels ont largement dépassé le stade rudimentaire du « devine le mot suivant ». Au-dessus de la prédiction linguistique de base se sont ajoutés des mécanismes qui permettent de conserver le sens, de copier une intonation et d'adapter la réponse à un public précis. Le modèle n'apprend pas seulement à s'exprimer de façon cohérente : il apprend aussi à ressembler à quelqu'un qui rédige un mémoire, débat dans un
Que sait-on sur Où les détecteurs échouent ?
Dans ce contexte, les détecteurs eux-mêmes perdent pied. Une étude de 2025, citée par l'auteur de l'article, aboutit à un quasi-match nul : humains comme algorithmes identifiaient les textes générés par IA avec une précision d'environ 57%. Ce n'est plus un outil de contrôle, c'est presque un tirage à pile ou face. Autre problème : on peut faire passer le texte par une étape de paraphrase, ce qui efface encore davantage les traces statistiques de la génération. Plus les modèles savent se réécrire eux-mêmes, moins les systèmes qui traquent les anciennes signatures fonctionnen
Que sait-on sur Ce qu'il faut changer dès maintenant ?
Pour l'enseignement et la recherche, la conclusion principale est simple : il faut vérifier non seulement le texte final, mais l'ensemble du processus qui l'a produit. Plus un système récompense le volume, la structure formelle et le remplissage administratif, plus il est facile de le tromper avec un LLM. Mieux vaut donc mettre l'accent sur la soutenance orale, les brouillons, l'historique des modifications, la qualité des sources, la reproductibilité des conclusions et la capacité de l'auteur à expliquer son argumentation sans antisèche. Là où il faut démontrer une compréh
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.