Micro1 recrute dans le monde entier pour entraîner des humanoïdes, tandis que l'IA réclame de nouveaux tests
Alors que le marché des humanoïdes s'emballe, Micro1, Scale AI et DoorDash paient déjà des particuliers pour filmer des tâches domestiques ordinaires, du repassage à la vaisselle. Les robots ont besoin de ces vidéos pour apprendre dans le monde réel. Mais ce nouveau marché de la donnée soulève aussi des questions de vie privée, de consentement et de qualité des tests d'IA eux-mêmes : les scores élevés aux benchmarks coïncident de moins en moins avec une utilité réelle dans les processus métier.
Traité par IA depuis MIT Technology Review ; édité par Hamidun News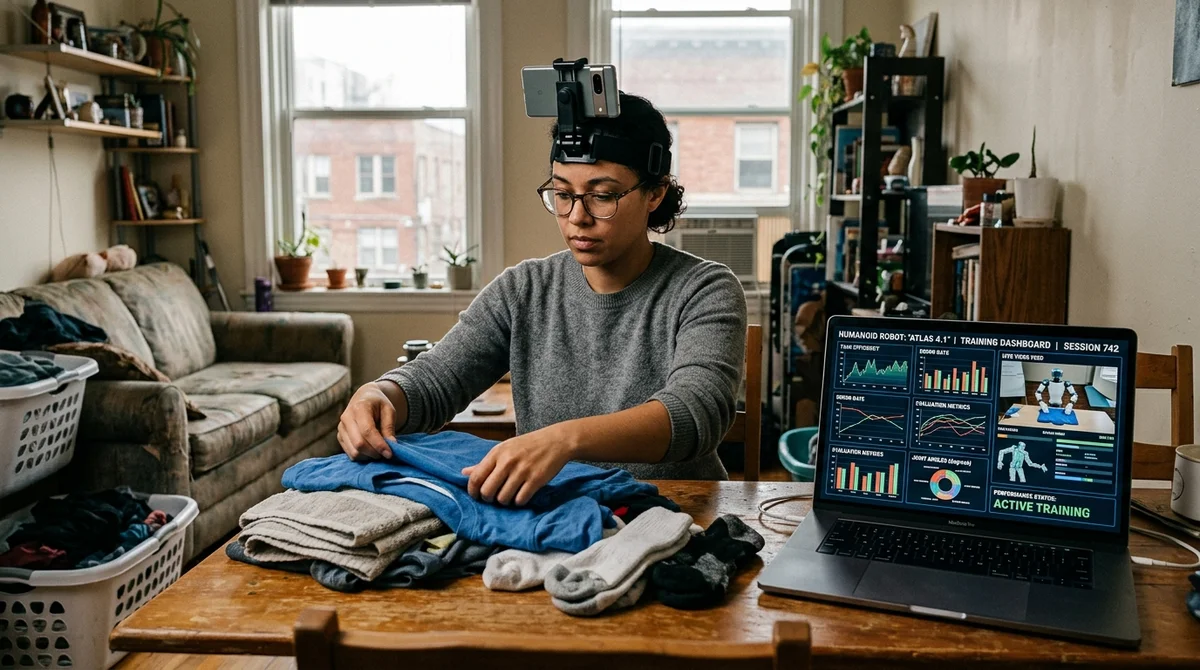
Le marché de l'embodied AI ne bute plus seulement sur le matériel, mais aussi sur les données humaines : partout dans le monde, des milliers de personnes se filment en train de faire la lessive, de repasser et de ranger chez elles pour entraîner des humanoïdes. Dans le même temps, des chercheurs affirment de plus en plus fort que les tests d'IA habituels ne disent presque rien du comportement de ces systèmes en situation de travail réelle.
Comment on entraîne les humanoïdes
Micro1 est l'une des entreprises les plus visibles de cette nouvelle couche du marché. Elle recrute des contractuels dans plus de 50 pays, dont le Nigeria, l'Inde et l'Argentine, pour enregistrer des gestes du quotidien en vue subjective : plier des vêtements, faire la vaisselle, essuyer une table, verser de l'eau, ouvrir le réfrigérateur. Les participants fixent un iPhone sur leur tête et tournent de courtes vidéos où leurs mains restent dans le champ.
Les vidéos sont ensuite vérifiées, annotées, puis intégrées à des datasets achetés par des entreprises de robotique. La logique est simple : Internet a suffi aux grands modèles de langage, mais les robots humanoïdes ont besoin du monde physique réel. Les simulations aident à travailler les mouvements, mais rendent mal le chaos d'un appartement ordinaire : éclairages variables, cuisines exiguës, surfaces glissantes, des dizaines de types d'objets et de manières de les manipuler.
D'où l'arrivée sur ce marché non seulement de Micro1 et de Scale AI, qui a réuni plus de 100 000 heures de ce type de contenus, mais aussi de nouveaux canaux comme DoorDash Tasks. Le 19 mars 2026, DoorDash a officiellement lancé un pilote qui rémunère des prestataires pour filmer des tâches domestiques et réaliser des enregistrements vocaux destinés à l'IA et à la robotique. Même des centaines de milliers d'heures de vidéo ne semblent pas encore couvrir les besoins du marché.
«
Cela prendra plus de temps que beaucoup ne le pensent », — Ken Goldberg, roboticien.
Le prix de ces données
Pour de nombreux prestataires, c'est un complément de revenu correct : un tarif d'environ 15 dollars de l'heure paraît compétitif dans plusieurs pays. Mais le travail devient vite monotone. Les participants doivent filmer encore et encore des gestes similaires, inventer de nouveaux scénarios dans un petit appartement et veiller à ce que chaque enregistrement respecte les consignes.
Un travailleur de Delhi racontait qu'une vidéo exploitable de quinze minutes pouvait lui demander près d'une heure, simplement parce qu'il n'y a pas tant de tâches différentes à filmer chez soi. l'iPhone ou un autre smartphone compatible est fixé à hauteur de tête les vidéos sont tournées en vue subjective, généralement par séquences de 1–2 minutes les mains et l'objet doivent rester dans le champ presque en permanence il faut varier l'éclairage, les pièces, les surfaces et les objets * on évite autant que possible de montrer visages, noms et autres données personnelles Le principal enjeu n'est d'ailleurs pas la routine, mais la vie privée. Même si le visage n'apparaît pas, la vidéo révèle l'intérieur du logement, les médicaments dans la cuisine, les affaires des enfants, l'emploi du temps et les voisins capturés par hasard en arrière-plan.
Or les prestataires ignorent souvent à qui leurs enregistrements sont revendus, combien de temps ils sont conservés et s'il est possible d'en obtenir la suppression. La chercheuse Yasmine Kotturi le dit sans détour : les entreprises doivent expliquer en amont aux participants où cette technologie peut mener et quelles conséquences elle aura pour eux à l'avenir.
Pourquoi les tests ne tiennent plus
En parallèle de la course aux données, un autre débat s'intensifie : comment mesurer la qualité de l'IA. La chercheuse Angelina Aristidou estime que le secteur a trop longtemps fonctionné selon la logique de l'examen scolaire, où l'on compare le modèle à un humain sur une tâche isolée avec une bonne ou une mauvaise réponse. Dans la réalité, ce cas de figure est rare.
L'IA s'intègre dans des équipes, des procédures et des processus longs, où comptent non seulement la précision et la vitesse, mais aussi l'effet du système sur la coordination entre les personnes, la charge de travail, la confiance et le nombre d'erreurs aux étapes suivantes. Aristidou propose à la place l'approche HAIC — Human–AI, Context-Specific Evaluation. L'idée : évaluer non pas le modèle dans le vide, mais le fonctionnement du système au sein d'une organisation et sur le long terme.
Dans ses exemples, des IA médicales pouvaient briller aux tests, mais ralentissaient le travail à l'hôpital, car les médecins devaient adapter leurs conclusions aux normes locales de reporting et aux exigences des régulateurs. Cette approche déplace le curseur sur plusieurs axes à la fois : de la tâche individuelle vers le travail d'équipe et le workflow du test ponctuel vers l'effet sur la durée de la précision brute vers la qualité de la coordination et la détection des erreurs de la réponse isolée vers les conséquences en amont et en aval de son utilisation Pour les entreprises, l'idée est inconfortable mais utile. Un score élevé sur un benchmark ne garantit pas encore qu'un outil accélérera un hôpital, un entrepôt, un service client ou une organisation humanitaire.
Dans l'un des cas cités par Aristidou, le système a été évalué pendant 18 mois au sein de processus réels, avec un suivi spécifique de la facilité avec laquelle les humains repèrent et corrigent ses erreurs. Seule une telle évaluation a permis de déterminer quels garde-fous étaient réellement nécessaires avant un déploiement à grande échelle.
Ce que cela signifie L'histoire des entraîneurs domestiques de robots
et le débat sur les nouveaux benchmarks convergent vers une même conclusion : l'industrie de l'IA repose de moins en moins sur de belles démos et de plus en plus sur la qualité d'une infrastructure invisible. Les gagnants ne seront pas seulement ceux qui ont le robot le plus spectaculaire ou le meilleur score aux tests, mais ceux qui sauront collecter des données réelles de manière éthique, expliquer clairement leurs règles d'utilisation et prouver l'utilité du système au sein de processus réels, et pas seulement sur scène.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.