Playwright et MCP : comment un agent IA vérifie l'interface et la base de données sans assertions SQL manuelles
Un toast vert après le checkout ne prouve pas que la commande a vraiment été créée. Un nouveau schéma de vérification full-stack propose de confier à un agent IA les deux volets du scénario : parcourir l'interface avec Playwright, puis vérifier via un second serveur MCP l'enregistrement en base, les lignes de commande et la décrémentation des stocks. Cela réduit le volume de code de test et supprime les vérifications SQL manuelles des tests end-to-end.
Traité par IA depuis Habr AI ; édité par Hamidun News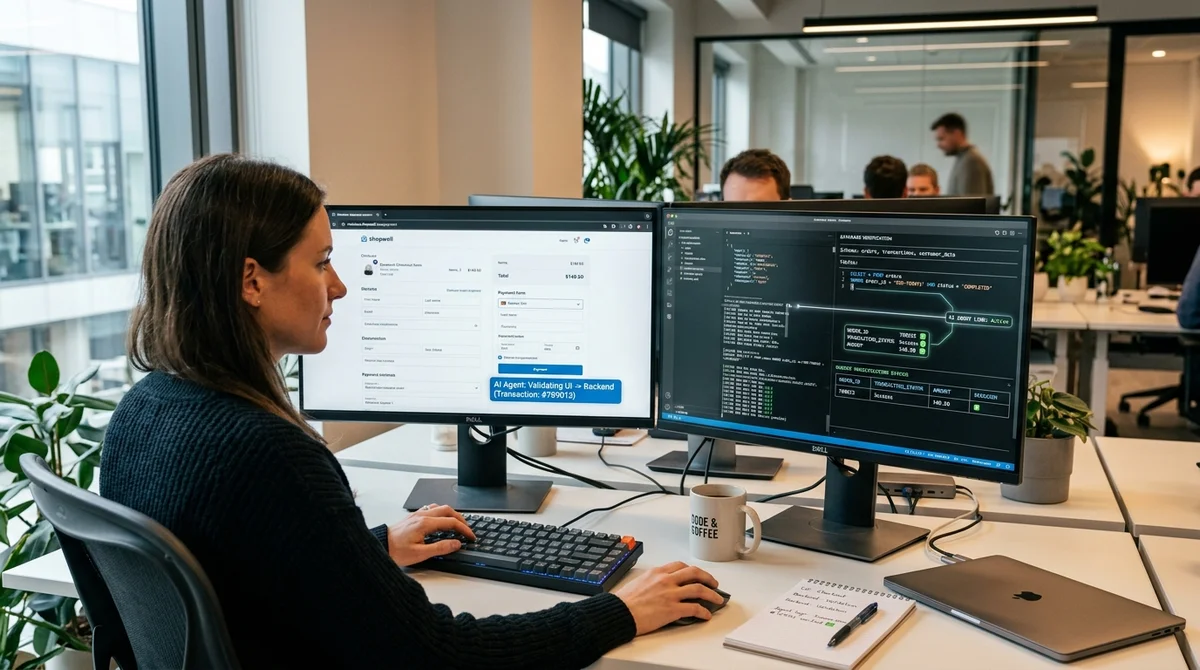
Un simple toast vert après un clic sur « Passer la commande » ne signifie pas que la commande a réellement été créée. Si la transaction a été annulée, qu'une file d'attente a perdu le message et que l'interface a quand même affiché « succès », le test end-to-end donne une fausse impression de fiabilité. C'est pourquoi de plus en plus d'équipes se tournent vers la vérification full-stack, qui contrôle non seulement l'interface, mais aussi l'état réel des données en base.
Dans l'approche classique, l'infrastructure de test a besoin d'un accès direct à la base via un ORM ou un pilote bas niveau. Les frais généraux commencent alors : identifiants dédiés, configuration des connexions, assertions SQL manuelles, maintenance des requêtes à chaque changement de schéma. Sur le papier, cela règle le problème, mais le coût grimpe avec le nombre de scénarios. Chaque nouveau test end-to-end ne vérifie plus seulement le comportement de l'utilisateur : il devient un mini-projet de maintenance de code de test.
L'article décrit un schéma plus léger : un seul agent IA travaille successivement avec deux serveurs MCP. D'abord, il exécute via Playwright le scénario dans le navigateur comme un utilisateur ordinaire : il remplit le panier, passe le checkout, clique sur le bouton de confirmation et relève les indices clés du résultat. Ensuite, le même agent bascule vers un serveur capable de lire la structure de la base et de répondre à des requêtes de vérification sans que le testeur écrive du SQL à la main.
En pratique, l'agent n'a qu'à formuler ce qu'il faut confirmer : l'enregistrement de la commande existe-t-il, les lignes correspondent-elles, le stock du produit a-t-il été décrémenté, le statut du paiement a-t-il changé. Cette approche comble le principal écart entre « l'interface a affiché un succès » et « l'opération métier s'est réellement terminée ». L'agent peut rapprocher les données de l'interface des enregistrements des tables, vérifier les effets de bord et même tenir compte de l'asynchronisme si le système n'écrit pas instantanément en base.
Pour les équipes produit, c'est particulièrement important dans les scénarios où un seul bouton côté utilisateur déclenche une chaîne d'actions : création de la commande, réservation du stock, écriture dans le système logistique, mise à jour du statut du client. C'est là que naissent le plus souvent les bugs coûteux qu'un test d'interface ordinaire ne détecte pas.
L'intérêt pratique de ce schéma est d'abaisser le seuil d'entrée du test full-stack. L'équipe n'a pas besoin d'embarquer un ORM dans les tests pour quelques vérifications ni de dupliquer la connaissance du schéma de la base dans le code des assertions. À la place apparaît une couche de vérification unique, formulée en intentions : « après la commande, un enregistrement doit apparaître », « le nombre de lignes doit correspondre », « le stock en entrepôt doit diminuer d'une unité ».
Si le schéma change, la maintenance se rapproche du serveur MCP ou de la description de l'accès aux données, au lieu de se diluer dans des dizaines de tests. Les tests deviennent plus courts, plus lisibles et plus proches du langage métier.
Ce scénario ne dispense pas pour autant de la discipline d'ingénierie de base. On ne peut pas se reposer uniquement sur l'agent IA : les tests unitaires et d'intégration restent nécessaires pour localiser rapidement les erreurs au niveau des fonctions, des services et des contrats. L'accès de l'agent à la base doit être restreint, idéalement en lecture seule et uniquement en environnement de test. Il faut aussi des garde-fous de prévisibilité : données de test stables, règles de sélection claires, protection contre le risque que l'agent vérifie par erreur la mauvaise commande dans une base partagée. Sinon, un outil pratique deviendra vite une source d'échecs bruyants et difficiles à reproduire.
La conclusion principale est simple : la prochaine étape du test end-to-end consiste à passer de la vérification des écrans à celle des conséquences réelles de l'action de l'utilisateur. L'association de Playwright et de MCP rend ce passage nettement moins coûteux, car elle retire le SQL manuel du quotidien du testeur et permet à une seule automatisation d'aller du clic sur le bouton jusqu'à la preuve de l'enregistrement en base. Pour les équipes qui testent des paiements, des commandes, des réservations et d'autres transactions critiques, ce n'est pas seulement une technique pratique, mais un moyen de réduire le nombre de faux positifs et de détecter plus tôt des bugs qui passaient auparavant en production.
- 2 nov. 2026Karpathy bâtit en deux heures un clone de YouTube avec 6454 vidéos issues des conseils de Hacker News
- 2 nov. 2026Avec Claude, Andrej Karpathy a assemblé HackerTube : 6454 vidéos recommandées sur Hacker News
- 2 nov. 2026Arca confie à des agents IA des tâches financières pouvant durer jusqu'à 10 jours, mais laisse les transactions aux humains
- 2 nov. 2026DeepSeek ouvre le code d'un prototype de Super-agent : p95 du temps d'exécution de 15,7 min contre 29,5
Build & Ship Production AI Agents Without Boilerplate Code
Start your free 72-hour trial at Hamidun Academy (academy.hamidun.com) — interactive lessons on Claude Code & Cursor, live Tech Radar, and production agent templates.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.