OpenAI, Anthropic et Gemini : comment la mise en cache de l'inférence réduit le coût et la latence des LLM
La mise en cache de l'inférence devient une optimisation de base pour les services LLM : elle réduit la latence, évite les calculs redondants et fait nettement baisser la facture de tokens. La règle pratique centrale du nouveau guide : commencer par le prefix caching pour les prompts système longs et stables, et ne recourir au semantic caching que là où les utilisateurs posent en masse des questions similaires, formulées différemment.
Traité par IA depuis Machine Learning Mastery ; édité par Hamidun News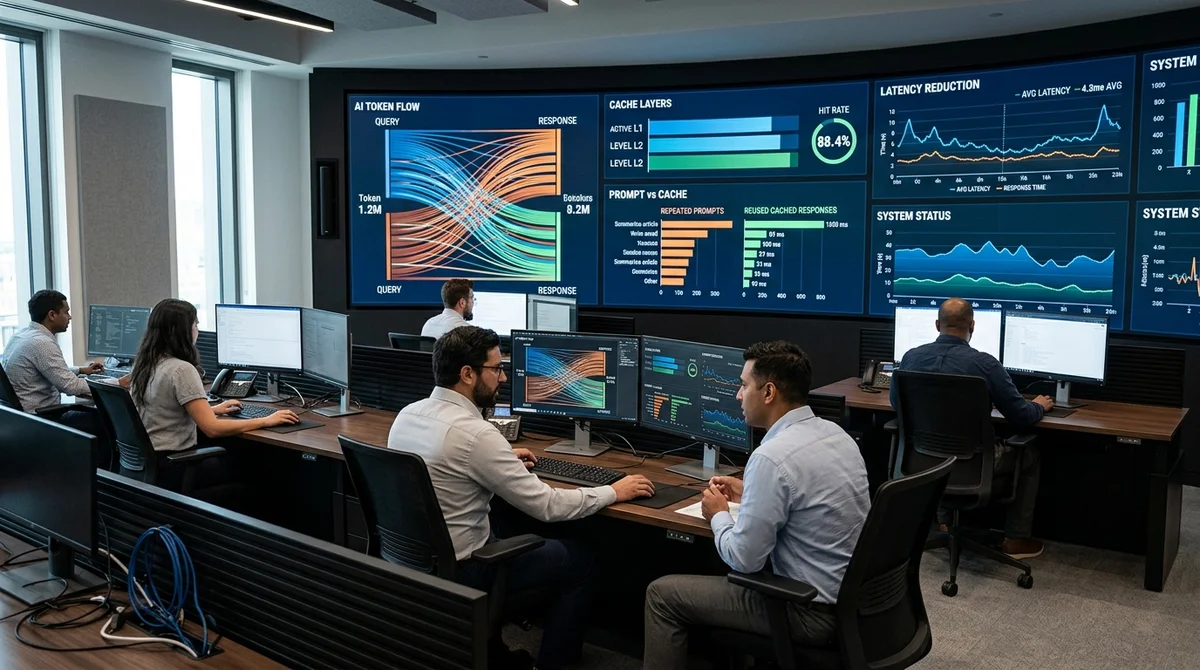
La mise en cache de l'inférence s'impose rapidement comme l'une des techniques les plus pragmatiques pour exploiter les grands modèles de langage : elle réduit le coût des requêtes, diminue la latence et évite de recalculer sans cesse les mêmes portions de prompt. Pour les services en production dotés de longues instructions système et de requêtes répétitives, il ne s'agit plus d'une optimisation fine, mais d'un outil d'économie de base. Le principe est simple : un LLM consacre une part notable de ses ressources non pas à « produire une réponse intelligente », mais à retraiter un contexte qu'il connaît déjà.
Si une application réutilise le même system prompt, des documents communs, des exemples few-shot ou des questions types, le modèle sans cache refait tout ce chemin à chaque appel. L'inference caching conserve le résultat de ces calculs et le réutilise lorsque la requête suivante est identique, ou au moins suffisamment proche sur le plan sémantique. Résultat : le système consomme moins de tokens, répond plus vite à l'utilisateur et encaisse plus facilement une montée en charge.
Au niveau le plus bas, on trouve le KV-caching. Pendant la génération, le modèle stocke token par token les états internes de l'attention — les paires key et value — pour ne pas avoir à les recalculer à chaque nouvelle étape de décodage. Ce mécanisme fonctionne automatiquement dans quasiment tous les moteurs d'inférence modernes et accélère une requête donnée.
L'utilisateur n'a généralement rien à activer manuellement, mais un point compte : c'est sur ce mécanisme que reposent les optimisations de plus haut niveau, aux effets plus visibles. Autrement dit, le KV-cache constitue la fondation qui élimine le travail superflu au sein d'un même appel au modèle. La couche suivante est le prefix caching, que les fournisseurs appellent aussi prompt caching ou context caching.
L'idée est simple : si plusieurs requêtes partagent le même début — une longue instruction système, un bloc de règles, un document de référence ou un jeu d'exemples —, on peut le traiter une seule fois et le réutiliser lors des appels suivants. Mais une condition stricte s'applique : le préfixe doit correspondre octet par octet. Une espace en trop, un signe de ponctuation modifié, une nouvelle date en tête de prompt ou un ordre instable des clés JSON suffisent à faire échouer le cache hit.
Mieux vaut donc placer le contenu statique au début et reléguer toutes les variables — message de l'utilisateur, session ID, date du jour — à la fin. C'est pourquoi cette technique fait déjà partie des API des grands acteurs : Anthropic donne aux développeurs un contrôle explicite sur les blocs mis en cache, OpenAI applique automatiquement le prefix caching aux prompts longs, et Google Gemini propose un mécanisme dédié de stockage du contexte. En environnement self-hosted, vLLM et SGLang prennent en charge une logique similaire.
Troisième couche : le semantic caching. Ici, le système ne stocke plus les états intermédiaires du modèle, mais des paires « requête-réponse », et recherche des correspondances sémantiques via des embeddings et une base vectorielle. Si un utilisateur pose presque la même question qu'auparavant, l'application peut renvoyer une réponse toute prête sans appeler le LLM du tout.
Cette approche s'avère particulièrement utile pour les FAQ, les bots de support et les services grand public, où les gens formulent les mêmes questions avec des mots différents. Mais l'économie a un prix en infrastructure supplémentaire : il faut des embeddings, une recherche vectorielle, un TTL et un réglage soigneux du seuil de similarité, faute de quoi le risque de réponses obsolètes ou hors sujet augmente. Le semantic caching ne se justifie donc pas partout, mais avant tout là où le flux de requêtes similaires est important et où les chances de réutiliser une réponse déjà générée sont élevées.
Qu'est-ce que cela signifie en pratique ? Le KV-caching fonctionne déjà de lui-même, le prefix caching offre généralement le gain le plus rapide et le plus sûr en production, et le semantic caching ne mérite d'être ajouté que là où la répétitivité des questions couvre réellement le coût de l'infrastructure supplémentaire. Pour la plupart des équipes, la démarche optimale consiste d'abord à stabiliser la structure des prompts, à placer tout le contexte commun au début et à obtenir un taux de cache hit élevé sur le préfixe, avant de décider si un cache sémantique est nécessaire.
Pour les applications LLM, c'est un cas rare où une seule discipline d'architecture permet à la fois de réduire les coûts, d'accélérer le produit et de ne quasiment rien changer à l'expérience utilisateur.
- 1 nov. 2026OpenAI réécrit les règles de comportement de GPT : cinq valeurs et une chaîne de priorités
- 1 nov. 2026Google reconnaît que l'AI Mode réduit les revenus de la recherche, l'action chute de 15%
- 31 oct. 2026Un auteur soumet son scénario à un jury d'IA : le verdict coûte 850 000 tokens
- 31 oct. 2026Anthropic : replier les sous-agents dans une seule boucle a doublé la vitesse des tâches chez un client
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.