Scikit-LLM montre comment intégrer le résumé de texte dans un pipeline de ML scikit-learn
Scikit-LLM a montré comment intégrer le résumé automatique directement dans un pipeline scikit-learn classique. Dans l'exemple, de longs avis sont d'abord compressés par le modèle gratuit DistilBART de Hugging Face, puis traversent TF-IDF et LogisticRegression. L'approche réduit le volume de texte, simplifie la préparation des caractéristiques et garde tout le processus, du texte brut à la classification, dans un seul pipeline reproductible.
Traité par IA depuis Machine Learning Mastery ; édité par Hamidun News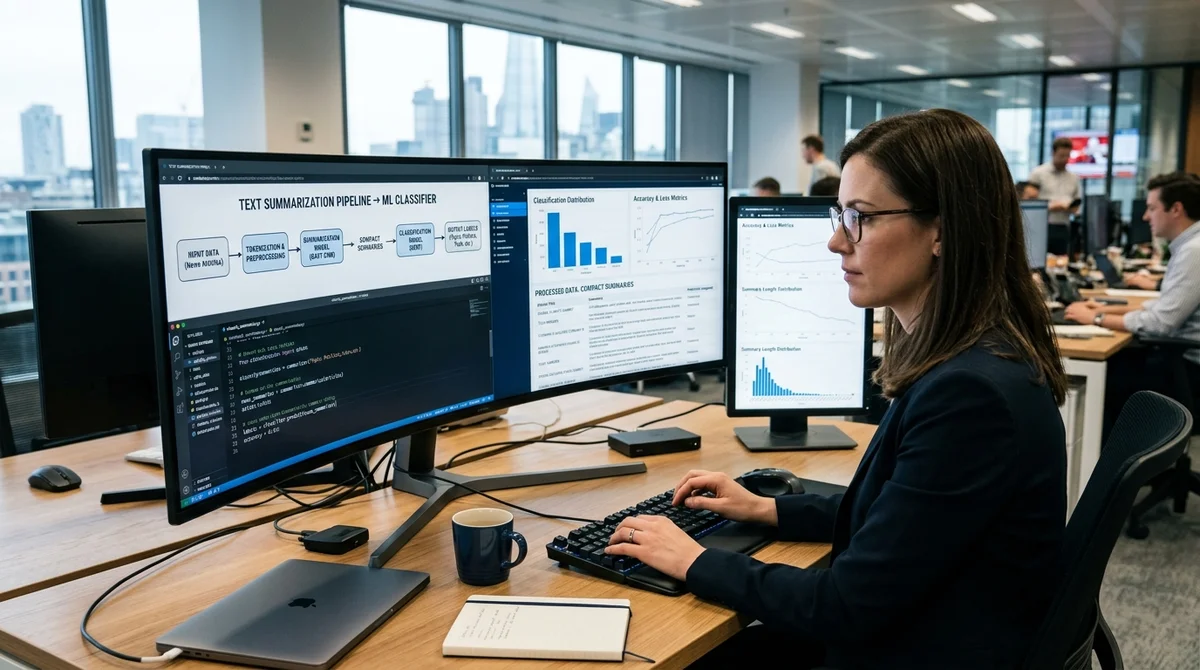
Scikit-LLM a présenté une méthode pratique pour intégrer le résumé de texte directement dans un pipeline de ML classique sous scikit-learn. L'idée est simple : un LLM condense d'abord les longs documents en résumés courts, qui sont ensuite convertis en caractéristiques numériques et envoyés à un classifieur. On peut ainsi traiter de gros textes sans étape manuelle de prétraitement distincte, et tout le pipeline forme un ensemble unique, du texte brut à la prédiction finale.
Dans son analyse, l'auteur utilise Scikit-LLM comme trait d'union entre les outils traditionnels d'apprentissage automatique et les modèles de langage modernes. Par défaut, la bibliothèque s'appuie sur les modèles d'OpenAI, mais l'exemple retient une option gratuite via Hugging Face : le modèle sshleifer/distilbart-cnn-12-6. Il faut en outre installer la bibliothèque transformers en version 4.37.2. Ce choix compte : le résumé peut être appelé très souvent, et le coût d'inférence devient vite sensible s'il passe par des API commerciales.
L'élément central de l'exemple est une classe maison, HuggingFaceSummarizer, compatible avec scikit-learn. Elle hérite de BaseEstimator et de TransformerMixin, ce qui permet de l'insérer dans un Pipeline ordinaire comme n'importe quel autre transformateur. Dans la méthode fit, la classe charge un modèle pré-entraîné en mémoire ; dans transform, elle reçoit une liste de textes, lance le pipeline de résumé et renvoie les résumés courts déjà prêts. Le matériel est aussi pris en compte : si un GPU est disponible, le modèle s'y exécute, sinon il utilise le CPU.
Ce résumé devient ensuite la première étape du pipeline de ML. Vient ensuite TfidfVectorizer, qui transforme les textes raccourcis en caractéristiques numériques, puis LogisticRegression est entraîné sur ces représentations. La démonstration n'utilise que deux exemples : un avis positif sur un aspirateur et un avis négatif sur un sac à dos, évoquant une livraison retardée et une fermeture éclair défectueuse. Pour un vrai modèle, c'est évidemment insuffisant, mais l'enjeu est ailleurs : montrer qu'un long texte non structuré peut être condensé automatiquement et injecté directement dans un schéma de classification standard.
Autre atout : tout le processus se lance par un simple appel à fit. À cette étape, le pipeline télécharge le modèle, résume les textes longs, vectorise les versions raccourcies, puis entraîne le classifieur. L'auteur montre aussi les résumés intermédiaires : l'avis positif conserve l'idée que l'appareil est globalement bon, bien qu'un peu lourd et pas immédiatement clair à régler ; l'avis négatif garde les plaintes sur le retard de livraison, la fermeture éclair qui coince et le tissu bon marché. Même un modèle compact sait extraire le signal principal, exploitable ensuite dans un ML ordinaire.
Sans surprise, le résultat de cette approche minimaliste est un compromis. L'auteur note sans détour que la qualité des résumés reste nettement inférieure à ce que l'on obtient avec ChatGPT ou Google Gemini. Le modèle DistilBART, léger et gratuit, dégage les idées principales, mais de façon plus grossière et moins soignée. L'exemple illustre en revanche bien l'architecture : le résumé n'est plus un outil externe, mais une partie intégrée du processus d'entraînement. C'est particulièrement utile quand les documents sont nombreux et longs, et que le modèle en aval est sensible à la dimensionnalité et au bruit du texte.
L'intérêt pratique de ce schéma est qu'il donne au développeur un pipeline unique et reproductible pour préparer les textes et entraîner le modèle. Au lieu de plusieurs scripts épars, un seul flux que l'on peut entraîner, tester et déployer en production selon les règles standard de scikit-learn. Si l'on remplace le modèle léger par un modèle plus puissant, la qualité du résumé augmentera, et celle de la classification peut suivre.
Scikit-LLM joue ici le rôle de passerelle entre la pile habituelle d'apprentissage automatique et les approches LLM, une passerelle adoptable sans refonte de l'infrastructure. Elle intéresse surtout les équipes déjà installées dans l'écosystème scikit-learn qui veulent ajouter des fonctions LLM de façon ciblée, sans réécrire entièrement leurs pipelines, leur infrastructure d'entraînement ni leurs procédures de validation.
- 2 nov. 2026L'assistant Muse de Meta tient un dossier sur vos proches et obtient root par défaut sous Ubuntu
- 1 nov. 2026Les modèles locaux battus par Opus et Codex : 0,21 sur MacBook contre 1,00 pour Codex
- 1 nov. 2026Kimi obtient 96,2 % à un test d'analytique sur une base 1C et s'impose comme solution de repli en cas de blocage de Claude
- 1 nov. 2026OpenAI réécrit les règles de comportement de GPT : cinq valeurs et une chaîne de priorités
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.