La pyramide des tests, un outil pour découper les tâches des agents IA dans QA Assist
QA Assist, un système de 11 agents IA, s'est heurté à un problème classique : à cause de sa fenêtre de contexte, un modèle de langage ne peut pas couvrir tout un projet en une seule requête. La solution : la pyramide des tests. D'abord les tests unitaires, puis les tests d'intégration, enfin les tests E2E. Chaque couche tient dans le contexte et est générée de manière isolée. Mikhaïl Fedorov explique comment faire avaler l'éléphant au réseau de neurones bouchée par bouchée, et pourquoi la théorie classique du QA est plus pertinente que jamais.
Traité par IA depuis Habr AI ; édité par Hamidun News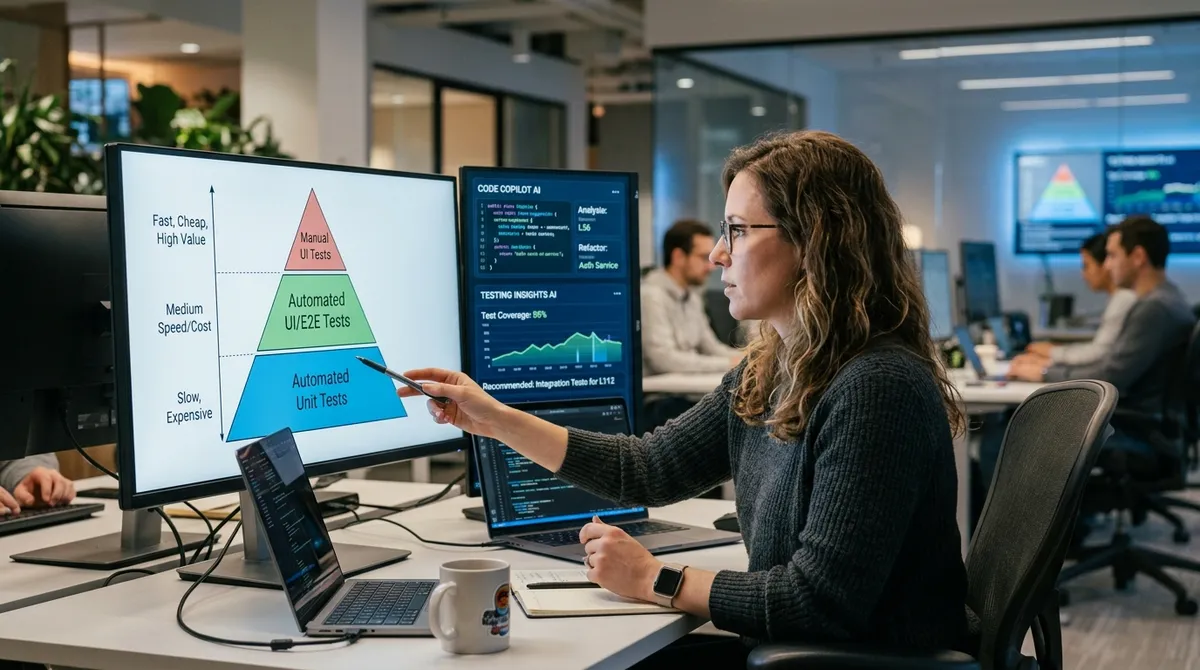
Quand un modèle de langage devient concepteur de tests, la théorie classique du QA prend soudain une nouvelle dimension. C'est le sujet du troisième article de Mikhaïl Fedorov dans sa série consacrée au système QA Assist, publiée sur Habr. Cette fois, l'auteur explique pourquoi la pyramide des tests, imaginée bien avant l'ère des réseaux de neurones, s'avère cruciale pour des agents IA dont la fenêtre de contexte est limitée.
QA Assist est un système de 11 agents IA spécialisés dans l'automatisation des tests logiciels. Dans le premier article de la série, Fedorov en décrivait l'architecture : la répartition des responsabilités entre agents, leurs interactions et leurs capacités. Dans le deuxième, il montrait sans fard la réalité du déploiement : une tâche qui, sur le papier, représente quatre heures de travail se transforme en entreprise en une semaine de validations, de réunions avec les équipes sécurité et de modifications de la configuration d'infrastructure. Le troisième article prend de la hauteur : comment formuler correctement les tâches confiées à l'IA pour obtenir un résultat de qualité et reproductible ?
La pyramide des tests est l'un des principes fondamentaux du développement. À la base, on trouve les tests unitaires, rapides et peu coûteux, qui vérifient les fonctions et les méthodes de manière isolée. Au milieu, les tests d'intégration contrôlent les interactions entre composants. Au sommet, les tests end-to-end, lents et coûteux, simulent un scénario utilisateur réel. Le ratio classique : beaucoup de tests unitaires, moins de tests d'intégration, un minimum de tests E2E. Cette structure réduit le temps d'exécution des tests et simplifie le débogage : quand un test unitaire échoue, on sait immédiatement ce qui est cassé.
Le problème surgit dès que c'est un modèle de langage, et non plus un ingénieur, qui conçoit les tests. Un LLM opère dans les limites de sa fenêtre de contexte, c'est-à-dire le volume fixe de tokens que le modèle conserve au cours d'une session de génération. Pour de petites tâches, ce n'est pas critique. Mais si l'on demande au réseau de neurones d'écrire en une seule requête une suite de tests complète pour une application volumineuse, le résultat est prévisible : soit une partie de la logique métier se perd au-delà du contexte, soit le modèle produit des scénarios superficiels, sans prise en compte des dépendances réelles ni des cas limites.
C'est là que la pyramide des tests cesse d'être une théorie de manuel pour devenir un outil concret de décomposition. La métaphore de l'auteur, faire avaler l'éléphant au réseau de neurones bouchée par bouchée, résume bien l'approche. La tâche globale est découpée en couches selon la pyramide : les agents génèrent d'abord des tests unitaires au niveau des fonctions, passent ensuite aux scénarios d'intégration, et n'abordent les tests E2E qu'en dernier. Chaque couche tient dans la fenêtre de contexte du modèle et est traitée de manière isolée, sans perte de qualité due à un débordement du contexte.
Cette approche apporte plusieurs avantages concrets. Chaque requête au modèle devient ciblée : l'agent reçoit un périmètre clair, un contrat d'entrée défini et un artefact précis à produire. Les erreurs sont localisées : si un test unitaire est mal écrit, on le voit immédiatement, et non plusieurs itérations plus tard, quand un scénario d'intégration a déjà été construit dessus. Enfin, la pyramide impose un ordre naturel des dépendances : les tests E2E reposent sur des fondations déjà vérifiées, au lieu d'être développés en parallèle.
Fedorov ne prétend pas réinventer la roue. L'auteur le reconnaît lui-même : il s'agit d'appliquer un principe d'ingénierie connu de longue date à un nouveau contexte. Mais c'est justement là l'idée centrale : l'IA n'abolit pas les principes fondamentaux du développement, elle les rend encore plus importants. Comprendre la pyramide des tests n'est désormais plus réservé aux ingénieurs QA : c'est aussi indispensable pour qui conçoit l'architecture des requêtes adressées aux modèles de langage.
Pour les équipes qui envisagent des outils d'IA pour automatiser leurs tests, la leçon est pratique : concevez d'abord la décomposition de la tâche, puis confiez-la au modèle. L'éléphant se mange bouchée par bouchée, et ce n'est pas une limite de la technologie, mais la seule architecture qui fonctionne.
- 2 nov. 2026Claude Opus 5 a construit des baselines simples qui comblent 95,5% de l'écart avec les modèles DL de Nature et Science
- 2 nov. 2026Sans manager, l'essaim DreamTeam a écrit trustcheck pour $5,68 et réussi 13 tests cachés sur 13
- 2 nov. 2026ASTC compresse le contexte des agents sans entraînement et réduit les Attention Pairs de 50,68%
- 2 nov. 2026TraceSpec augmente de 12,5–22,6% le débit de DSpark pour les agents LLM
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.