Google a appris à l’AI à prévoir les inondations à partir d’anciens reportages de presse
Google utilise d’anciens reportages de presse et un LLM pour prévoir les crues soudaines. Les textes d’archives sont convertis en données numériques, ce qui résout le manque de mesures hydrologiques dans les pays en développement. Le modèle est déjà testé dans des régions sans capteurs ni stations météorologiques.
Traité par IA depuis TechCrunch ; édité par Hamidun News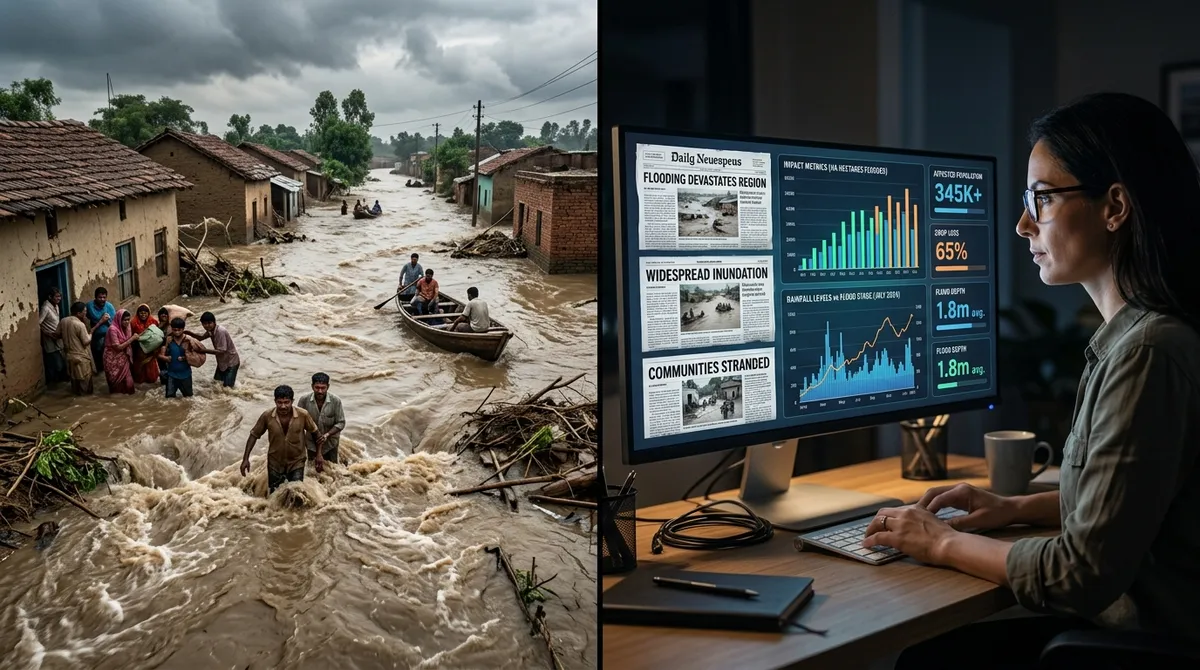
Google a développé une approche non conventionnelle pour prédire les crues soudaines : au lieu d'une infrastructure coûteuse de capteurs, l'entreprise utilise des rapports de presse archivés comme source de données historiques. Un modèle de langage convertit les descriptions textuelles qualitatives de catastrophes naturelles en métriques quantitatives appropriées pour entraîner des modèles hydrologiques. Le problème que cette méthode résout est bien connu des climatologues.
Les modèles précis de prévision des crues exigent des séries de données sur plusieurs années concernant les niveaux d'eau, les précipitations et la topographie. Mais dans la plupart des pays en développement, où les crues sont les plus meurtrières, une telle infrastructure n'existe simplement pas. Les capteurs coûtent cher, nécessitent un entretien et de l'électricité — tout cela fait défaut dans les régions vulnérables.
Pourtant, des informations historiques sur les crues existent bel et bien — dans les archives de journaux, les rapports de publications locales et les communiqués gouvernementaux. Le problème est que ces données sont qualitatives : « une crue importante a inondé trois villages » — ce n'est pas un chiffre avec lequel un modèle traditionnel peut travailler. Google a proposé d'utiliser un LLM comme traducteur : le modèle lit le texte historique et en extrait des estimations numériques structurées de l'ampleur, la durée et la géographie de l'événement.
Les séries numériques synthétiques obtenues sont ensuite utilisées pour entraîner un modèle de prévision des crues. Essentiellement, le journalisme d'archive devient un substitut aux décennies de mesures instrumentales. C'est une façon fondamentalement nouvelle d'aborder la pénurie de données dans les tâches climatiques — une approche potentiellement applicable bien au-delà de l'hydrologie.
Google teste déjà le système dans les régions d'Afrique et d'Asie du Sud, où les avertissements de crues sont pratiquement inexistants. L'entreprise développe son initiative Flood Hub depuis 2023, couvrant actuellement plus de 80 pays. La nouvelle méthode devrait étendre la couverture aux territoires qui précédemment restaient en dehors de la zone de prévision en raison de l'absence de données numériques historiques.
Ceci est un exemple révélateur de la façon dont les LLM transforment la structure même des données scientifiques. Auparavant, la limite entre « avoir des données » et « ne pas avoir de données » était déterminée par la disponibilité d'équipements de mesure. Désormais, cette limite peut être repoussée en utilisant des modèles de langage qui peuvent extraire des informations quantitatives cachées de textes rédigés sans aucun objectif scientifique.
- 28 oct. 2026Un CNN de 2015 surpasse GPT-6 Astra et Claude Fable 5.1 dans le diagnostic du cancer de la peau
- 28 oct. 2026Google apprend aux LLM à « dormir » : SLEEP ancre les connaissances dans les poids, jusqu'à 10 millions de tokens
- 28 oct. 2026Keystone retire le nom du modèle du code : cette passerelle LLM open source ajoute 0,64 ms
- 28 oct. 2026Wired a testé 6 agents IA en 24 heures : Dots en tête, Gemini Spark rate le déjeuner
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.