llm-checker : un utilitaire qui indique quels LLM votre machine peut faire tourner
Un nouvel outil CLI open source, llm-checker, analyse la configuration matérielle d'un ordinateur et détermine quels modèles de langage peuvent tourner en local via Ollama. Il examine le GPU, la mémoire vive et le processeur, puis évalue la compatibilité, la vitesse et la qualité de chacun des plus de 35 modèles, des compacts à 1 milliard de paramètres aux costauds à 32 milliards. La liste de modèles est triée à la main, ce qui garantit l'actualité des recommandations. L'outil s'attaque à l'un des principaux casse-tête des passionnés d'IA locale : cesser de deviner et savoir précisément ce que leur matériel actuel peut encaisser.
Traité par IA depuis Habr AI ; édité par Hamidun News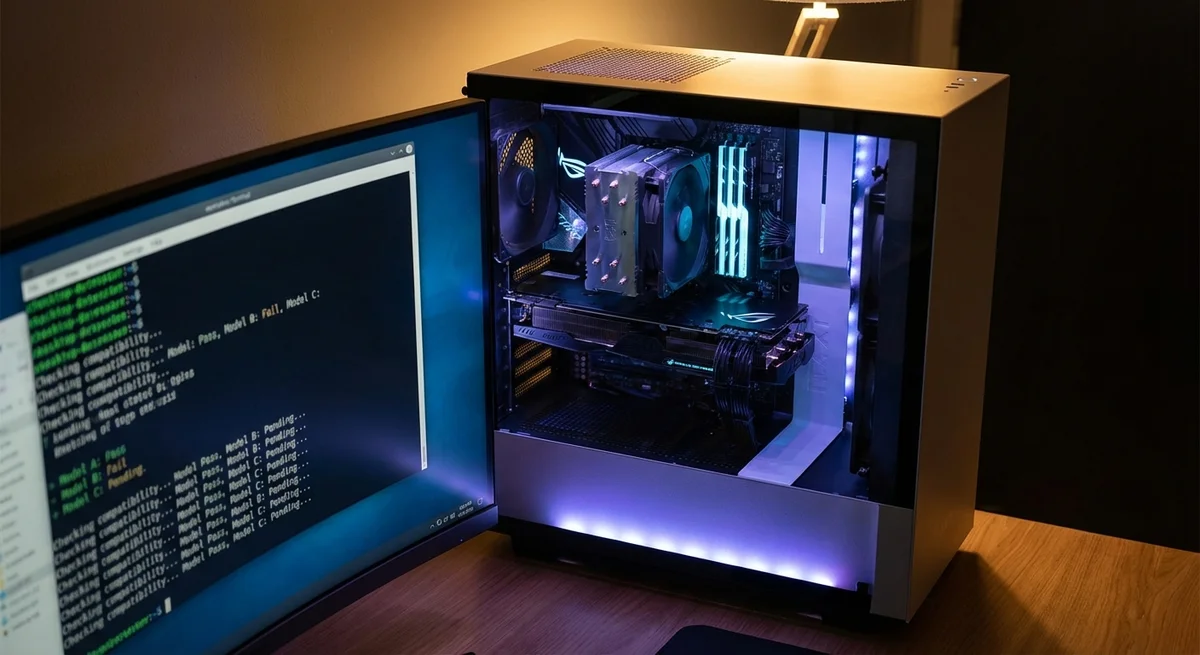
L'une des questions que se posent le plus souvent les passionnés d'exécution locale de modèles de langage paraît trompeusement simple : ma machine va-t-elle tenir le coup ? Jusqu'ici, la réponse se reconstituait à partir de benchmarks épars, de discussions sur Reddit et d'essais personnels par tâtonnement. Un nouvel outil open source, llm-checker, tente de régler la question en une seule commande dans le terminal.
llm-checker est un utilitaire CLI qui analyse la configuration matérielle de l'ordinateur et rend un verdict concret : quels modèles de langage de l'écosystème Ollama vous pouvez exécuter, à quelle vitesse et avec quelle qualité. L'outil examine trois composants clés, la carte graphique, la mémoire vive et le processeur, et en tire un rapport personnalisé pour plus de 35 modèles, des compacts à 1 milliard de paramètres aux imposants 32 milliards.
Pour comprendre l'enjeu, un rappel du contexte s'impose. Ces deux dernières années, l'exécution locale de grands modèles de langage est passée du passe-temps marginal au mouvement à part entière. Ollama est devenu le standard de fait pour qui veut faire tourner un LLM sur son propre ordinateur, sans abonnement cloud et sans envoyer de données à des serveurs tiers.
Llama, Mistral, Gemma, Phi, DeepSeek, Qwen : le nombre de modèles disponibles augmente chaque mois, et chacun a ses propres exigences matérielles. Le problème, c'est que ces exigences n'ont été systématisées nulle part par configuration précise. Avec une RTX 3060 dotée de 12 Go de VRAM et 32 Go de RAM, il faut déterminer soi-même si l'on peut faire tourner Llama 3.
1 à 8 milliards de paramètres en quantification Q4, ou s'il vaut mieux ne même pas essayer.
C'est précisément ce fossé entre l'abondance de modèles et l'opacité des exigences matérielles que comble llm-checker. L'utilitaire fonctionne de façon très directe : vous lancez la commande, il interroge le système, compare les caractéristiques à une base de connaissances interne sur les modèles et renvoie un résultat. Chaque modèle est évalué selon trois axes : compatibilité (démarrera-t-il seulement), vitesse (la génération de tokens sera-t-elle confortable) et qualité (faudra-t-il sacrifier la précision au profit des performances). Ce ne sont pas des scores abstraits, mais une information concrètement utile, qui épargne des heures d'expérimentation.
L'approche retenue pour la sélection des modèles mérite une attention particulière. Les auteurs ont délibérément renoncé à analyser automatiquement tout le catalogue d'Ollama et modèrent la liste à la main. C'est un choix de principe : le catalogue d'Ollama compte des centaines de modèles de qualité inégale, dont des modèles obsolètes, expérimentaux et franchement inutiles. La curation manuelle signifie que l'utilisateur ne reçoit de recommandations que sur des modèles éprouvés et actuels, qui valent vraiment la peine d'être lancés. Dans un monde où le nombre de LLM ouverts double tous les quelques mois, un tel filtre est un atout, pas une limite.
Sur le plan technique, l'outil résout un problème loin d'être trivial. Les performances d'un LLM local dépendent de nombreux facteurs : la quantité de VRAM détermine si le modèle tient entièrement sur le GPU ; la vitesse de la RAM influe sur l'offloading des couches qui n'ont pas tenu dans la VRAM ; l'architecture du processeur compte pour les modèles exécutés en mode CPU. La quantification ajoute une dimension : un même modèle en Q8 peut ne pas tenir en mémoire, tandis qu'en Q4 il fonctionne, mais avec une perte de qualité sensible. llm-checker prend en charge tous ces calculs et les traduit en recommandations claires.
Dans une perspective plus large, l'apparition de tels outils signale la maturation de l'écosystème de l'IA locale. Quand une technologie sort du cercle des développeurs et des passionnés, elle a besoin de ponts entre la complexité et la simplicité. llm-checker en est un. Il n'a rien de révolutionnaire sur le plan technologique, mais il règle un vrai problème d'utilisateurs, ignoré jusqu'ici.
L'outil a bien sûr des limites évidentes. Sa dépendance à Ollama laisse de côté les utilisateurs de llama.cpp, de vLLM ou d'autres backends. La modération manuelle de la liste est à la fois une force et une faiblesse, car l'actualité dépend de l'activité des mainteneurs. Les performances réelles différeront toujours des prévisions, car des dizaines de variables les influencent et ne peuvent être prises en compte à distance, de la température du GPU en charge aux processus en arrière-plan du système.
Reste que llm-checker va dans la bonne direction. À mesure que l'exécution locale de LLM se démocratise, et toutes les tendances vont dans ce sens, le besoin d'outils simples de diagnostic et de recommandation ne fera que croître. Aujourd'hui, c'est un utilitaire CLI pour utilisateurs avancés. Demain, une fonctionnalité similaire pourrait fort bien être intégrée à Ollama lui-même ou à ses équivalents. Car la meilleure façon d'attirer les utilisateurs vers l'IA locale est de lever la barrière de l'incertitude et de donner une réponse honnête à une question simple : que puis-je exécuter exactement, dès maintenant.
- 2 nov. 2026L'assistant Muse de Meta tient un dossier sur vos proches et obtient root par défaut sous Ubuntu
- 2 nov. 2026Un journaliste de The Verge assemble un équivalent du Meta Muse Charm à $50 avec Claude Code
- 1 nov. 2026La couche de protection MoneyGate n'a laissé passer aucune des 42 demandes frauduleuses adressées à des IA locales
- 31 oct. 2026La passerelle LLM open source KTMS 1.0 branche ses propres GPU au cloud et résiste aux pannes
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.