OpenAI dévoile GPT-5.3-Codex-Spark, qui tourne sur des puces Cerebras plutôt que Nvidia
OpenAI franchit une étape importante vers l'indépendance matérielle avec GPT-5.3-Codex-Spark. Pour la première fois, un produit phare de l'entreprise a été entraîné et déployé non pas sur des GPU Nvidia, mais sur des puces Wafer Scale Engine 3 de la start-up Cerebras Systems. Le WSE-3 est une énorme puce de la taille d'une plaque de silicium entière, dotée d'une puissance de calcul colossale. Cette initiative vise à diversifier les chaînes d'approvisionnement d'OpenAI et à réduire sa dépendance aux accélérateurs Nvidia, en pénurie. Le passage à du matériel alternatif peut modifier sensiblement l'économie de l'entraînement des grands modèles de langage et accélérer le développement de nouvelles architectures.
Traité par IA depuis 3DNews AI ; édité par Hamidun News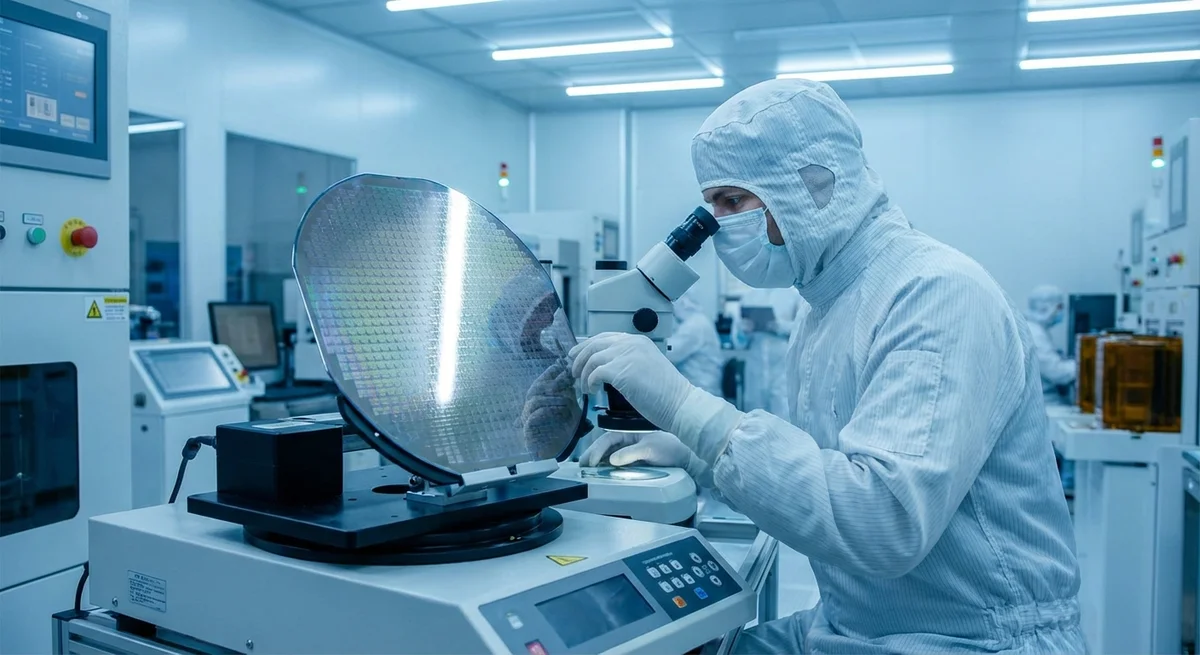
# OpenAI renonce à Nvidia. Ce que cela signifie pour l'avenir de l'intelligence artificielle
Dans l'histoire des grands modèles de langage, il s'est produit un moment que beaucoup jugeaient impossible. OpenAI a dévoilé GPT-5.3-Codex-Spark, le premier modèle phare de l'entreprise entraîné et déployé non pas sur des processeurs graphiques Nvidia, mais sur des puces alternatives Wafer Scale Engine 3 de Cerebras Systems. Ce pas en dit moins sur l'exploit technique que sur un tournant dans l'économie de l'intelligence artificielle et sur la lutte d'indépendance des entreprises les plus puissantes du secteur.
Au cours des cinq dernières années, Nvidia a instauré un contrôle quasi monopolistique du marché des accélérateurs pour l'entraînement des réseaux de neurones. Lorsqu'il est devenu évident que les architectures transformer exigent une puissance de calcul énorme, tous les grands laboratoires, d'OpenAI à Meta* et Google, ont misé sur ses GPU. Mais dépendre d'un seul fournisseur comporte un risque. Les restrictions à l'exportation vers la Chine, la pénurie de puces et la hausse des prix ont pesé sur les entreprises qui cherchent à faire grandir leurs modèles. OpenAI a souffert en silence comme les autres, mais elle a maintenant décidé d'agir.
Cerebras Systems a proposé une approche inhabituelle. Au lieu de créer des milliers de petits processeurs, l'entreprise a conçu le WSE-3, une puce de silicium monolithique de la taille d'une plaque entière, impossible à installer sur un socket classique. Ce n'est pas seulement une puce, mais une véritable mini-ferme sur un seul morceau de silicium, comptant plus de 900 mille cœurs. Cette solution semble aller à l'encontre des principes de modularité, mais c'est précisément ce qui a permis à Cerebras d'éviter les goulots d'étranglement dans le transfert de données entre processeurs distincts, principal ennemi de l'entraînement parallèle.
Lorsqu'OpenAI a testé l'entraînement de GPT-5.3-Codex-Spark sur le WSE-3, les résultats ont été inattendus. La vitesse de convergence du modèle est restée au niveau de l'entraînement sur Nvidia H100, mais il fallait moins de synchronisation et de déplacements de données entre accélérateurs. Autrement dit, les heures d'inactivité du réseau que l'entreprise perdait auparavant peuvent désormais servir à du calcul utile. Cela veut dire moins cher. Cela veut dire plus rapide.
Mais l'essentiel n'est pas dans les chiffres techniques, c'est dans la portée stratégique. OpenAI a montré qu'il existe une alternative à Nvidia et que de grands modèles peuvent être entraînés ailleurs que sur ses puces. C'est le premier défi sérieux au monopole, et le marché réagit déjà. Les autres acteurs, comme Intel avec Gaudi, AMD avec EPYC et MI300, et même Google avec ses TPU, savent désormais qu'une fenêtre d'opportunité existe. Si OpenAI peut réentraîner un modèle sur du nouveau matériel et obtenir des résultats comparables, ils le peuvent aussi.
L'économie de l'intelligence artificielle va changer, mais pas instantanément. Cerebras ne peut pas encore produire des WSE-3 dans les volumes où Nvidia fabrique des H100. Reconstruire l'infrastructure et réécrire le code pour l'optimiser pour la nouvelle architecture prendra du temps. Le début est néanmoins fait. Dans les deux à trois prochaines années, nous verrons probablement des conceptions d'accélérateurs plus extravagantes et une expérimentation plus active avec des puces neuromorphiques et des ordinateurs quantiques. Nvidia restera un acteur puissant, mais plus le seul.
Pour les utilisateurs ordinaires de ChatGPT, cela ne change presque rien : le modèle reste le même, ses capacités aussi. Pour le secteur, en revanche, la différence est énorme. OpenAI a prouvé qu'une grande intelligence peut être construite autrement, et que dans la course au matériel, ce ne sont pas ceux qui sont arrivés les premiers qui dominent, mais ceux qui pensent le plus vite.
*Meta est reconnue comme organisation extrémiste et interdite en Russie.
- 2 nov. 2026L'assistant Muse de Meta tient un dossier sur vos proches et obtient root par défaut sous Ubuntu
- 1 nov. 2026Les modèles locaux battus par Opus et Codex : 0,21 sur MacBook contre 1,00 pour Codex
- 1 nov. 2026Kimi obtient 96,2 % à un test d'analytique sur une base 1C et s'impose comme solution de repli en cas de blocage de Claude
- 1 nov. 2026OpenAI réécrit les règles de comportement de GPT : cinq valeurs et une chaîne de priorités
Build & Ship Production AI Agents Without Boilerplate Code
Start your free 72-hour trial at Hamidun Academy (academy.hamidun.com) — interactive lessons on Claude Code & Cursor, live Tech Radar, and production agent templates.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.