Gemini 4 Argon apprend au humanoïde Apollo 2 à jouer au cornhole : 7 lancers réussis d'affilée
Google DeepMind a publié un test interne de Gemini 4 Argon. Le modèle a regardé une vidéo d'une personne jouant au cornhole, construit une scène virtuelle dans MuJoCo, calculé la physique et le contrôle du corps entier, puis transmis le résultat au humanoïde Apollo 2 d'Apptronik. Dans le monde réel, le robot a lancé les sacs dans la cible sept fois de suite. Selon DeepMind, le pipeline Video-to-Sim-to-Real réduit des semaines de modélisation manuelle à quelques heures. Le test est interne : il n'existe pour l'instant ni vérification indépendante ni statistiques sur le nombre d'essais. • Entrée : une seule vidéo d'un humain ; sortie : une politique de contrôle opérationnelle pour un humanoïde. • Résultat : 7 lancers réussis d'affilée sur un robot réel. • Gain annoncé : de plusieurs semaines à quelques heures.
Traité par IA depuis YouTube: Google DeepMind ; édité par Hamidun News
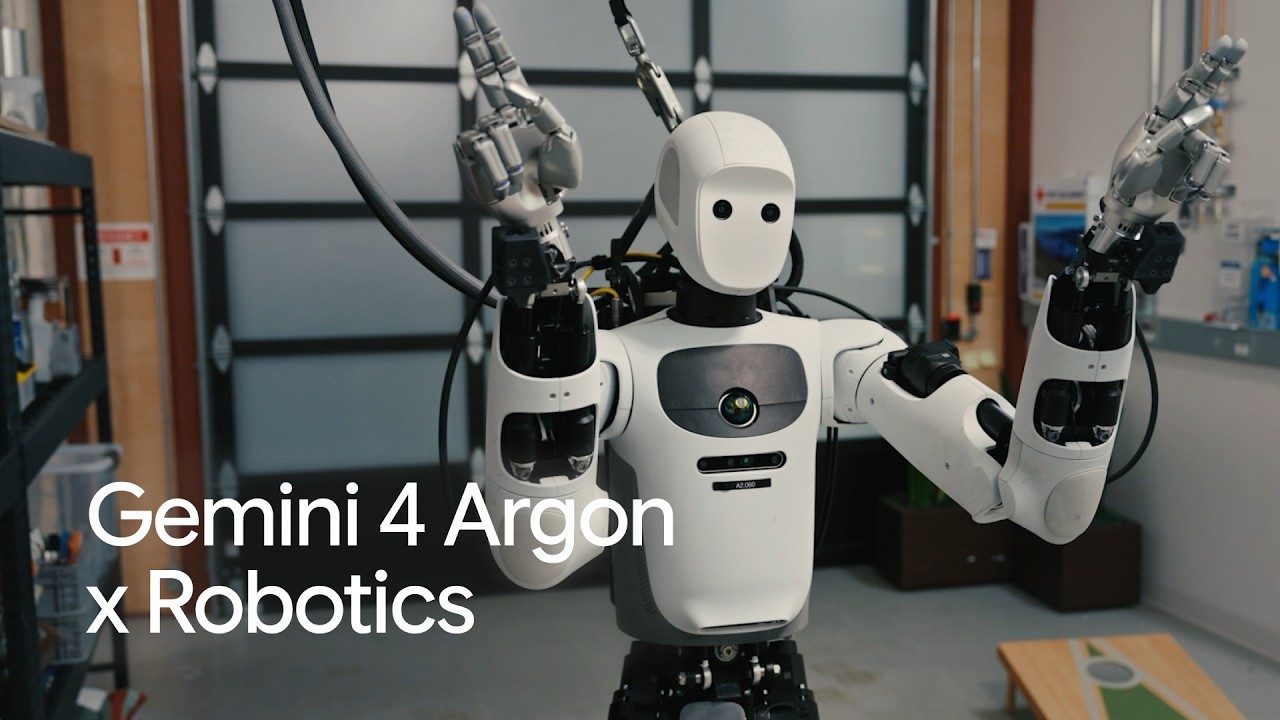
Google DeepMind a dévoilé un test interne de Gemini 4 Argon en robotique. Le modèle a regardé une vidéo où une personne joue au cornhole et a préparé le contrôle du humanoïde Apollo 2 d'Apptronik. Dans le monde réel, le robot a lancé les sacs dans la cible sept fois de suite. DeepMind affirme que son pipeline Video-to-Sim-to-Real réduit des semaines de modélisation manuelle à quelques heures.
De la vidéo à la simulation, puis au sol réel
Le cornhole paraît simple : il faut envoyer un sac de grains dans le trou d'un plateau incliné. Pour un humanoïde, cela mobilise plusieurs tâches à la fois. Il doit saisir le sac, transférer son poids, choisir une trajectoire et relâcher l'objet au moment précis. Une erreur à n'importe quelle étape envoie le lancer à côté.
Selon la description de DeepMind, la chaîne fonctionne ainsi. Les chercheurs fournissent à Gemini 4 Argon une vidéo du joueur. Le modèle s'appuie sur sa compréhension vidéo et son raisonnement avancé pour construire une scène virtuelle dans le moteur physique MuJoCo. Il calcule ensuite la physique du lancer et les paramètres de contrôle du corps entier. La solution obtenue est transférée sur Apollo 2 dans le monde réel.
L'élément clé n'est pas le lancer lui-même, mais l'étape intermédiaire. Jusqu'ici, une équipe d'ingénieurs construisait cette simulation à la main : mesures, modélisation des objets, réglage des paramètres de contact. DeepMind affirme que cela ne prend désormais que quelques heures.
Ce que disent les chiffres
- Modèle : Gemini 4 Argon.
- Robot : humanoïde Apollo 2, fabriqué par Apptronik.
- Simulateur : MuJoCo.
- Données d'entrée : une vidéo où une personne joue au cornhole.
- Résultat dans le monde réel : sept lancers réussis d'affilée.
- Gain de temps annoncé : de plusieurs semaines de modélisation manuelle à quelques heures.
- Format du test : interne, réalisé par les chercheurs de DeepMind.
Ce qui reste hors champ
La description de la vidéo laisse de nombreuses questions ouvertes. DeepMind ne précise ni la distance jusqu'au plateau ni la taille de la cible. On ignore combien d'essais ont précédé la série de sept lancers et si un humain est intervenu dans la calibration. Rien n'indique ce que produit exactement le modèle : code du contrôleur, trajectoires ou paramètres de la politique. On ne sait pas non plus comment l'écart entre simulation et réalité, principal problème de l'approche sim-to-real, a été comblé.
Une série de sept réussites fait bonne figure dans une vidéo, mais ne remplace pas des statistiques. Pour évaluer le système, il faudrait un taux de réussite sur un long échantillon, la dispersion selon les conditions et le comportement face à un changement de sac ou d'éclairage. Il n'existe pour l'instant aucune vérification indépendante.
La direction, elle, est claire. Le principal goulet d'étranglement de l'IA physique se situe aujourd'hui dans les données et les environnements d'entraînement. La téléopération coûte cher et la construction manuelle de simulations est lente. Si un modèle de langage doté de compréhension vidéo construit réellement une scène physique exploitable à partir d'une simple vidéo, n'importe quelle vidéo en ligne devient un environnement d'entraînement potentiel. La question se déplace alors de « où trouver des données » à « avec quelle précision le modèle reconstruit la physique ».
Ce que les équipes doivent faire
Les roboticiens devraient passer en revue leur propre cycle de développement et identifier où part le temps : collecte de données, modélisation de la scène ou transfert vers le réel. Si l'essentiel des coûts vient de la modélisation, l'approche « vidéo → simulation » mérite d'être testée sur leurs propres tâches. MuJoCo est ouvert, et la reconstruction de scènes à partir de vidéos peut déjà s'essayer avec des modèles multimodaux accessibles, sans attendre un accès partenaire à Gemini 4 Argon.
Ces systèmes doivent être évalués sur la répétabilité d'une longue série d'essais, et non sur la meilleure exécution. Pour ceux qui suivent le marché des humanoïdes, deux points sont à surveiller : DeepMind et Apptronik publieront-ils des métriques, et le pipeline sera-t-il ouvert aux développeurs externes ? Pour l'instant, c'est une démonstration convaincante, mais pas un produit.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.