IA et logistique : le modèle VLA de Nomagic divise par deux les appels aux opérateurs
Nomagic, basée à Varsovie, a intégré un modèle de type vision-language-action (VLA) dans les opérations d'entrepôt réelles de clients commerciaux, et celui-ci a divisé par deux la fréquence des « blocages » où le robot a besoin de l'aide d'un opérateur. Le nouveau laboratoire d'IA de l'entreprise est dirigé par un ancien chercheur de Google DeepMind. L'équipe mise sur une stratégie de « maîtrise avant l'universalité » : d'abord parfaitement maîtriser des tâches d'entrepôt précises, comme la saisie, le tri et le déplacement de marchandises, et seulement ensuite songer à une applicabilité plus large.
Traité par IA depuis TNW ; édité par Hamidun News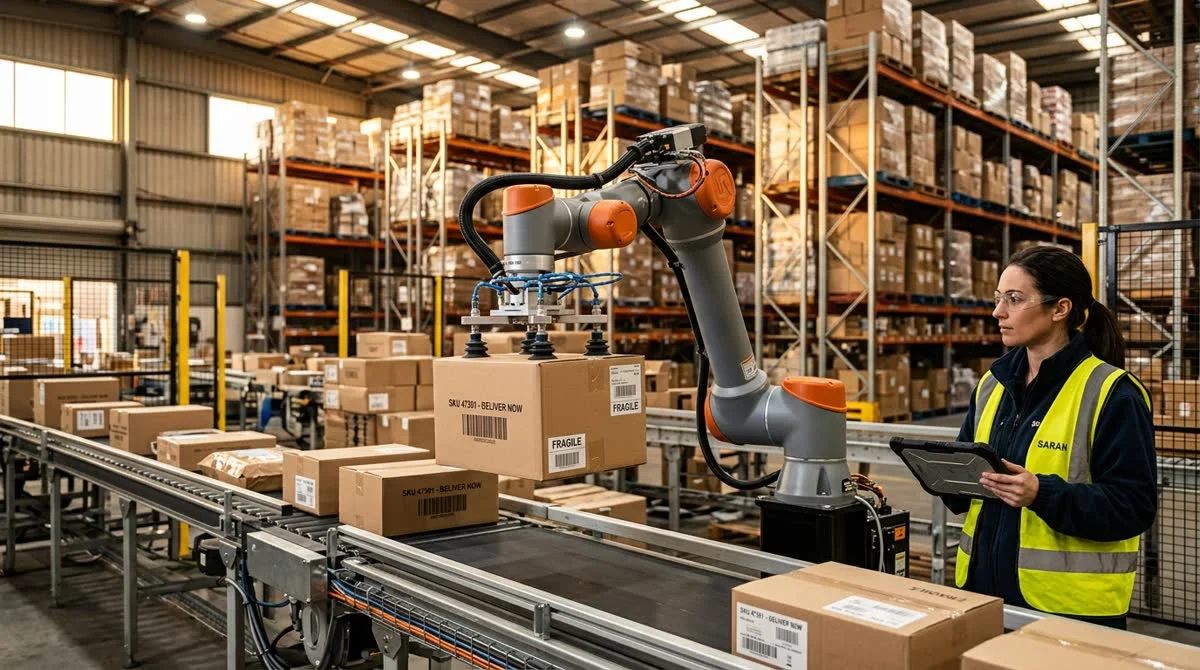
Nomagic a déployé un réseau de neurones VLA dans la logistique d'entrepôt, et l'IA a divisé par deux les appels aux opérateurs : le déploiement du modèle a commencé en juillet 2026 chez des clients commerciaux.
Qu'est-ce qu'un modèle VLA, et à quoi sert-il à un robot d'entrepôt ?
Les modèles vision-language-action sont des réseaux de neurones qui réunissent trois composantes dans une seule architecture : la vision par ordinateur (ce que le robot voit devant lui), la compréhension du contexte (quelle tâche accomplir avec cet objet) et la planification des actions (comment piloter précisément le manipulateur). La programmation classique impose d'écrire à la main des règles pour chaque type de produit ou scénario atypique. Un modèle VLA, lui, prend ses décisions de façon dynamique, comme une personne qui saisit un objet inconnu sans ouvrir le mode d'emploi.
Jusqu'à récemment, les modèles VLA vivaient surtout en laboratoire, testés sur des ensembles d'objets limités dans des environnements contrôlés. Nomagic, entreprise varsovienne spécialisée dans les manipulateurs pour la logistique d'entrepôt, a transposé cette technologie en conditions réelles.
- Type de modèle : vision-language-action (VLA)
- Entreprise : Nomagic, Varsovie, Pologne
- Résultat : baisse de ~50% de la fréquence des demandes d'intervention d'un opérateur
- Laboratoire d'IA : ouvert en 2026, dirigé par un ancien chercheur de Google DeepMind
- Stratégie : « mastery before generality » : d'abord la maîtrise de tâches précises, ensuite l'universalité
Pourquoi
Nomagic parie sur la maîtrise plutôt que sur l'universalité
Un récit domine la course à la robotique : créer un agent universel capable d'agir dans n'importe quel environnement et avec n'importe quel objet. C'est ce que visent Physical Intelligence, Google DeepMind et plusieurs autres grands laboratoires. Nomagic a délibérément choisi une autre voie.
Le nouveau laboratoire d'IA de l'entreprise est dirigé par un ancien chercheur de Google DeepMind, qui connaît bien de l'intérieur cette course à la généralisation. Pourtant, l'équipe de Nomagic resserre volontairement son champ : la maîtrise approfondie d'un ensemble précis d'opérations d'entrepôt (saisie, déplacement et tri de marchandises hétérogènes à cadence industrielle) compte davantage que la capacité à gérer des tâches arbitraires.
Le raisonnement est pragmatique : un client qui construit un centre de fulfillment automatisé n'a pas besoin d'un robot qui ouvre les portes ou prépare le café. Il veut qu'à trois heures du matin, quand arrive un lot à l'emballage atypique, le système ne se « bloque » pas en attendant un opérateur.
Ce qui a changé dans les opérations d'entrepôt
La métrique clé du fulfillment robotisé est le « human-in-the-loop rate » : la part des situations où le système ne peut pas s'en sortir seul et demande l'aide d'un humain. Chaque appel de ce type ralentit le convoyeur, ajoute des coûts d'exploitation et freine le passage à l'échelle sans augmentation des effectifs.
Selon Nomagic, le déploiement du modèle VLA a réduit cet indicateur d'environ moitié sur les sites de clients commerciaux. Point essentiel : il s'agit du même matériel, les robots n'ont pas été remplacés. Le doublement de l'autonomie vient uniquement du nouveau « cerveau ».
Pour l'industrie, c'est un signal important : les modèles VLA ont franchi un seuil à partir duquel on peut non seulement les présenter sur des stands, mais aussi les déployer en exploitation réelle avec un résultat commercial mesurable.
Ce que cela signifie
Nomagic a fait ce que l'industrie robotique promet depuis des années : faire passer un modèle d'IA de nouvelle génération de la recherche à la production et obtenir un résultat concret et mesurable. La stratégie de la « maîtrise d'abord » pourrait s'avérer un chemin plus court vers des entrepôts réellement autonomes que le développement d'un agent universel.
Qu'est-ce qu'un modèle VLA pour les robots ?
Un modèle VLA est un réseau de neurones qui réunit vision par ordinateur (ce que voit le robot), compréhension du contexte et compétences d'action dans une seule architecture. Chez Nomagic, cela a permis aux robots de résoudre seuls des tâches d'entrepôt et de diviser par deux le besoin d'aide d'un opérateur.
Qu'est-ce qu'un réseau de neurones VLA ?
Un modèle VLA réunit vision par ordinateur, compréhension du contexte et exécution d'actions dans une seule architecture de réseau de neurones pour piloter des robots.
De combien le réseau de neurones VLA a-t-il réduit le nombre d'appels
aux opérateurs ? D'environ 50% (de moitié) : Nomagic a constaté une division par deux du nombre de cas où le robot nécessite l'intervention d'un opérateur.
- 1 nov. 2026Test de 16 modèles sur 7 moteurs de recherche : Exa obtient en moyenne 10,5 points sur 14, SearXNG environ 3
- 1 nov. 2026L'agent vidéo StreamVibe de Google devance les autres modèles de 10,7 % sur le timing et la qualité des réponses
- 1 nov. 2026OpenAI réécrit les règles de comportement de GPT : cinq valeurs et une chaîne de priorités
- 1 nov. 2026Les bots vocaux à base de LLM s'appuient sur le classifieur rapide Jev : une décision en 200–500 ms
Questions clés sur cet article
Qu'est-ce qu'un modèle VLA, et à quoi sert-il à un robot d'entrepôt ?
Les modèles vision-language-action sont des réseaux de neurones qui réunissent trois composantes dans une seule architecture : la vision par ordinateur (ce que le robot voit devant lui), la compréhension du contexte (quelle tâche accomplir avec cet objet) et la planification des actions (comment piloter précisément le manipulateur). La programmation classique impose d'écrire à la main des règles pour chaque type de produit ou scénario atypique. Un modèle VLA, lui, prend ses décisions de façon dynamique, comme une personne qui saisit un objet inconnu sans ouvrir le mode d'em
Qu'est-ce qu'un modèle VLA pour les robots ?
Un modèle VLA est un réseau de neurones qui réunit vision par ordinateur (ce que voit le robot), compréhension du contexte et compétences d'action dans une seule architecture. Chez Nomagic, cela a permis aux robots de résoudre seuls des tâches d'entrepôt et de diviser par deux le besoin d'aide d'un opérateur.
Qu'est-ce qu'un réseau de neurones VLA ?
Un modèle VLA réunit vision par ordinateur, compréhension du contexte et exécution d'actions dans une seule architecture de réseau de neurones pour piloter des robots.
De combien le réseau de neurones VLA a-t-il réduit le nombre d'appels aux opérateurs ?
D'environ 50% (de moitié) : Nomagic a constaté une division par deux du nombre de cas où le robot nécessite l'intervention d'un opérateur.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.