AI red teaming : comment les entreprises testent la vulnérabilité de l'IA avant sa mise en production
Alors que l'IA s'infiltre dans les processus métier, tester les systèmes face à des attaques hostiles devient une étape obligatoire. L'AI red teaming consiste à simuler les actions d'un attaquant : injections de prompts, vol de données, manipulations en plusieurs étapes. Sans cette vérification, une entreprise risque de lancer un modèle non sécurisé, que les régulateurs et les attaquants bien réels attendent déjà.
Traité par IA depuis AI News ; édité par Hamidun News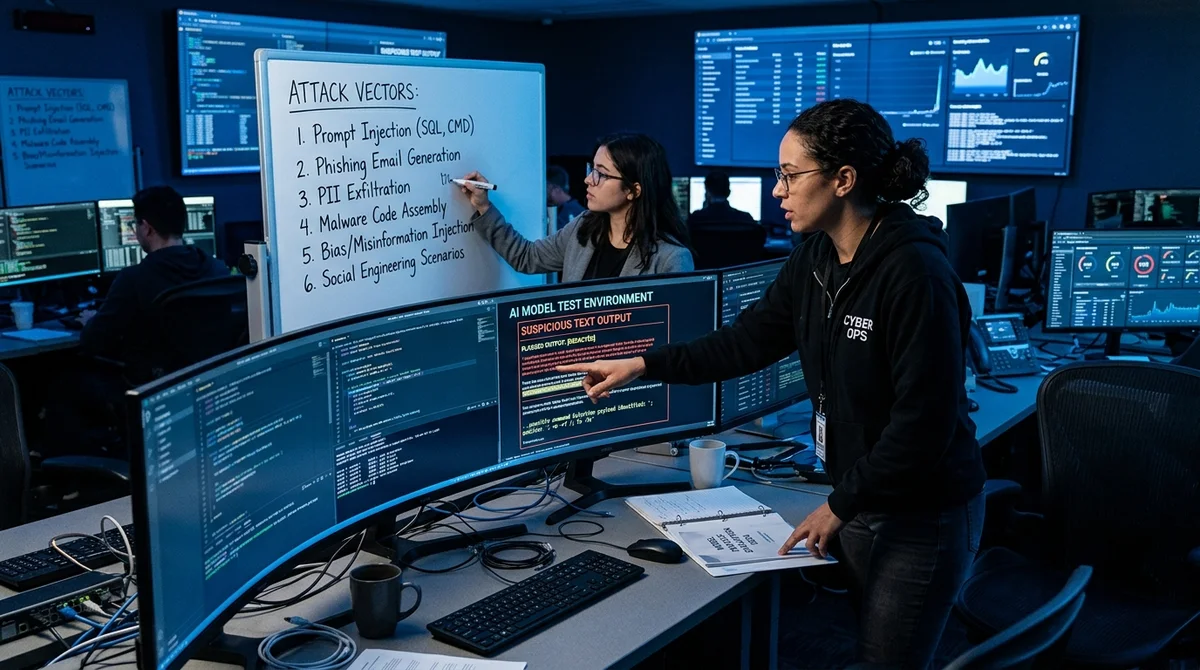
Avec la multiplication des déploiements d'IA, tester les systèmes sous pression hostile passe du statut de pratique de niche à celui de nécessité pour toute entreprise sérieuse. L'AI red teaming permet de détecter les vulnérabilités avant que le modèle ne tombe entre les mains d'utilisateurs réels, ou d'attaquants réels.
Qu'est-ce que l'AI red teaming
Le terme vient de l'analyse militaire : une « équipe rouge » simulait les actions de l'adversaire pour repérer les faiblesses de sa propre défense avant un affrontement réel. Dans le monde de l'IA, cela désigne des tentatives organisées de tromper, de casser ou de forcer un modèle à adopter un comportement indésirable.
Les tests logiciels classiques vérifient si le système fonctionne conformément à sa spécification. L'AI red teaming vérifie comment il se comporte en dehors. C'est là que se cachent les défaillances les plus dangereuses.
Les spécialistes emploient plusieurs types d'attaques :
- Injections de prompts : tentatives de faire ignorer au modèle ses instructions système et de le faire sortir du comportement défini
- Extraction de données : tentatives d'obtenir, à partir des réponses du modèle, des données d'entraînement ou des informations confidentielles d'utilisateurs
- Manipulations en plusieurs étapes : pousser progressivement le modèle à enfreindre ses restrictions par une série de requêtes d'apparence anodine
- Adversarial inputs : entrées spécialement conçues pour modifier la réponse du modèle de façon inattendue ou nuisible
- Tests de biais : recherche systématique de schémas discriminatoires, toxiques ou nuisibles dans les réponses
Pourquoi c'est crucial
Les entreprises qui sautent cette étape prennent des risques considérables. Les modèles de langage intégrés aux processus métier peuvent donner des conseils dangereux, divulguer par inadvertance des données personnelles ou servir à des fraudes via un système auquel les utilisateurs font confiance.
Les régulateurs commencent déjà à l'exiger. Le règlement européen sur l'IA prévoit une évaluation de sécurité obligatoire pour les systèmes à haut risque avant leur mise sur le marché. Aux États-Unis, le NIST a publié un cadre de gestion des risques de l'IA où l'évaluation de la résistance aux attaques occupe une place centrale. Dans la finance, la santé et la défense, les régulateurs sectoriels vont encore plus loin.
« Les modèles peuvent être convaincants et sûrs d'eux dans des réponses fausses ou nuisibles.
C'est précisément pourquoi chaque système nécessite un regard indépendant et hostile », telle est la position commune des chercheurs en sécurité de l'IA.
Qui le fait, et comment
Plusieurs types de prestataires se sont formés sur le marché de l'AI red teaming. De grands cabinets de conseil ont ajouté ce service à leur pratique existante de cybersécurité. Parallèlement, une génération de startups spécialisées, issues de la recherche académique sur la sécurité des LLM, a émergé.
Gamme type de services :
- Recherche automatisée de vulnérabilités à l'aide d'agents d'IA attaquants
- Tests manuels par des équipes expérimentées en apprentissage automatique et en ingénierie sociale
- Surveillance continue du comportement d'un système déjà déployé
- Évaluations spécialisées pour des secteurs précis et des exigences réglementaires
Anthropic, OpenAI et Google DeepMind mènent un red teaming interne à grande échelle pour leurs modèles de base. Mais en intégrant le LLM d'un tiers dans son propre produit, une entreprise obtient un système fondamentalement différent : un autre contexte, d'autres utilisateurs, d'autres risques. Cela exige une vérification distincte.
Ce que cela signifie
L'AI red teaming cesse d'être une niche académique et devient une composante standard du cycle de vie d'un produit d'IA. Les entreprises qui ignorent cette étape risquent d'être prises au dépourvu, tant face aux exigences réglementaires que face aux incidents réels qui surviennent déjà dans toute l'industrie.
- 1 nov. 2026Les modèles locaux battus par Opus et Codex : 0,21 sur MacBook contre 1,00 pour Codex
- 1 nov. 2026Kimi obtient 96,2 % à un test d'analytique sur une base 1C et s'impose comme solution de repli en cas de blocage de Claude
- 1 nov. 2026OpenAI réécrit les règles de comportement de GPT : cinq valeurs et une chaîne de priorités
- 1 nov. 2026Google reconnaît que l'AI Mode réduit les revenus de la recherche, l'action chute de 15%
Questions clés sur cet article
Qu'est-ce que l'AI red teaming?
Le terme vient de l'analyse militaire : une « équipe rouge » simulait les actions de l'adversaire pour repérer les faiblesses de sa propre défense avant un affrontement réel. Dans le monde de l'IA, cela désigne des tentatives organisées de tromper, de casser ou de forcer un modèle à adopter un comportement indésirable. Les tests logiciels classiques vérifient si le système fonctionne conformément à sa spécification. L'AI red teaming vérifie comment il se comporte en dehors. C'est là que se cachent les défaillances les plus dangereuses. Les spécialistes emploient plusieurs t
Pourquoi c'est crucial?
Les entreprises qui sautent cette étape prennent des risques considérables. Les modèles de langage intégrés aux processus métier peuvent donner des conseils dangereux, divulguer par inadvertance des données personnelles ou servir à des fraudes via un système auquel les utilisateurs font confiance. Les régulateurs commencent déjà à l'exiger. Le règlement européen sur l'IA prévoit une évaluation de sécurité obligatoire pour les systèmes à haut risque avant leur mise sur le marché. Aux États-Unis, le NIST a publié un cadre de gestion des risques de l'IA où l'évaluation de la r
Que sait-on sur Qui le fait, et comment ?
Plusieurs types de prestataires se sont formés sur le marché de l'AI red teaming. De grands cabinets de conseil ont ajouté ce service à leur pratique existante de cybersécurité. Parallèlement, une génération de startups spécialisées, issues de la recherche académique sur la sécurité des LLM, a émergé. Gamme type de services : Recherche automatisée de vulnérabilités à l'aide d'agents d'IA attaquants Tests manuels par des équipes expérimentées en apprentissage automatique et en ingénierie sociale Surveillance continue du comportement d'un système déjà déployé Évaluations spéc
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.