AWS et NVIDIA lancent l'entraînement à grande échelle du robot Unitree H1 sur SageMaker AI
AWS et NVIDIA ont montré comment faire passer à l'échelle, dans le cloud, l'apprentissage par renforcement du robot humanoïde Unitree H1. Le simulateur NVIDIA Isaac Lab tourne désormais sur Amazon SageMaker AI, avec des milliers d'environnements virtuels en parallèle et deux modes de lancement : HyperPod pour les expériences longues et Training Jobs pour les exécutions ponctuelles. Un seul nœud H100 peut entraîner 4096 environnements simultanément, et la durée d'entraînement passe de plusieurs jours à quelques heures.
Traité par IA depuis AWS Machine Learning Blog ; édité par Hamidun News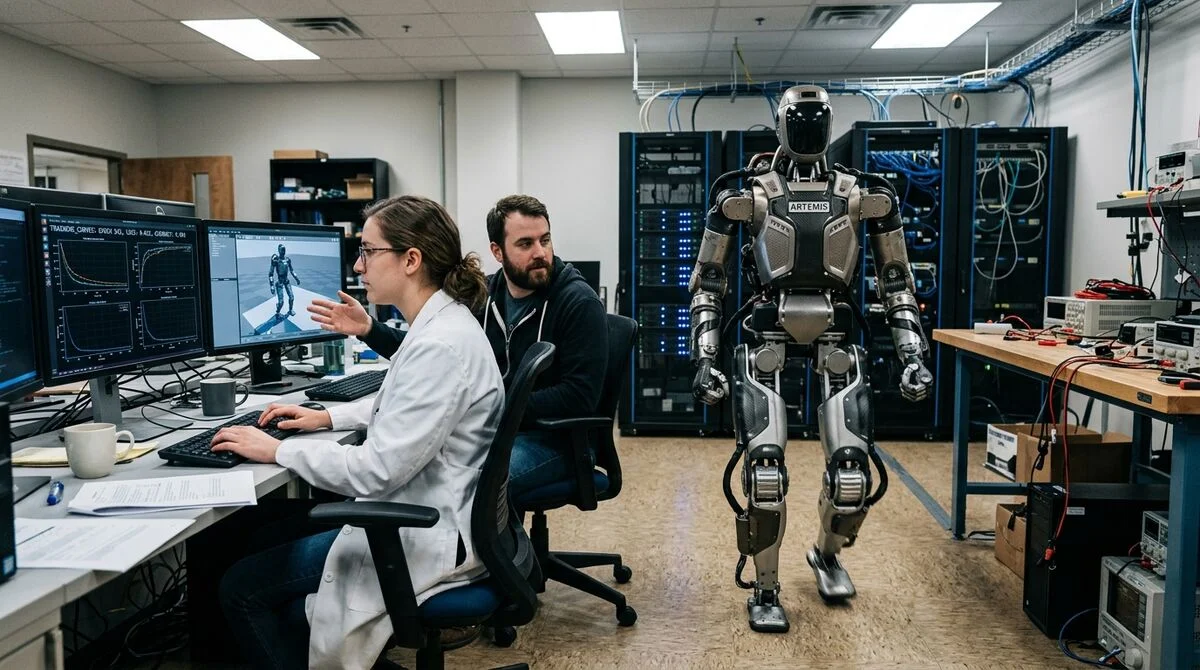
AWS, avec NVIDIA, a présenté un pipeline complet pour entraîner des politiques de contrôle du robot humanoïde Unitree H1 directement dans le cloud, sans cluster de GPU maison.
Pourquoi le cloud pour les robots
L'apprentissage par renforcement pour les robots physiques nécessite des milliards de pas de simulation, et ce n'est pas une exagération. Pour qu'un humanoïde apprenne à avancer sans tomber, le réseau de neurones doit traverser des dizaines de milliards d'interactions entre un agent virtuel et son environnement. Le faire dans le monde réel est coûteux et dangereux : une expérience ratée peut signifier des milliers de dollars de réparations, et le processus prendrait des années au lieu de quelques heures. C'est pourquoi le secteur parie sur la simulation physique.
La course à une « loi de Moore pour les robots » a déjà commencé : Tesla, Figure, Boston Dynamics et des dizaines de startups investissent des centaines de millions dans la création d'environnements d'entraînement synthétiques.
NVIDIA Isaac Lab est un simulateur accéléré par GPU, capable de lancer simultanément des milliers de copies d'un environnement virtuel sur un seul nœud. Jusqu'ici, il était surtout utilisé dans de grands laboratoires d'entreprise et d'université disposant de matériel coûteux.
Isaac Lab est désormais directement intégré à Amazon SageMaker AI. Concrètement, une demande portant sur des centaines de GPU est satisfaite en quelques minutes, et l'ingénieur n'a pas à se soucier de l'infrastructure, seulement du code de la politique et de la configuration de la tâche.
Deux modes de lancement
AWS propose deux modes pour différents scénarios d'usage :
- SageMaker HyperPod : un cluster géré et persistant ; l'infrastructure est conservée d'un lancement à l'autre, ce qui convient aux recherches de plusieurs semaines et au réglage itératif des hyperparamètres
- SageMaker Training Jobs : un lancement géré à usage unique ; les ressources sont allouées strictement à la tâche et libérées automatiquement à sa fin, ce qui simplifie le contrôle du budget
- Les instances des séries p4d et p5 sont prises en charge, avec respectivement des NVIDIA A100 et H100
- Isaac Lab se déploie dans un conteneur Docker standard ; les poids du modèle et les checkpoints sont enregistrés automatiquement sur Amazon S3
- Les métriques d'entraînement (reward, episode length, entropy loss) arrivent dans Amazon CloudWatch en temps réel
L'avantage clé des deux options est la suppression de la charge opérationnelle. Inutile de configurer soi-même Kubernetes, de gérer le réseau InfiniBand entre les nœuds ou d'équilibrer manuellement la charge entre les GPU.
Comment se déroule l'entraînement du Unitree H1
L'Unitree H1 est l'un des humanoïdes de série les plus accessibles : environ 180 cm, 47 kg et 19 degrés de liberté. Cela en fait une plateforme prisée pour la recherche académique sur le contrôle du mouvement.
Dans la simulation Isaac Lab, des milliers de copies virtuelles du robot apprennent à marcher en parallèle grâce à l'algorithme Proximal Policy Optimization (PPO) : elles tombent, se relèvent, corrigent leur équilibre et reçoivent une récompense pour une progression stable vers l'avant. La qualité de la politique entraînée dépend de la précision avec laquelle la fonction de récompense décrit le comportement souhaité.
Sur un seul nœud H100, Isaac Lab peut lancer jusqu'à 4096 simulations parallèles simultanément. Lors du passage à l'échelle sur plusieurs nœuds, l'entraînement distribué via PyTorch DDP prend le relais, et la synchronisation des gradients entre les GPU se fait automatiquement.
«
Passer à des centaines de GPU via SageMaker réduit le temps d'entraînement de plusieurs jours à quelques heures », notent les auteurs de la publication sur le blog d'AWS.
Une fois l'entraînement terminé, la politique est exportée aux formats ONNX ou TorchScript et peut être transférée sur du matériel réel via NVIDIA Isaac ROS.
Ce que cela signifie
L'apprentissage par renforcement dans le cloud pour les robots sort du cadre des laboratoires dotés de budgets matériels de plusieurs millions. Toute petite équipe disposant d'un compte AWS peut désormais lancer une expérience sérieuse d'entraînement d'humanoïde sans investissement en capital dans l'infrastructure.
Cela change l'économie de la robotique : le seuil d'entrée baisse, la vitesse d'itération augmente, et les prochaines percées dans le contrôle des robots physiques pourraient fort bien venir d'équipes étonnamment petites.
- 31 oct. 2026Worldwide Express confie ses factures litigieuses à des agents IA et réduit sa dette de 75%
- 30 oct. 2026AWS offre aux agents de codage un aperçu en direct du site, depuis leur session isolée
- 30 oct. 2026MoEngage ouvre 400 API privées à ses agents IA via AgentCore Gateway, sans serveurs MCP maison
- 29 oct. 2026NVIDIA Nemotron 3.5 Super VL : 120 milliards de paramètres, 12 milliards actifs, déploiement sur AWS
Questions clés sur cet article
Pourquoi le cloud pour les robots?
L'apprentissage par renforcement pour les robots physiques nécessite des milliards de pas de simulation, et ce n'est pas une exagération. Pour qu'un humanoïde apprenne à avancer sans tomber, le réseau de neurones doit traverser des dizaines de milliards d'interactions entre un agent virtuel et son environnement. Le faire dans le monde réel est coûteux et dangereux : une expérience ratée peut signifier des milliers de dollars de réparations, et le processus prendrait des années au lieu de quelques heures. C'est pourquoi le secteur parie sur la simulation physique. La course
Que sait-on sur Deux modes de lancement ?
AWS propose deux modes pour différents scénarios d'usage : SageMaker HyperPod : un cluster géré et persistant ; l'infrastructure est conservée d'un lancement à l'autre, ce qui convient aux recherches de plusieurs semaines et au réglage itératif des hyperparamètres SageMaker Training Jobs : un lancement géré à usage unique ; les ressources sont allouées strictement à la tâche et libérées automatiquement à sa fin, ce qui simplifie le contrôle du budget Les instances des séries p4d et p5 sont prises en charge, avec respectivement des NVIDIA A100 et H100 Isaac Lab se déploie da
Comment se déroule l'entraînement du Unitree H1?
L'Unitree H1 est l'un des humanoïdes de série les plus accessibles : environ 180 cm, 47 kg et 19 degrés de liberté. Cela en fait une plateforme prisée pour la recherche académique sur le contrôle du mouvement. Dans la simulation Isaac Lab, des milliers de copies virtuelles du robot apprennent à marcher en parallèle grâce à l'algorithme Proximal Policy Optimization (PPO) : elles tombent, se relèvent, corrigent leur équilibre et reçoivent une récompense pour une progression stable vers l'avant. La qualité de la politique entraînée dépend de la précision avec laquelle la fonct
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.