LangChain : comment l'ingénierie des boucles agentiques fiabilise les agents IA
Un agent IA fiable ne se résume pas à un bon modèle. LangChain a publié une analyse de l'« ingénierie des boucles » : comment concevoir l'agent loop pour que l'agent fonctionne de façon stable sur des tâches réelles. La clé tient aux couches. Les boucles internes traitent des sous-tâches précises, tandis que les boucles externes pilotent l'orchestration. Les primitives de LangChain aident à instrumenter chaque niveau et à repérer où l'agent déraille.
Traité par IA depuis LangChain Blog ; édité par Hamidun News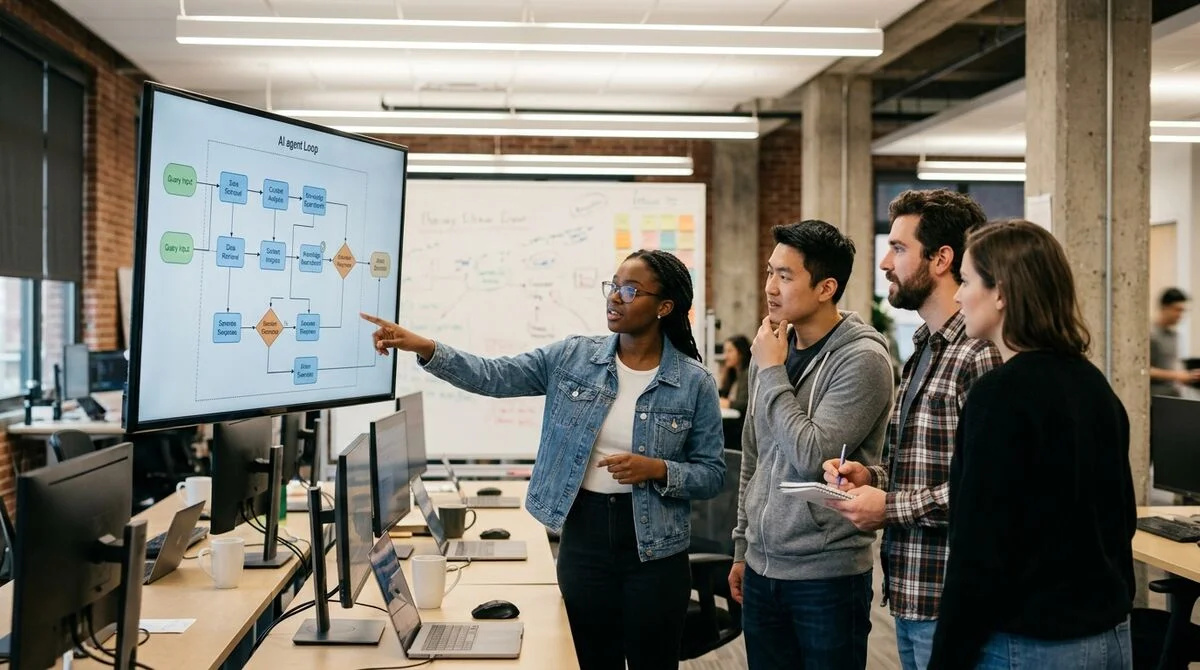
LangChain a publié une analyse de l'une des décisions d'architecture centrales dans la création d'agents IA : comment concevoir correctement la « boucle agentique » et pourquoi la fiabilité en production en dépend, plutôt que du choix du modèle.
Pourquoi le modèle ne suffit pas
La plupart des développeurs butent sur le même problème : l'agent fonctionne bien en démo, mais échoue sur des tâches réelles. Selon LangChain, le problème vient rarement du modèle lui-même. Il vient de l'absence d'un harness (harnais) bien pensé, qui entoure le modèle et contrôle le flux d'exécution.
Un agent n'est pas un simple appel à un LLM avec des outils. C'est un processus itératif contrôlé : il examine l'état, choisit une action, obtient un résultat, met à jour l'état, puis recommence. La fiabilité dépend du soin apporté à la conception de cette boucle.
Anatomie de l'agent loop
La boucle de base comprend quatre étapes, répétées jusqu'à l'achèvement de la tâche :
- Observation — l'agent reçoit le contexte courant : la tâche, l'historique et les résultats des outils précédents
- Raisonnement — le LLM décide de la suite : appeler un outil, demander une précision ou terminer
- Action — un appel d'outil ou la réponse finale
- Mise à jour — le résultat est écrit dans l'état et la boucle se poursuit
L'idée clé : chaque niveau doit disposer de ses propres outils d'observation. Sans journalisation à chaque étape, impossible de savoir où l'agent se trompe exactement.
Empiler et étendre les boucles
Les agents complexes utilisent des boucles imbriquées avec des horizons de décision différents. La boucle externe pilote la tâche globale : elle la découpe en sous-tâches, suit l'avancement et décide quand s'arrêter. Les boucles internes traitent des sous-tâches précises, comme la recherche, l'écriture de code et la vérification.
LangChain recense plusieurs schémas d'extension. Reflection loops : l'agent contrôle sa propre sortie avant de la remettre à l'utilisateur. Validation loops : une boucle distincte vérifie les résultats, par exemple en lançant des tests sur le code généré. Escalation loops : si l'agent ne parvient pas à résoudre la tâche en N étapes, il passe la main à un humain.
Chaque couche ajoute de la fiabilité, mais augmente aussi la latence. Le travail de l'ingénieur consiste à trouver l'équilibre entre rigueur et rapidité.
Les primitives de LangChain pour l'instrumentation
LangGraph permet de décrire les boucles agentiques sous forme de graphe d'états (StateGraph), où chaque nœud est une étape de la boucle et les arêtes sont les transitions entre elles. Cela offre trois avantages pratiques.
Premièrement, la transparence : chaque transition est journalisée et toute panne peut être reproduite. Deuxièmement, le contrôle : on peut ajouter des « points d'arrêt » où un humain examine la décision de l'agent avant de poursuivre. Troisièmement, la testabilité : chaque nœud se teste isolément, sans lancer l'agent entier.
LangSmith répond à la question de l'observabilité en production. Sans lui, il est difficile de savoir à quelle étape l'agent se dégrade à l'échelle.
Ce que cela signifie
L'industrie passe du « appelle GPT-4 avec des outils » à une véritable ingénierie des systèmes d'agents. Les équipes qui investissent dès maintenant dans l'architecture des boucles et l'observabilité obtiendront des agents qui fonctionnent en production, et pas seulement en démo.
- 1 nov. 2026L'agent vidéo StreamVibe de Google devance les autres modèles de 10,7 % sur le timing et la qualité des réponses
- 1 nov. 2026Un nouveau test détecte la collusion cachée entre agents IA grâce à la réaction du partenaire à une paraphrase
- 1 nov. 2026Illinois a rassemblé 12 151 problèmes ouverts pour tester si l'IA peut les résoudre
- 31 oct. 2026Un ingénieur IA écrit une seule fonction de récompense pour des équipes d'agents : le taux de victoire passe de 51% à 90%
Questions clés sur cet article
Pourquoi le modèle ne suffit pas?
La plupart des développeurs butent sur le même problème : l'agent fonctionne bien en démo, mais échoue sur des tâches réelles. Selon LangChain, le problème vient rarement du modèle lui-même. Il vient de l'absence d'un harness (harnais) bien pensé, qui entoure le modèle et contrôle le flux d'exécution. Un agent n'est pas un simple appel à un LLM avec des outils. C'est un processus itératif contrôlé : il examine l'état, choisit une action, obtient un résultat, met à jour l'état, puis recommence. La fiabilité dépend du soin apporté à la conception de cette boucle.
Que sait-on sur Anatomie de l'agent loop ?
La boucle de base comprend quatre étapes, répétées jusqu'à l'achèvement de la tâche : Observation — l'agent reçoit le contexte courant : la tâche, l'historique et les résultats des outils précédents Raisonnement — le LLM décide de la suite : appeler un outil, demander une précision ou terminer Action — un appel d'outil ou la réponse finale Mise à jour — le résultat est écrit dans l'état et la boucle se poursuit L'idée clé : chaque niveau doit disposer de ses propres outils d'observation. Sans journalisation à chaque étape, impossible de savoir où l'agent se trompe exactemen
Que sait-on sur Empiler et étendre les boucles ?
Les agents complexes utilisent des boucles imbriquées avec des horizons de décision différents. La boucle externe pilote la tâche globale : elle la découpe en sous-tâches, suit l'avancement et décide quand s'arrêter. Les boucles internes traitent des sous-tâches précises, comme la recherche, l'écriture de code et la vérification. LangChain recense plusieurs schémas d'extension. Reflection loops : l'agent contrôle sa propre sortie avant de la remettre à l'utilisateur. Validation loops : une boucle distincte vérifie les résultats, par exemple en lançant des tests sur le code
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.