Les labos d'IA paient XDOF pour collecter des données d'entraînement pour robots : un travail ingrat et routinier
Pour que les robots apprennent à se déplacer et à manipuler des objets, il faut des millions d'heures de démonstrations réelles, comme les LLM ont appris sur internet. Collecter ces données est monotone et éprouvant : des opérateurs pilotent des robots à la main pendant des heures ou se déplacent en combinaison de capture de mouvement. Les labos d'IA paient déjà des sociétés comme XDOF pour sous-traiter ce travail.
Traité par IA depuis TechCrunch ; édité par Hamidun News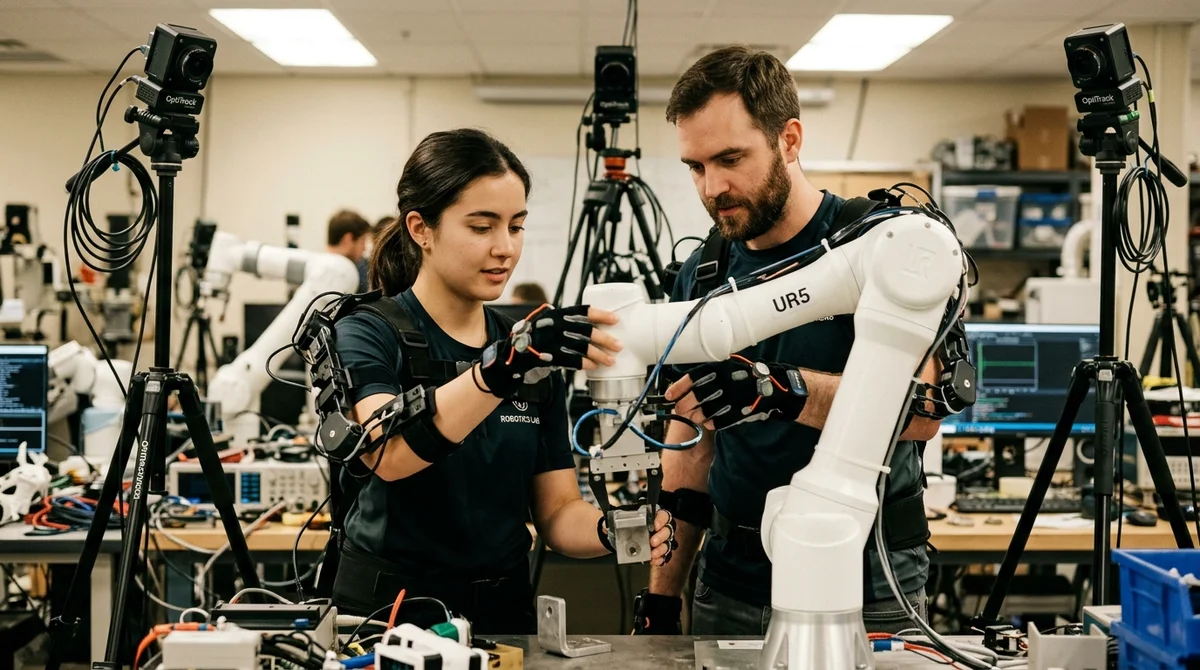
L'IA physique fait face au même problème que celui qui aurait bloqué les modèles de langage sans l'internet accumulé par l'humanité : le manque de données d'entraînement. Pour l'instant, les labos le règlent à la main, et paient de l'argent bien réel à des sociétés comme XDOF pour cela.
Pourquoi les données manquent
Les grands modèles de langage ont appris à raisonner sur des milliers de milliards de mots accumulés par l'humanité sur le web. Les robots physiques n'ont pas un tel socle. Mouvements, préhensions, équilibre, manipulation d'objets fragiles : tout doit être démontré en direct, encore et encore, dans des dizaines de scénarios différents. Une seule heure de démonstrations de qualité demande beaucoup d'efforts. L'opérateur enfile un exosquelette ou pilote le robot au joystick, en répétant le même geste des centaines de fois sous des éclairages différents, avec des objets différents, dans des postures différentes. Les données obtenues sont chères, lentes à produire et étroitement liées à l'espace physique. Internet n'y changera rien.
C'est pourquoi les équipes de pointe de l'IA physique, de Physical Intelligence aux labos de Google DeepMind en passant par les développeurs de robots humanoïdes, se heurtent au même mur : on peut améliorer les modèles autant qu'on veut, mais sans un volume suffisant de démonstrations de qualité, ils n'apprendront pas.
Ce que fait XDOF
XDOF fait partie des sociétés auxquelles les labos d'IA sous-traitent ce travail. Elle organise tout le processus : recrutement des opérateurs, configuration du matériel, contrôle de la qualité de l'annotation et montée en charge de la production selon les besoins de chaque client. Le modèle rappelle les débuts de Scale AI, qui avait embauché une armée d'annotateurs pour étiqueter textes et images. À ceci près qu'il s'agit désormais de travail physique dans un espace réel.
Une session type de collecte de données se déroule ainsi :
- L'opérateur pilote le robot à la main, et le système enregistre les trajectoires de mouvement et les données de force
- Plusieurs caméras filment la scène simultanément sous différents angles
- Chaque tentative est annotée : succès, échec, cas limite
- Le scénario est répété avec des éclairages, des objets et des postures différents
- Un contrôle final écarte les démonstrations défectueuses
Ce travail n'exige pas de diplôme d'ingénieur, mais il demande de l'attention, de la patience et de l'endurance physique. C'est précisément ce « sale boulot ingrat » contre lequel le secteur met en garde.
Qui paie et pourquoi c'est important
Le passage à l'échelle de la collecte se heurte à la physique : on ne peut pas télécharger des millions de mouvements robotiques sur le web, ni les remplacer par des données synthétiques sans risquer de dégrader le modèle. La sous-traitance permet aux labos de se concentrer sur l'architecture et l'entraînement pendant que des spécialistes s'occupent de la routine.
S'y ajoute un nouveau type de « travail caché » dans l'industrie de l'IA : invisible du grand public, mais d'une importance critique. Comme pour la modération de contenu des LLM, le marché de la collecte de démonstrations robotiques va croître rapidement, et se retrouvera tout aussi vite au cœur des débats sur les conditions de travail et les normes de qualité.
Ce que cela signifie
L'ère de l'IA physique exigera une infrastructure de collecte de données comparable à celle qu'internet a fournie aux modèles de langage. Les entreprises qui bâtiront les premières des chaînes efficaces de collecte et d'annotation de démonstrations physiques obtiendront un avantage structurel, quel que soit celui qui développe les modèles eux-mêmes.
- 1 nov. 2026Test de 16 modèles sur 7 moteurs de recherche : Exa obtient en moyenne 10,5 points sur 14, SearXNG environ 3
- 1 nov. 2026L'agent vidéo StreamVibe de Google devance les autres modèles de 10,7 % sur le timing et la qualité des réponses
- 1 nov. 2026OpenAI réécrit les règles de comportement de GPT : cinq valeurs et une chaîne de priorités
- 1 nov. 2026Les bots vocaux à base de LLM s'appuient sur le classifieur rapide Jev : une décision en 200–500 ms
Questions clés sur cet article
Pourquoi les données manquent?
Les grands modèles de langage ont appris à raisonner sur des milliers de milliards de mots accumulés par l'humanité sur le web. Les robots physiques n'ont pas un tel socle. Mouvements, préhensions, équilibre, manipulation d'objets fragiles : tout doit être démontré en direct, encore et encore, dans des dizaines de scénarios différents. Une seule heure de démonstrations de qualité demande beaucoup d'efforts. L'opérateur enfile un exosquelette ou pilote le robot au joystick, en répétant le même geste des centaines de fois sous des éclairages différents, avec des objets différ
Que sait-on sur Ce que fait XDOF ?
XDOF fait partie des sociétés auxquelles les labos d'IA sous-traitent ce travail. Elle organise tout le processus : recrutement des opérateurs, configuration du matériel, contrôle de la qualité de l'annotation et montée en charge de la production selon les besoins de chaque client. Le modèle rappelle les débuts de Scale AI, qui avait embauché une armée d'annotateurs pour étiqueter textes et images. À ceci près qu'il s'agit désormais de travail physique dans un espace réel. Une session type de collecte de données se déroule ainsi : L'opérateur pilote le robot à la main, et l
Que sait-on sur Qui paie et pourquoi c'est important ?
Le passage à l'échelle de la collecte se heurte à la physique : on ne peut pas télécharger des millions de mouvements robotiques sur le web, ni les remplacer par des données synthétiques sans risquer de dégrader le modèle. La sous-traitance permet aux labos de se concentrer sur l'architecture et l'entraînement pendant que des spécialistes s'occupent de la routine. S'y ajoute un nouveau type de « travail caché » dans l'industrie de l'IA : invisible du grand public, mais d'une importance critique. Comme pour la modération de contenu des LLM, le marché de la collecte de démons
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.