Les laboratoires d'IA paient XDOF pour collecter des données d'entraînement pour les robots — un travail sale et répétitif
Pour que les robots apprennent à se déplacer et à manipuler des objets, il faut des millions d'heures de démonstrations réelles — tout comme les LLM ont appris grâce à internet. Collecter ces données est monotone et éprouvant : des personnes passent des heures à piloter des robots manuellement ou portent des combinaisons de capture de mouvement. Les laboratoires d'IA paient déjà des entreprises comme XDOF pour externaliser ce travail.
Traité par IA depuis TechCrunch ; édité par Hamidun News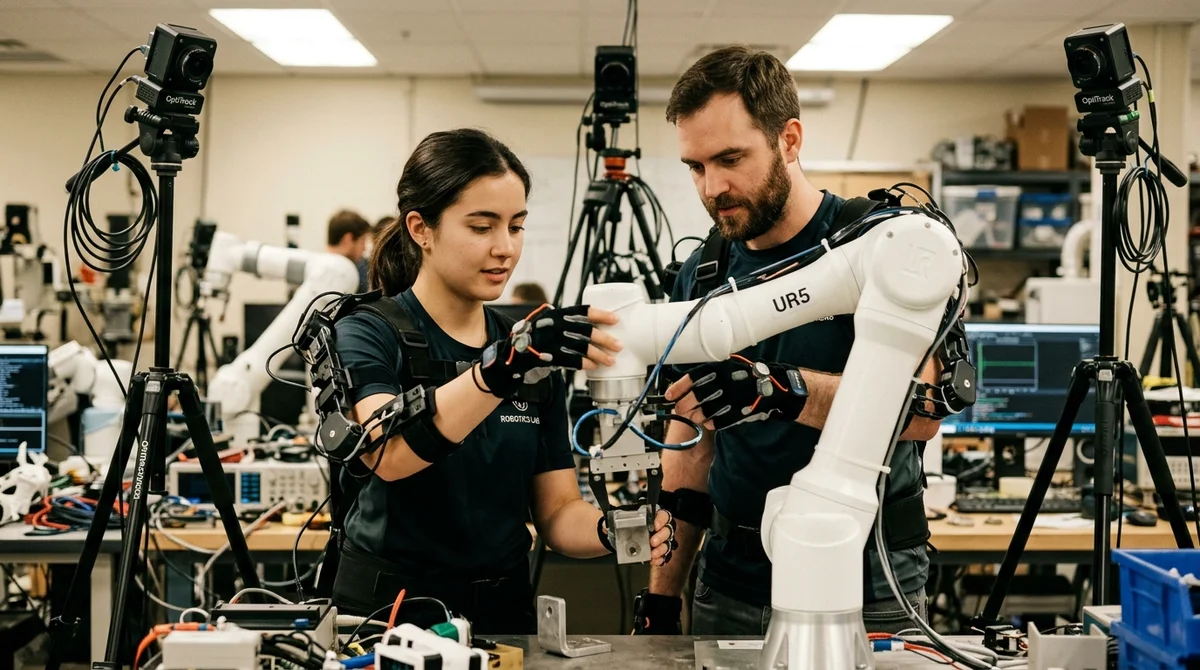
L'IA physique fait face au même problème qui aurait arrêté les modèles de langage sans l'internet accumulé par l'humanité : la pénurie de données d'entraînement. Pour l'instant, les laboratoires le résolvent manuellement — et paient de l'argent réel à des entreprises comme XDOF pour cela.
Pourquoi les données manquent
Les grands modèles de langage ont appris à penser sur des billions de mots que l'humanité a accumulés en ligne. Les robots physiques n'ont pas cette ressource : les mouvements, la préhension, l'équilibre, la manipulation d'objets fragiles — tout cela doit être démontré en direct, encore et encore, dans des dizaines de scénarios différents. Une heure de démonstrations de qualité demande un effort considérable : un opérateur enfile un exosquelette ou contrôle un robot via une manette, effectuant le même mouvement des centaines de fois sous différents éclairages, avec différents objets, dans différentes poses.
Les données deviennent coûteuses, lentes et étroitement liées à l'espace physique. Internet ne peut pas aider ici. C'est pourquoi les équipes leaders en IA physique — de Physical Intelligence aux laboratoires au sein de Google DeepMind et aux développeurs de robots humanoïdes — se sont heurtées à un mur : les modèles peuvent être améliorés indéfiniment, mais sans un volume suffisant de démonstrations de qualité, ils n'apprendront pas.
Ce que fait XDOF
XDOF est l'une des entreprises que les laboratoires d'IA engagent pour externaliser ce travail. Ils organisent l'ensemble du processus : recrutent des opérateurs, configurent l'équipement, supervisent la qualité de l'annotation et adaptent la production aux besoins de clients spécifiques. Le modèle ressemble aux premiers jours de Scale AI, qui a embauché une armée d'annotateurs pour marquer du texte et des images. Sauf qu'il s'agit maintenant de travail physique dans un espace réel.
Une session typique de collecte de données ressemble à ceci :
- Un opérateur contrôle le robot manuellement — le système capture les trajectoires de mouvement et les données de force
- Plusieurs caméras capturent simultanément la scène sous différents angles
- Chaque tentative est marquée : succès, échec, cas limite
- Le scénario est répété sous différents éclairages, avec différents objets et dans différentes poses
- Vérification finale élimine les démonstrations défectueuses
Ce travail ne nécessite pas une formation en ingénierie, mais il nécessite de l'attention, de la patience et de l'endurance physique — c'est exactement ce "travail sordide et désagréable" dont l'industrie avertit.
Qui paie et pourquoi c'est important
L'augmentation de la collecte de données se heurte à la physique : on ne peut pas télécharger des millions de mouvements robotiques du réseau, on ne peut pas les remplacer par des données synthétiques sans risquer la dégradation du modèle. L'externalisation permet aux laboratoires de se concentrer sur l'architecture et l'entraînement tandis que les spécialistes s'occupent de la routine. Avec cela, un nouveau type de « travail caché » émerge dans l'industrie de l'IA — invisible au grand public mais critiquement important.
Par analogie avec la modération de contenu pour les LLM, le marché de la collecte de démonstrations robotiques croîtra rapidement — et deviendra rapidement le centre de discussions sur les conditions de travail et les normes de qualité.
Ce que cela signifie
L'ère de l'IA physique exigera la même infrastructure de collecte de données qu'Internet a créée pour les modèles de langage. Les entreprises qui construiront en premier des pipelines efficaces pour collecter et annoter les démonstrations physiques acquerront un avantage structurel — indépendamment de qui développe les modèles eux-mêmes.
- 25 oct. 2026Nvidia négocie le rachat de Reflection AI ou un nouvel investissement dans la start-up
- 24 oct. 2026Google ouvre TorchTPU : PyTorch traite désormais le TPU comme un périphérique natif
- 24 oct. 2026Harvey LAB-AA v1.1 : Grok 4.7 en tête avec 9,4 % après filtrage des hallucinations
- 24 oct. 2026Meta lance Muse Wonder et Muse Wonder Full : l'indice d'intelligence passe de 48 à 56
Questions clés sur cet article
Pourquoi les données manquent?
Les grands modèles de langage ont appris à penser sur des billions de mots que l'humanité a accumulés en ligne. Les robots physiques n'ont pas cette ressource : les mouvements, la préhension, l'équilibre, la manipulation d'objets fragiles — tout cela doit être démontré en direct, encore et encore, dans des dizaines de scénarios différents. Une heure de démonstrations de qualité demande un effort considérable : un opérateur enfile un exosquelette ou contrôle un robot via une manette, effectuant le même mouvement des centaines de fois sous différents éclairages, avec différen
Que sait-on sur Ce que fait XDOF ?
XDOF est l'une des entreprises que les laboratoires d'IA engagent pour externaliser ce travail. Ils organisent l'ensemble du processus : recrutent des opérateurs, configurent l'équipement, supervisent la qualité de l'annotation et adaptent la production aux besoins de clients spécifiques. Le modèle ressemble aux premiers jours de Scale AI, qui a embauché une armée d'annotateurs pour marquer du texte et des images. Sauf qu'il s'agit maintenant de travail physique dans un espace réel. Une session typique de collecte de données ressemble à ceci : Un opérateur contrôle le robot
Que sait-on sur Qui paie et pourquoi c'est important ?
L'augmentation de la collecte de données se heurte à la physique : on ne peut pas télécharger des millions de mouvements robotiques du réseau, on ne peut pas les remplacer par des données synthétiques sans risquer la dégradation du modèle. L'externalisation permet aux laboratoires de se concentrer sur l'architecture et l'entraînement tandis que les spécialistes s'occupent de la routine. Avec cela, un nouveau type de « travail caché » émerge dans l'industrie de l'IA — invisible au grand public mais critiquement important. Par analogie avec la modération de contenu pour les L
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.