L'infrastructure avant le modèle : comment les entreprises repensent leur approche de l'IA
PSM a développé son propre agent IA et s'est heurtée à un plafond matériel. Plutôt que de choisir d'abord un modèle, l'entreprise a préparé l'infrastructure. De là est née l'idée d'un module AI ready : une base prête à l'emploi qui permet de déployer l'IA sans refaire les serveurs. La leçon centrale est simple : l'infrastructure d'abord, le modèle ensuite.
Traité par IA depuis Habr AI ; édité par Hamidun News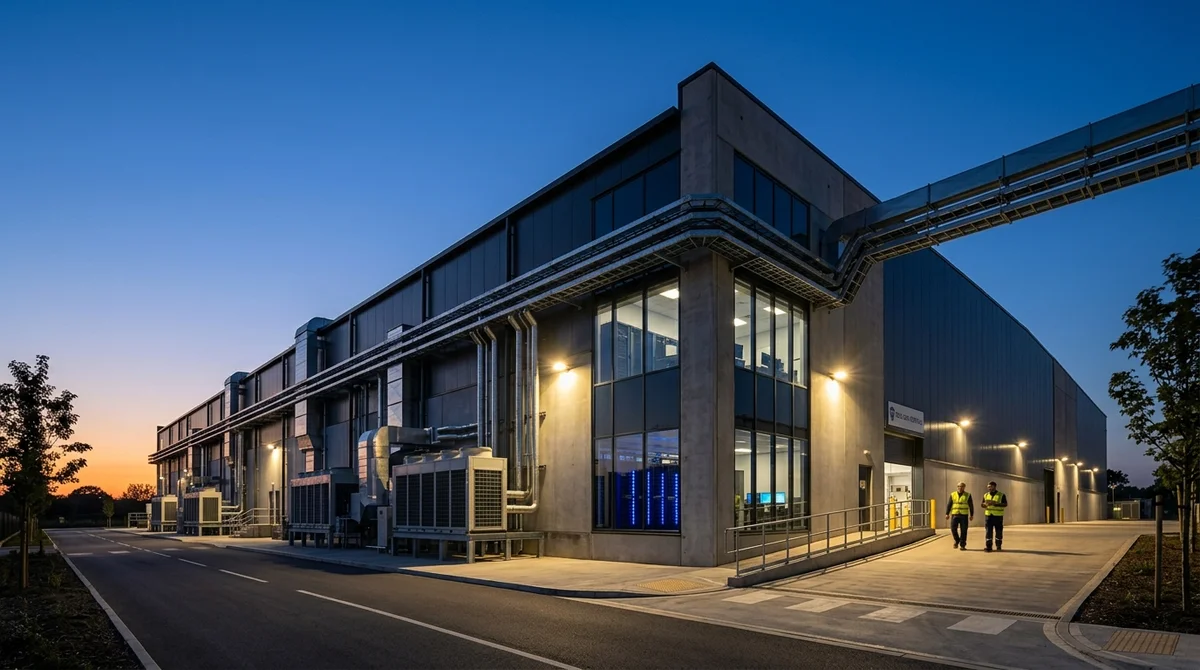
Les entreprises veulent leur propre IA. Tout le monde demande quel modèle choisir. Mais personne ne se demande sur quoi ce modèle va tourner. PSM Unlimited a vécu ce problème de plein fouet. L'équipe a développé un agent IA d'entreprise, formé ses collaborateurs et était prête à passer à l'échelle, mais s'est heurtée à un mur de limites matérielles. La solution est née d'une erreur : il faut d'abord l'infrastructure, ensuite le modèle.
Pourquoi le modèle ne fait que la moitié du travail
Quand on parle d'IA en entreprise, tout le monde discute d'algorithmes, de réseaux de neurones et de qualité des modèles. C'est naturel : le modèle est visible, on écrit des articles à son sujet et on peut le présenter en démonstration. Mais l'IA ne vit pas dans le cloud sous la forme d'un ensemble abstrait de poids et de paramètres. Elle vit sur des serveurs, et ces serveurs doivent être les bons.
En pratique, cela donne ceci : vous déployez un agent et il fonctionne sur un jeu de test. Vous commencez à monter en charge et vous butez sur les limites. Pas assez de GPU. La mémoire est saturée. Le réseau ne suit pas. Les processeurs chauffent. Il faut refaire l'infrastructure, puis ajuster à nouveau le modèle aux nouvelles conditions.
Qu'est-ce qu'un module AI ready
AI ready signifie que l'infrastructure est préparée à l'avance, avant que vous ayez choisi le modèle à exécuter. Les fondations sont posées et l'on peut construire dessus. Cela comprend :
- Calcul — des clusters GPU/TPU d'une puissance suffisante pour le traitement parallèle
- Mémoire — VRAM des GPU et RAM des serveurs sans goulots d'étranglement
- Stockage — des SSD rapides pour les modèles, les journaux et le cache (pas de HDD)
- Réseau — faible latence entre les nœuds, bande passante élevée
- Refroidissement et alimentation — prêts pour des charges 24h/24 et 7j/7
Ce n'est pas un modèle précis, ni TensorFlow ou PyTorch. C'est la maison physique dans laquelle n'importe quelle IA peut vivre sans remaniement.
Ce que cela apporte à l'entreprise
Premièrement, la rapidité. Pas de mois perdus à refaire les serveurs. Pas d'attente de livraison de GPU. On prend une base prête et on lance le modèle demain.
Deuxièmement, la scalabilité. Quand de nouvelles exigences arrivent (plus d'utilisateurs, un modèle plus lourd), l'infrastructure y est déjà préparée. Aucune refonte d'architecture n'est nécessaire ; il suffit de modifier une configuration.
Troisièmement, les coûts. Une infrastructure adaptée économise de l'électricité (refroidissement et alimentation efficaces), des ressources coûteuses (pas de surachat de matériel) et du temps d'ingénieur (pas de lutte contre les goulots d'étranglement).
Ce que cela signifie
L'IA n'est pas de la magie dans le cloud. C'est du silicium, du plastique et de l'électricité. Choisir un modèle est plus facile que préparer l'infrastructure. C'est pourquoi l'entreprise qui commence par l'infrastructure plutôt que par le modèle devance ses concurrents, qui ne découvrent les problèmes matériels qu'une fois le code écrit.
- 1 nov. 2026Les modèles locaux battus par Opus et Codex : 0,21 sur MacBook contre 1,00 pour Codex
- 1 nov. 2026Le juge d'EditAgent (Adobe) retient une retouche valable dans 81,3% des cas, contre 74,8% pour EditScore
- 1 nov. 2026Test de 16 modèles sur 7 moteurs de recherche : Exa obtient en moyenne 10,5 points sur 14, SearXNG environ 3
- 1 nov. 2026L'agent vidéo StreamVibe de Google devance les autres modèles de 10,7 % sur le timing et la qualité des réponses
Questions clés sur cet article
Pourquoi le modèle ne fait que la moitié du travail?
Quand on parle d'IA en entreprise, tout le monde discute d'algorithmes, de réseaux de neurones et de qualité des modèles. C'est naturel : le modèle est visible, on écrit des articles à son sujet et on peut le présenter en démonstration. Mais l'IA ne vit pas dans le cloud sous la forme d'un ensemble abstrait de poids et de paramètres. Elle vit sur des serveurs, et ces serveurs doivent être les bons. En pratique, cela donne ceci : vous déployez un agent et il fonctionne sur un jeu de test. Vous commencez à monter en charge et vous butez sur les limites. Pas assez de GPU. La m
Qu'est-ce qu'un module AI ready?
AI ready signifie que l'infrastructure est préparée à l'avance, avant que vous ayez choisi le modèle à exécuter. Les fondations sont posées et l'on peut construire dessus. Cela comprend : Calcul — des clusters GPU/TPU d'une puissance suffisante pour le traitement parallèle Mémoire — VRAM des GPU et RAM des serveurs sans goulots d'étranglement Stockage — des SSD rapides pour les modèles, les journaux et le cache (pas de HDD) Réseau — faible latence entre les nœuds, bande passante élevée Refroidissement et alimentation — prêts pour des charges 24h/24 et 7j/7 Ce n'est pas un m
Que sait-on sur Ce que cela apporte à l'entreprise ?
Premièrement, la rapidité. Pas de mois perdus à refaire les serveurs. Pas d'attente de livraison de GPU. On prend une base prête et on lance le modèle demain. Deuxièmement, la scalabilité. Quand de nouvelles exigences arrivent (plus d'utilisateurs, un modèle plus lourd), l'infrastructure y est déjà préparée. Aucune refonte d'architecture n'est nécessaire ; il suffit de modifier une configuration. Troisièmement, les coûts. Une infrastructure adaptée économise de l'électricité (refroidissement et alimentation efficaces), des ressources coûteuses (pas de surachat de matériel)
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.