Un labo d'IA à la maison pour 200 000 roubles
Il y a cinq ans, une Tesla V100 coûtait 8 000 dollars. Aujourd'hui, elle se vend 1 500. Cela a bouleversé l'économie des GPU dans le cloud : acheter son propre matériel revient désormais moins cher que payer un mois chez un fournisseur. Nous passons en revue les modèles qui tiennent sur la V100, les points faibles de la carte et la rentabilité d'un investissement de 200 000 roubles.
Traité par IA depuis Habr AI ; édité par Hamidun News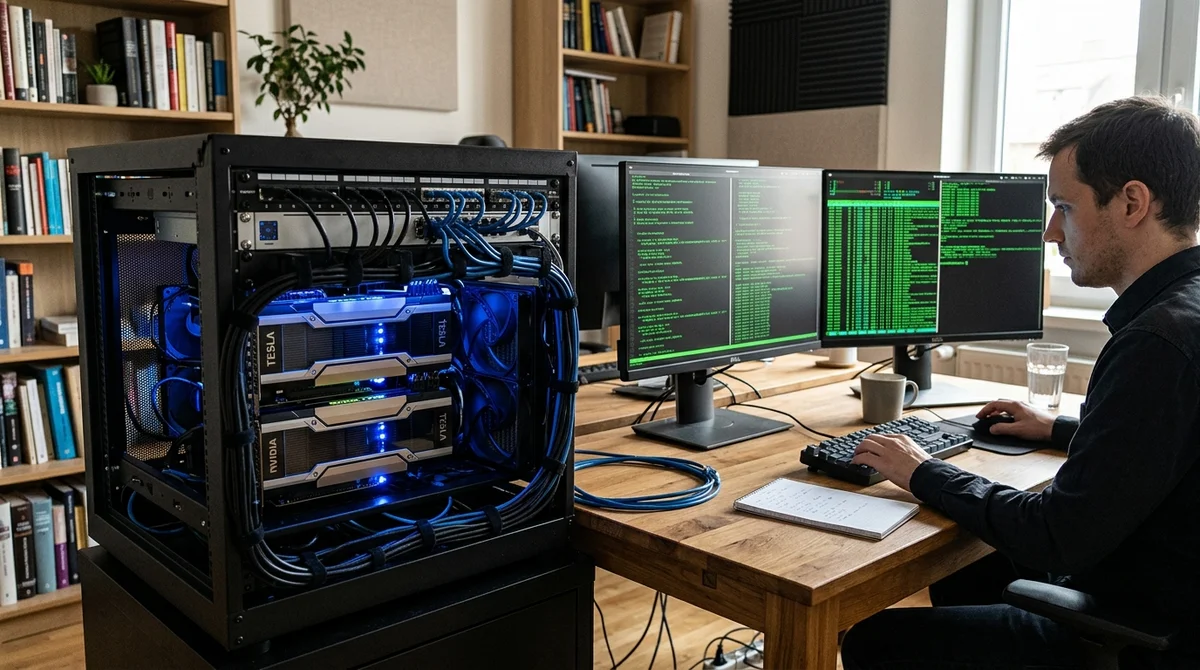
La Tesla V100 coûtait 8 000 dollars en 2017. Aujourd'hui, elle se vend 1 500 sur le marché de l'occasion. Ce chiffre a fait voler en éclats l'économie des GPU dans le cloud. Chez Amazon ou Vast.ai, la location d'une V100 revient à 0,40-0,80 dollar de l'heure, soit 300-600 par mois. Achetez deux V100, montez un serveur pour 200 000 roubles : il sera amorti en six mois. L'auteur du test a acheté exactement cela et testé 128 réseaux de neurones différents, des petits LLM aux générateurs vidéo. Voici ce que cela donne.
Pourquoi la V100 est-elle si peu chère ?
La Tesla V100 est une carte professionnelle pour data centers, sortie en 2017. Elle embarque 32 Go de mémoire, 235 TFLOPS en demi-précision et un TDP de 125 W. Produite en quantités énormes, elle a ensuite été supplantée par la A100. Les fermes de cloud ont bradé leurs anciennes V100. Des mineurs indépendants et des startups ont raflé le reste. Le marché de l'occasion est désormais saturé de ces cartes, et les prix ont encore baissé. La puce est dépassée en puissance brute, mais elle est idéale pour l'inférence.
Où la V100 trébuche-t-elle ?
Soyons honnêtes : la V100 peine sous TensorFlow (son optimisation des calculs limités par le CPU est faible). La génération vidéo prend cinq minutes avec Flux.1, et l'attente serait insupportable. Elle génère du texte correctement, mais pas vite : Llama 2 70B produit 80 tokens par seconde en int4. À titre de comparaison, une A100 dans le cloud en fournit plus de 300. La mémoire pose aussi des limites : 32 Go suffisent pour la plupart des modèles, mais il est impossible de lancer deux modèles de 70 milliards de paramètres en même temps.
Benchmarks réels
- Mistral 7B : 200 tokens/s (int4)
- Llama 2 70B : 80 tokens/s (int4)
- Stable Diffusion 1.5 : 0,8 seconde par image
- Stable Diffusion XL : 2,5 secondes
- Whisper Large : 0,3 du temps réel (un audio de 60 minutes en 18 minutes)
- Flux.1 : 300 secondes en 1024×1024
Économie : cloud ou machine locale ?
Les GPU dans le cloud (Lambda, Vast.ai) coûtent 0,40-0,80 $/heure pour une V100. La location mensuelle revient à 300-600 dollars. Notre serveur est amorti en 4-6 mois d'utilisation. Avantages du local : l'électricité coûte moins cher que le trafic vers le cloud, le contrôle est total et il n'y a aucune latence. Inconvénients : la responsabilité du matériel, du refroidissement et des mises à niveau repose entièrement sur vous.
Ce que cela signifie
Un serveur d'IA local ne remplace pas le cloud : il le complète. Si vous lancez des modèles tous les jours, avez déjà testé votre idée et savez de quels réseaux de neurones vous avez besoin, un serveur à 200 000 roubles fait économiser des dizaines de milliers par an et donne un contrôle total sur votre infrastructure.
- 1 nov. 2026La couche de protection MoneyGate n'a laissé passer aucune des 42 demandes frauduleuses adressées à des IA locales
- 31 oct. 2026La passerelle LLM open source KTMS 1.0 branche ses propres GPU au cloud et résiste aux pannes
- 31 oct. 2026LTX-2.5, 22 milliards de paramètres, tourne sur une RTX 3080 de 10 Go, mais met 5 minutes par plan
- 29 oct. 2026T-Tech met au point LIMe, une méthode qui réduit de 15% le coût de calcul de l'entraînement d'un modèle de langage
Questions clés sur cet article
Pourquoi la V100 est-elle si peu chère ?
La Tesla V100 est une carte professionnelle pour data centers, sortie en 2017. Elle embarque 32 Go de mémoire, 235 TFLOPS en demi-précision et un TDP de 125 W. Produite en quantités énormes, elle a ensuite été supplantée par la A100. Les fermes de cloud ont bradé leurs anciennes V100. Des mineurs indépendants et des startups ont raflé le reste. Le marché de l'occasion est désormais saturé de ces cartes, et les prix ont encore baissé. La puce est dépassée en puissance brute, mais elle est idéale pour l'inférence.
Où la V100 trébuche-t-elle ?
Soyons honnêtes : la V100 peine sous TensorFlow (son optimisation des calculs limités par le CPU est faible). La génération vidéo prend cinq minutes avec Flux.1, et l'attente serait insupportable. Elle génère du texte correctement, mais pas vite : Llama 2 70B produit 80 tokens par seconde en int4. À titre de comparaison, une A100 dans le cloud en fournit plus de 300. La mémoire pose aussi des limites : 32 Go suffisent pour la plupart des modèles, mais il est impossible de lancer deux modèles de 70 milliards de paramètres en même temps.
Économie : cloud ou machine locale ?
Les GPU dans le cloud (Lambda, Vast.ai) coûtent 0,40-0,80 $/heure pour une V100. La location mensuelle revient à 300-600 dollars. Notre serveur est amorti en 4-6 mois d'utilisation. Avantages du local : l'électricité coûte moins cher que le trafic vers le cloud, le contrôle est total et il n'y a aucune latence. Inconvénients : la responsabilité du matériel, du refroidissement et des mises à niveau repose entièrement sur vous.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.