Comment un LLM choisit ses tokens : logits, température et top-p
Un réseau de neurones choisit le mot suivant via les logits et softmax. La température pilote le hasard : basse, elle donne des réponses précises ; haute, des réponses créatives. Le top-p écarte les options peu probables. Le réglage de ces paramètres détermine la qualité du texte généré.
Traité par IA depuis Machine Learning Mastery ; édité par Hamidun News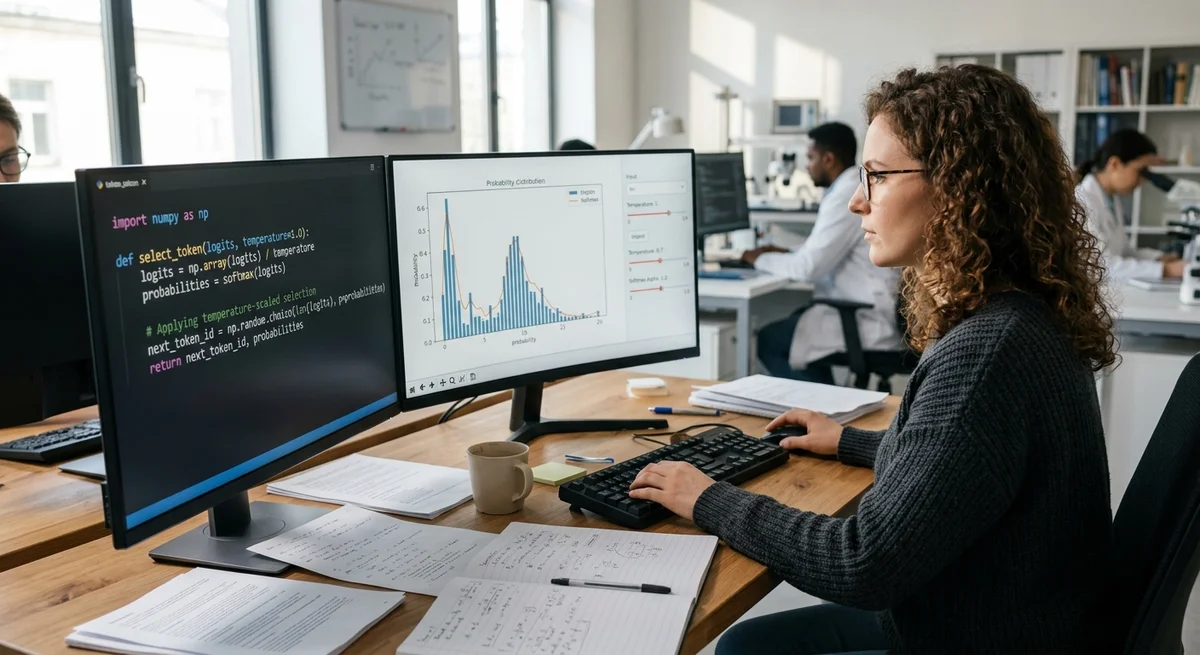
Lorsqu'un modèle de langage génère du texte, il doit résoudre une tâche fondamentale : choisir le mot suivant parmi des milliers de candidats. Ce choix n'est pas aléatoire, il est piloté par des mécanismes probabilistes. Comprendre les logits, la température et le top-p est la clé pour maîtriser le comportement d'un LLM.
Que sont les logits et softmax
Pour chaque token possible, le réseau calcule un score numérique appelé logit. C'est le signal brut issu de la dernière couche du réseau. Le mot « créativité » peut recevoir un logit de 5.2, et « téléphone » de 2.1. La fonction softmax transforme ces nombres en probabilités (de 0 à 1) dont la somme vaut 1.
Imaginez que le modèle traite « l'apprentissage automatique est ». Il calcule les logits de tous les mots de son vocabulaire. Après softmax, la distribution ressemble à ceci : « science » = 35 %, « art » = 8 %, « pingouin » = 0.001 %. Le modèle tire au hasard dans cette distribution : il choisit plus souvent les options probables et rarement les improbables.
La température : le variateur de comportement
La température est un multiplicateur appliqué aux logits avant softmax. Les maths sont simples, mais l'effet est puissant :
- T < 1 (par exemple 0.3) place le modèle du côté « glacé ». La distribution se resserre et les options improbables reçoivent des probabilités négligeables. Le modèle choisit de façon quasi déterministe, et les réponses sont prévisibles et précises. Idéal pour le code, les faits et les instructions.
- T = 1 est le comportement standard : les logits sont utilisés tels quels.
- T > 1 (par exemple 1.5–2.0) place le modèle du côté « brûlant ». La distribution s'aplatit et les options improbables ont une chance. Le modèle choisit de façon plus aléatoire. Idéal pour l'écriture créative, mais avec un risque d'erreurs ou d'hallucinations.
Une température élevée rend le modèle aventureux ; une température basse le rend conservateur.
Le top-p : un échantillonnage intelligent
Le top-p (nucleus sampling) répond à un problème : comment empêcher le modèle de dire n'importe quoi tout en lui laissant de la liberté ? L'algorithme trie les tokens par probabilité et retient les premiers jusqu'à ce que leur probabilité cumulée atteigne p (généralement 0.9).
Exemple : si top-p = 0.9 et que la distribution est la suivante :
- « science » = 40 %
- « chemin » = 30 %
- « savoir » = 15 %
- « liberté » = 10 %
- « ping ouin » = 5 %
Le modèle retiendra les quatre premières options (40+30+15+10=95 %) et écartera « pingouin ». Le top-p est dynamique : dans un contexte, il peut retenir 5 options, dans un autre 200.
Ce que cela signifie
Ces trois paramètres n'ont rien de magique : ce sont des outils de contrôle. Le développeur choisit la température et le top-p selon la tâche : la génération de code exige une température basse (la fiabilité prime sur la créativité), tandis que l'écriture d'une nouvelle exige une température haute (la variété). Comprendre ces mécanismes fait passer le travail avec un LLM de la boîte noire à un problème d'ingénierie.
Questions clés sur cet article
Que sait-on sur Que sont les logits et softmax ?
Pour chaque token possible, le réseau calcule un score numérique appelé logit. C'est le signal brut issu de la dernière couche du réseau. Le mot « créativité » peut recevoir un logit de 5.2, et « téléphone » de 2.1. La fonction softmax transforme ces nombres en probabilités (de 0 à 1) dont la somme vaut 1. Imaginez que le modèle traite « l'apprentissage automatique est ». Il calcule les logits de tous les mots de son vocabulaire. Après softmax, la distribution ressemble à ceci : « science » = 35 %, « art » = 8 %, « pingouin » = 0.001 %. Le modèle tire au hasard dans cette d
Que sait-on sur La température : le variateur de comportement ?
La température est un multiplicateur appliqué aux logits avant softmax. Les maths sont simples, mais l'effet est puissant : T < 1 (par exemple 0.3) place le modèle du côté « glacé ». La distribution se resserre et les options improbables reçoivent des probabilités négligeables. Le modèle choisit de façon quasi déterministe, et les réponses sont prévisibles et précises. Idéal pour le code, les faits et les instructions. T = 1 est le comportement standard : les logits sont utilisés tels quels. T > 1 (par exemple 1.5–2.0) place le modèle du côté « brûlant ». La distribution s'
Que sait-on sur Le top-p : un échantillonnage intelligent ?
Le top-p (nucleus sampling) répond à un problème : comment empêcher le modèle de dire n'importe quoi tout en lui laissant de la liberté ? L'algorithme trie les tokens par probabilité et retient les premiers jusqu'à ce que leur probabilité cumulée atteigne p (généralement 0.9). Exemple : si top-p = 0.9 et que la distribution est la suivante : « science » = 40 % « chemin » = 30 % « savoir » = 15 % « liberté » = 10 % « ping ouin » = 5 % Le modèle retiendra les quatre premières options (40+30+15+10=95 %) et écartera « pingouin ». Le top-p est dynamique : dans un contexte, il pe
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.