LLM locales
Los LLM locales son modelos de lenguaje que se ejecutan directamente en tu propio hardware — un portátil, un PC con GPU o un servidor casero — sin nube, sin suscripciones y sin que los datos salgan de tu máquina. Ollama, llama.cpp y LM Studio, junto con las versiones GGUF cuantizadas de Llama, Qwen y Gemma, lo hacen posible incluso en una tarjeta gráfica de hace una década. Aquí está toda nuestra cobertura sobre ejecutar IA en local: guías, pruebas de hardware, cuantización y privacidad.
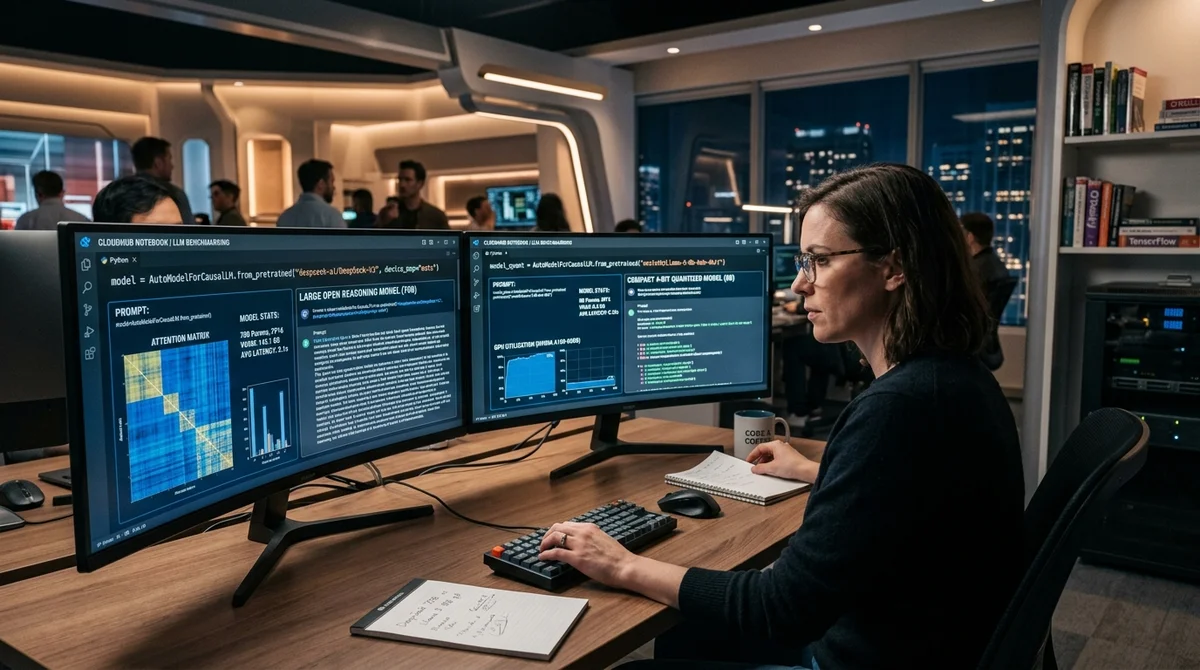
Qwen3.5: Ejecutar Modelos de Reasoning en Formato GGUF y 4-bits a través de Colab
Microsoft GraphRAG y Ollama: cómo se desempeñó el RAG basado en grafos en modelos locales
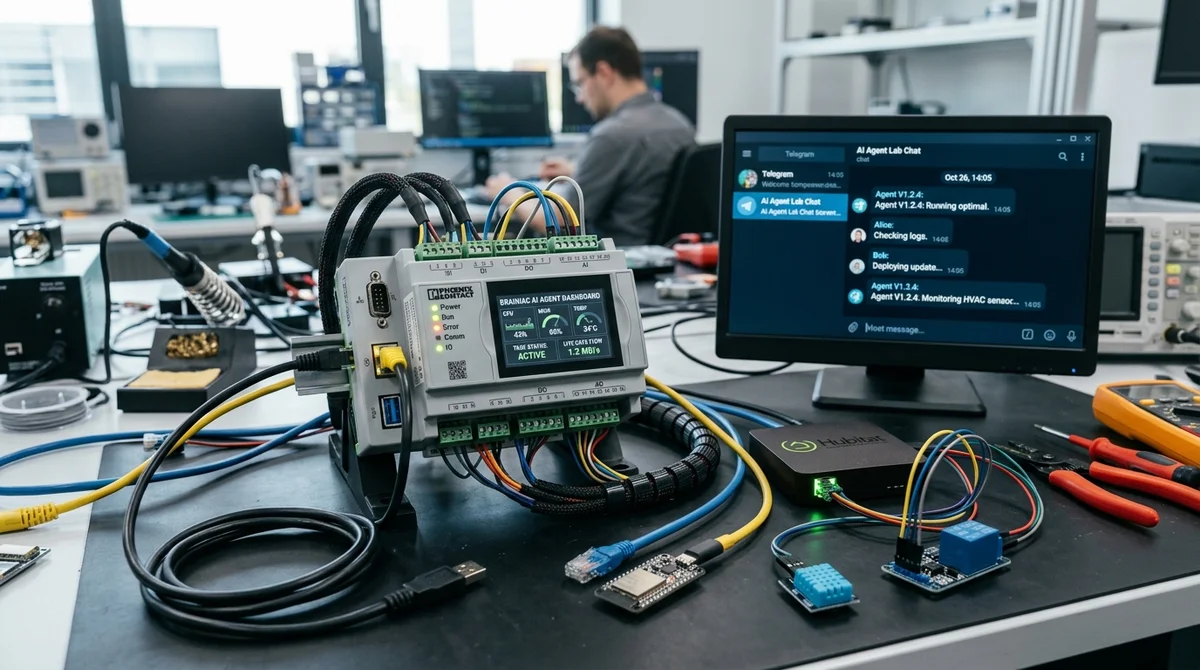
OpenClaw implementado en Wiren Board: cómo un agente de IA controla el controlador y escribe scripts
Cursor lanza SDK TypeScript para coding-agents con sandboxes en nube y facturación por tokens
Cursor abrió la versión beta pública de su SDK TypeScript: ahora los desarrolladores pueden ejecutar coding-agents localmente, en la nube o en sus propios…
Autor de Habr AI Propone IA Determinística en MacBook Air en Lugar de Carrera de GPU
Un manifiesto contra la carrera de GPU apareció en Habr: el autor argumenta que un kernel de IA determinístico en Rust con lógica O(1) puede ejecutarse localmente…
Lansoft nombra las tecnologías de IA que llegarán a producción en 2026
En el análisis de Lansoft, los transformadores optimizados se nombran como los principales candidatos para producción en 2026, mientras que el ML cuántico y los BCI…
Google Gemma 4 y Qwen 3.6 encabezan la lista de los mejores modelos locales para uso doméstico en 2026
Google mostró TurboQuant: caché KV de 3 bits para LLM, pero el mercado de memoria entró en pánico prematuramente
Canonical hace la IA en Ubuntu opcional: apuesta por modelos locales y control del usuario
Whisper y Faster-Whisper: cómo transcribir audio localmente sin enviar archivos a la nube
Nvidia lanzó Nemotron 3 Nano Omni — un modelo multimodal abierto para agentes de borde
Nvidia presentó Nemotron 3 Nano Omni — un modelo multimodal abierto con 30 mil millones de parámetros y 3 mil millones activos durante la inferencia, diseñado para…
Anthropic y OpenClaude: por qué el 'gratuito' Claude Code en 2026 no es tan gratuito
Después de la filtración del código fuente de Claude Code, la comunidad rápidamente ensambló OpenClaude, pero tras la promesa de codificación AI gratuita se…
M2 delegó el 40% de sus textos de marketing a una red neuronal y mantuvo la calidad del contenido
Habr AI muestra cómo agregar memoria y contexto a un chat LLM en Python con Ollama y LiteLLM
Google Gemma 4, NVIDIA y OpenClaw: Agentes AI locales sin pago por token
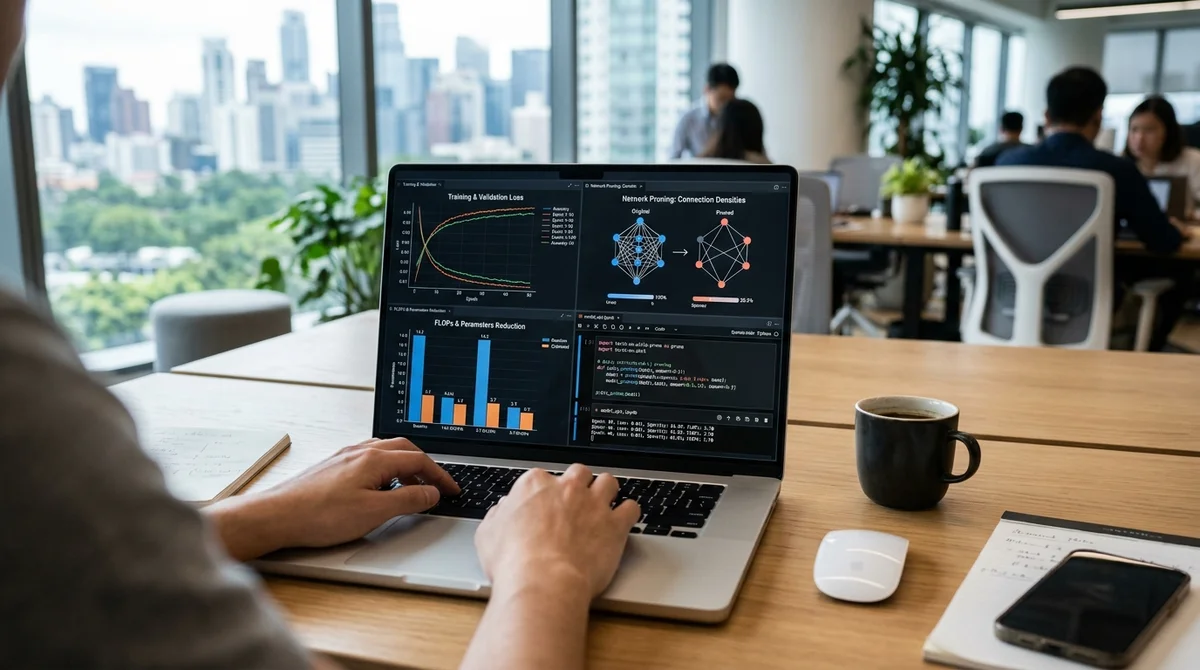
NVIDIA mostró un pipeline completo de optimización de modelos con FastNAS pruning y fine-tuning
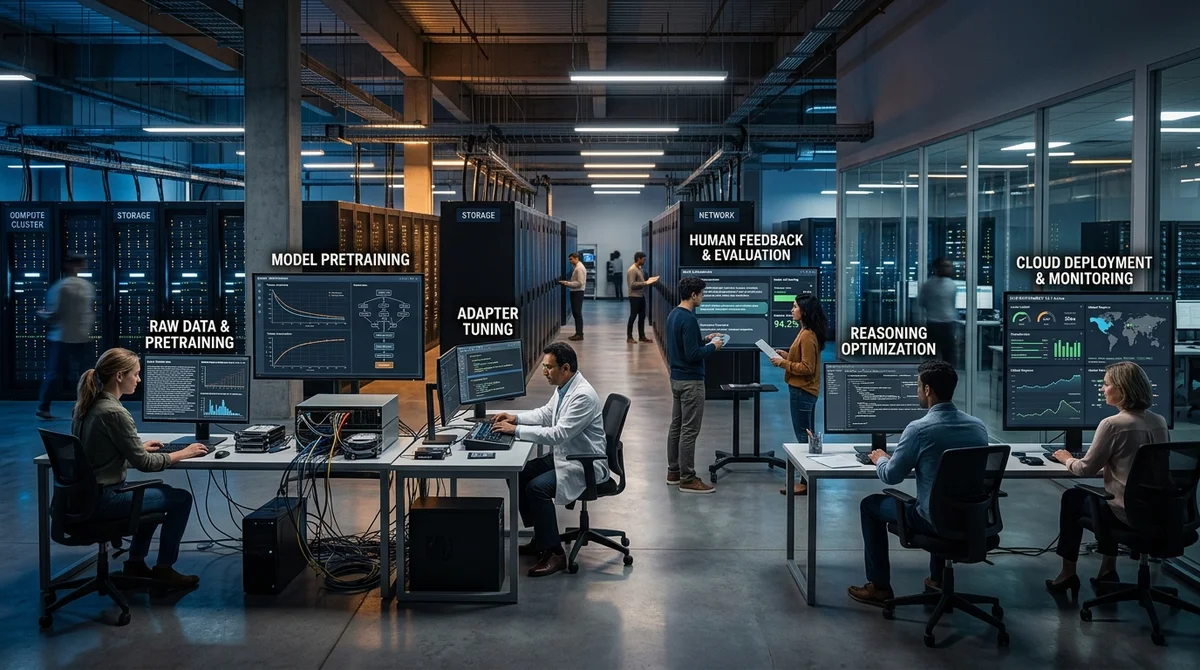
MarkTechPost desglosó el ciclo completo de entrenamiento de grandes modelos de lenguaje: desde datos hasta despliegue
MarkTechPost publicó un desglose detallado de cómo se construyen los LLMs hoy: desde el preentrenamiento en grandes corpus hasta SFT, RLHF, optimización del…
Positive Technologies enumeró los mejores benchmarks para evaluar LLM en ciberseguridad
Positive Technologies dividió los benchmarks de ciberseguridad para LLM en pruebas de conocimiento y evaluaciones prácticas, demostrando que los modelos ya superan…